
TRL documentation
TRL - Aprendizaje por refuerzo para Transformers

TRL - Aprendizaje por refuerzo para Transformers
TRL es una biblioteca de pila completa en la que proporcionamos un conjunto de herramientas para entrenar modelos de lenguaje transformers con métodos como Supervised Fine-Tuning (SFT), Group Relative Policy Optimization (GRPO), Direct Preference Optimization (DPO), Reward Modeling, entre otros. La biblioteca está integrada con 🤗 transformers.
🎉 Novedades
⚡ AsyncGRPOTrainer ya es estable: AsyncGRPOTrainer pasa a la API estable. Ejecuta GRPO mucho más rápido al desacoplar la generación del entrenamiento: un servidor vLLM transmite los rollouts mientras el trainer actualiza el modelo.
Taxonomía
A continuación se presenta un resumen de los entrenadores de TRL, organizados por madurez y tipo de método.
Experimental
También puedes explorar modelos, conjuntos de datos y demostraciones relacionados con TRL en la organización de Hugging Face de TRL.
Aprender
Aprende sobre el entrenamiento posterior con TRL y otras bibliotecas en el 🤗 smol course.
Contenido
La documentación se organiza en las siguientes secciones:
- Introducción: guía de instalación y primeros pasos.
- Guías conceptuales: formatos de conjuntos de datos, preguntas frecuentes sobre entrenamiento y comprensión de registros.
- Guías de uso: reducir el uso de memoria, acelerar el entrenamiento, distribuir el entrenamiento, etc.
- Integraciones: DeepSpeed, PEFT, etc.
- Ejemplos: resumen de ejemplos, tutoriales de la comunidad, etc.
- API: entrenadores, utilidades, etc.
Publicaciones del blog
Publicado el 27 de mayo de 2026
Enviando un billón de parámetros con un cubo del Hub: sincronización de pesos delta en TRL

Publicado el 31 de marzo de 2026
TRL v1: Biblioteca de pos-entrenamiento que resiste cuando el campo invalida sus propias suposiciones
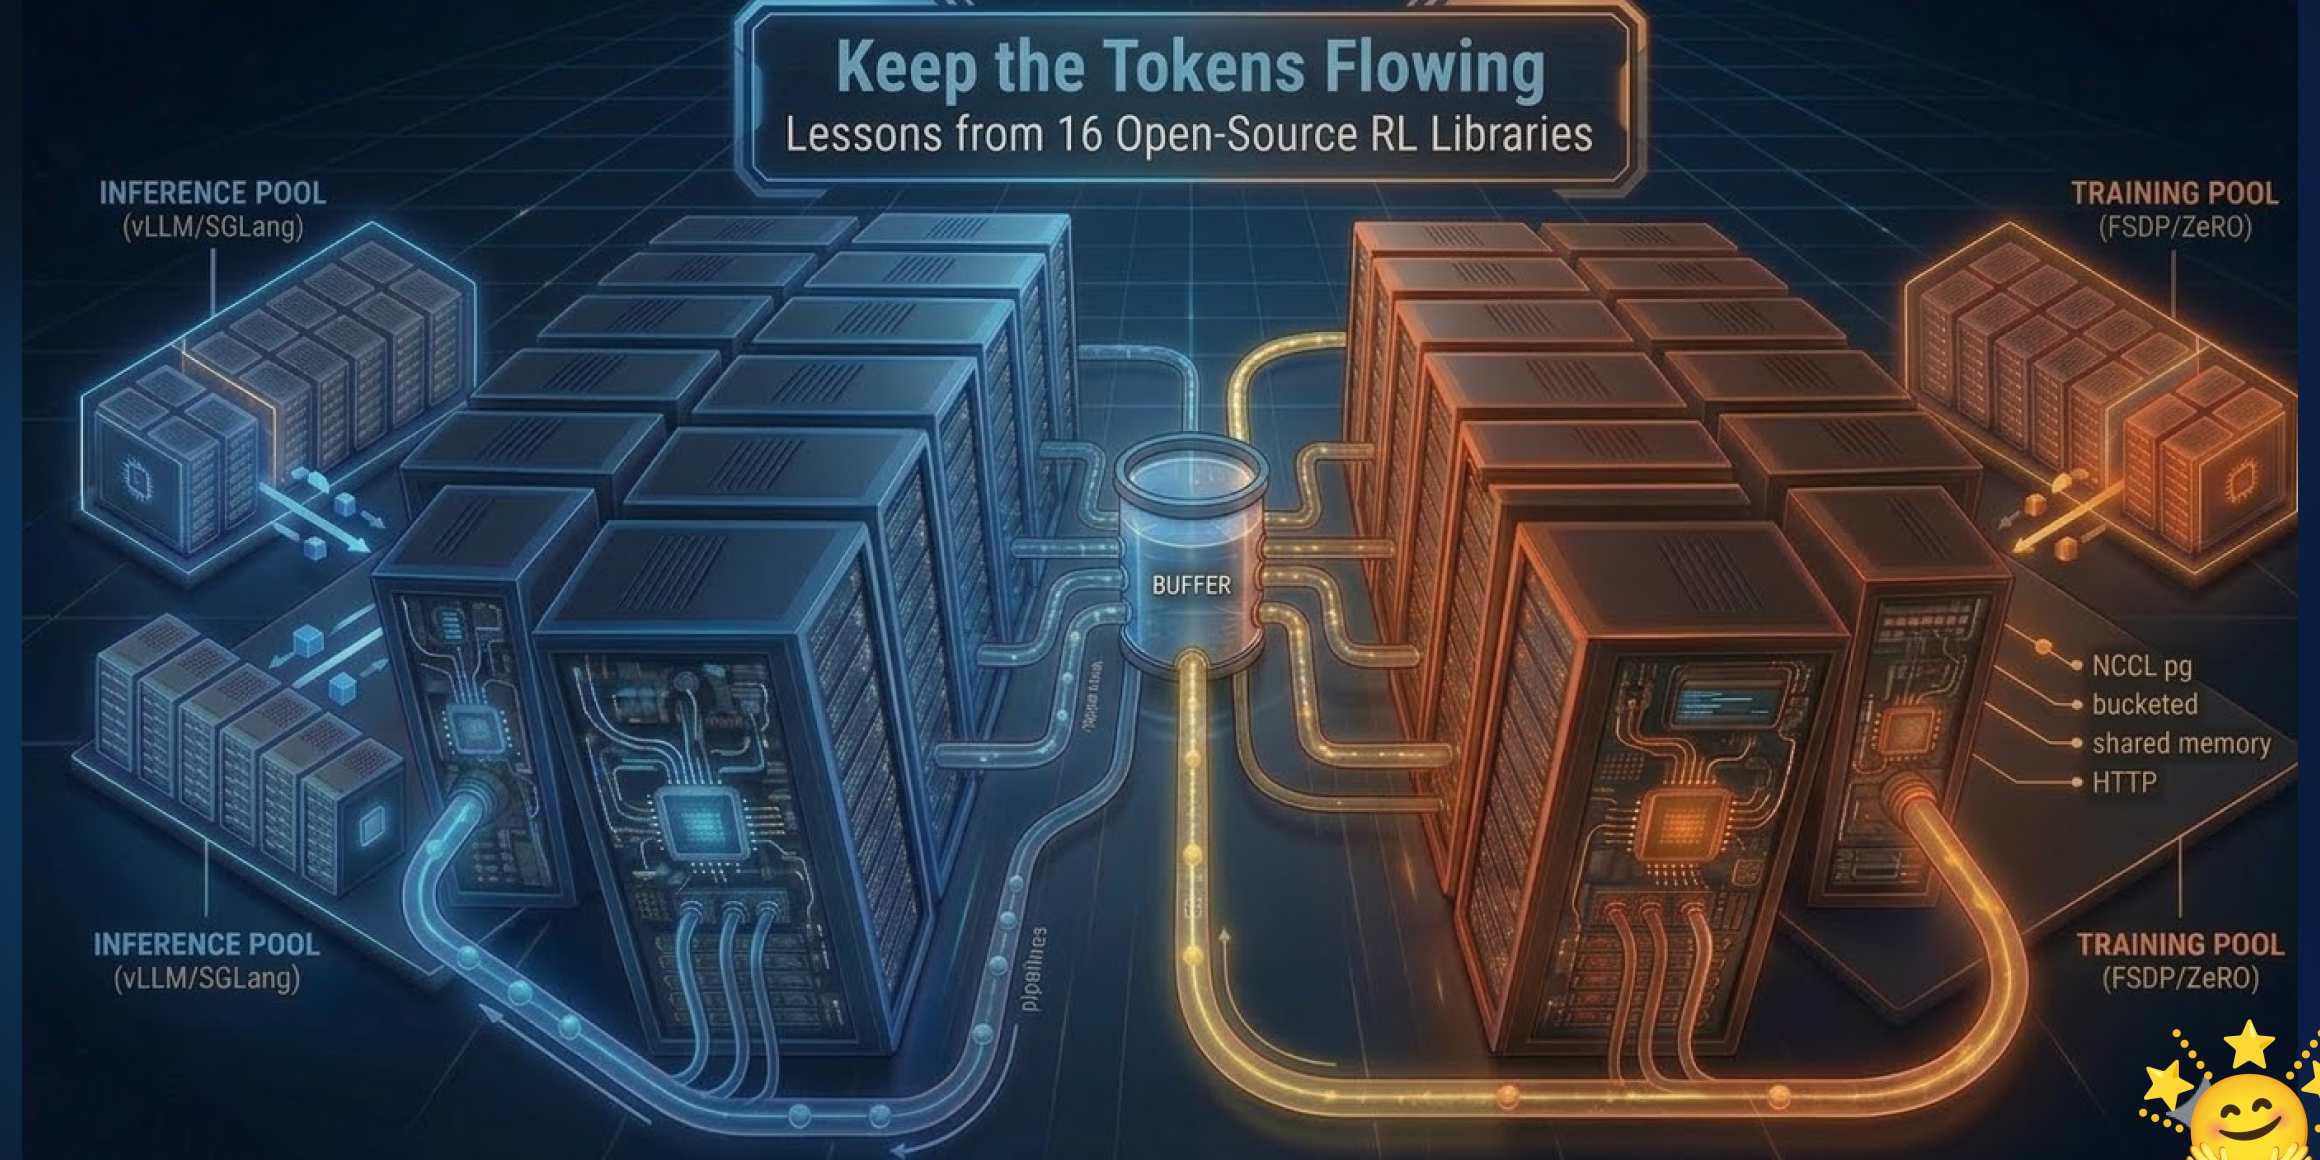
Publicado el 10 de marzo de 2026
Que los tokens fluyan: lecciones de 16 bibliotecas de RL de código abierto
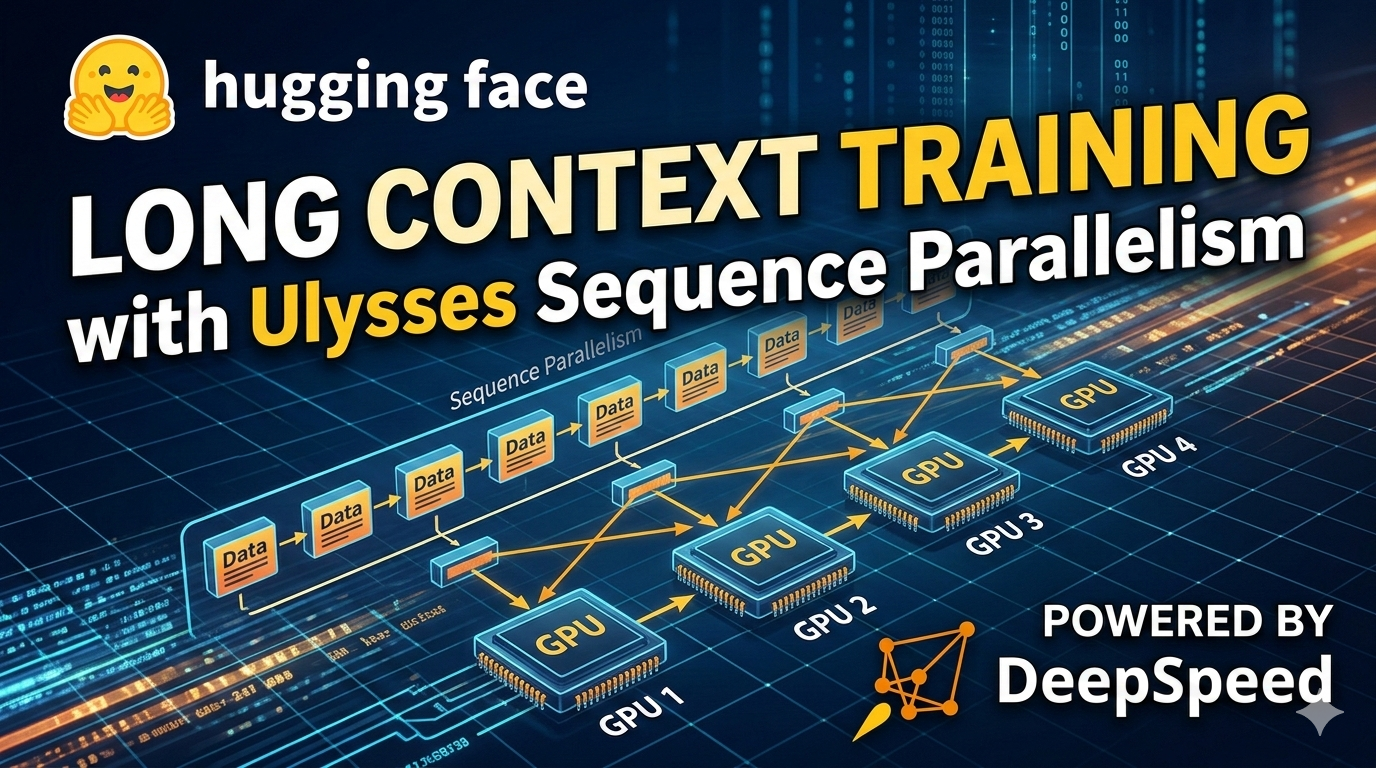
Publicado el 9 de marzo de 2026
Paralelismo de secuencia Ulysses: entrenamiento con contextos de millones de tokens
Publicado el 23 de octubre de 2025
Construyendo juntos el ecosistema de agentes abiertos: presentación de OpenEnv
Publicado el 7 de agosto de 2025
Alineación de modelos de visión y lenguaje en TRL ⚡️
Publicado el 3 de junio de 2025
Ninguna GPU queda atrás: Desbloqueando la eficiencia con vLLM co-ubicado en TRL
Publicado el 25 de mayo de 2025
🐯 Liger GRPO se encuentra con TRL
Publicado el 28 de enero de 2025
Open-R1: una reproducción completamente abierta de DeepSeek-R1
Publicado el 10 de julio de 2024
Optimización de preferencias para modelos de visión y lenguaje con TRL
Publicado el 12 de junio de 2024
Devolver el RL al RLHF
Publicado el 10 de enero de 2024
Haz que el ajuste fino de LLM sea 2 veces más rápido con Unsloth y 🤗 TRL
Publicado el 29 de septiembre de 2023
Ajustar modelos de Stable Diffusion con DDPO mediante TRL
Publicado el 8 de agosto de 2023
Ajuste fino de Llama 2 con DPO
Publicado el 5 de abril de 2023
StackLLaMA: una guía práctica para entrenar LLaMA con RLHF
Publicado el 9 de marzo de 2023
Ajuste fino de LLMs de 20B con RLHF en una GPU de consumo de 24GB
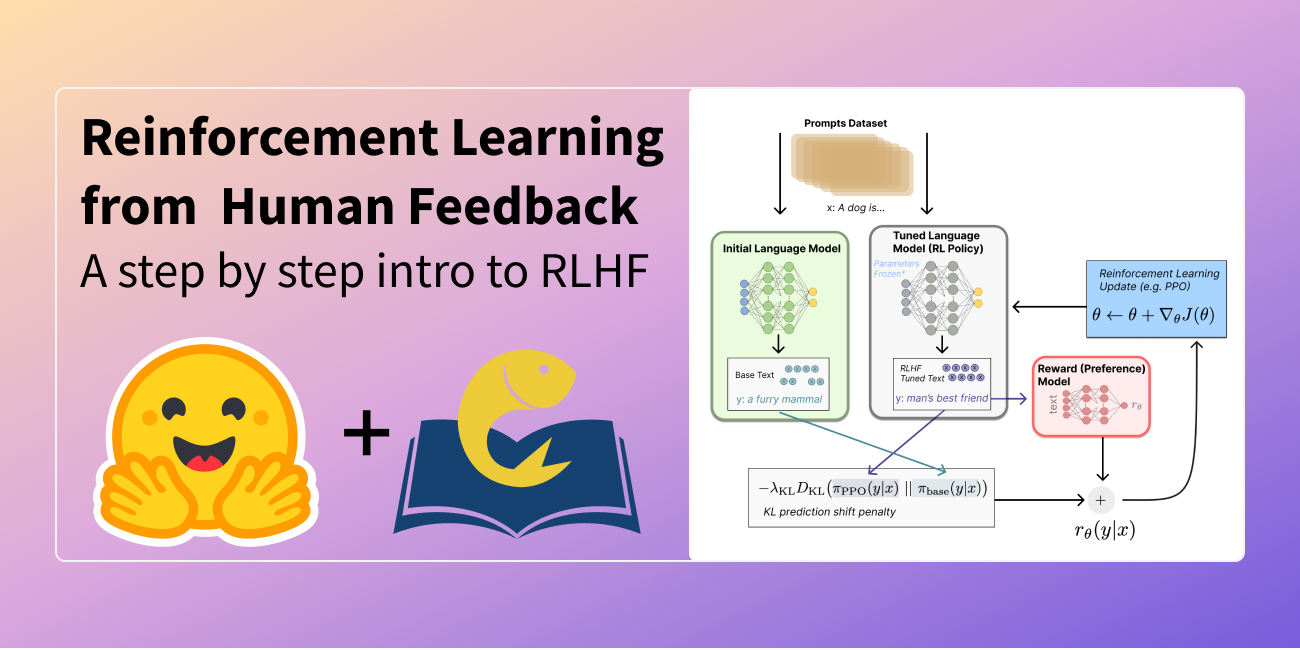
Publicado el 9 de diciembre de 2022
Ilustración del Aprendizaje por Refuerzo con Retroalimentación Humana
