
TRL documentation
TRL - Обучение с подкреплением для Transformers

TRL - Обучение с подкреплением для Transformers
TRL — это библиотека полного цикла, предоставляющая набор инструментов для обучения трансформерных языковых моделей с использованием таких методов, как Supervised Fine-Tuning (SFT), Group Relative Policy Optimization (GRPO), Direct Preference Optimization (DPO), Reward Modeling и других. Библиотека интегрирована с 🤗 transformers.
🎉 Что нового
⚡ AsyncGRPOTrainer теперь стабилен: AsyncGRPOTrainer перешёл в стабильный API. Он значительно ускоряет выполнение GRPO, разделяя генерацию и обучение: сервер vLLM потоково передаёт результаты, пока тренер обновляет модель.
Таксономия
Ниже приведён обзор тренеров TRL, сгруппированных по степени зрелости и типу метода.
Экспериментальный
Вы также можете ознакомиться с моделями, наборами данных и демонстрациями, связанными с TRL, в организации TRL на Hugging Face.
Обучение
Изучите пост-обучение с TRL и другими библиотеками в 🤗 smol course.
Содержание
Документация организована в следующие разделы:
- Начало работы: руководство по установке и быстрому старту.
- Концептуальные руководства: форматы наборов данных, FAQ по обучению и понимание логов.
- Руководства: снижение потребления памяти, ускорение обучения, распределение обучения и т. д.
- Интеграции: DeepSpeed, PEFT и др.
- Примеры: обзор примеров, учебные материалы сообщества и т. д.
- API: тренажёры, утилиты и т. д.
Статьи в блоге
Опубликовано 27 мая 2026
Отправка триллиона параметров с помощью хранилища Hub: синхронизация дельта-весов в TRL

Опубликовано 31 марта 2026
TRL v1: библиотека для пост-обучения, которая сохраняет актуальность, когда область опровергает собственные допущения
Опубликовано 10 марта 2026
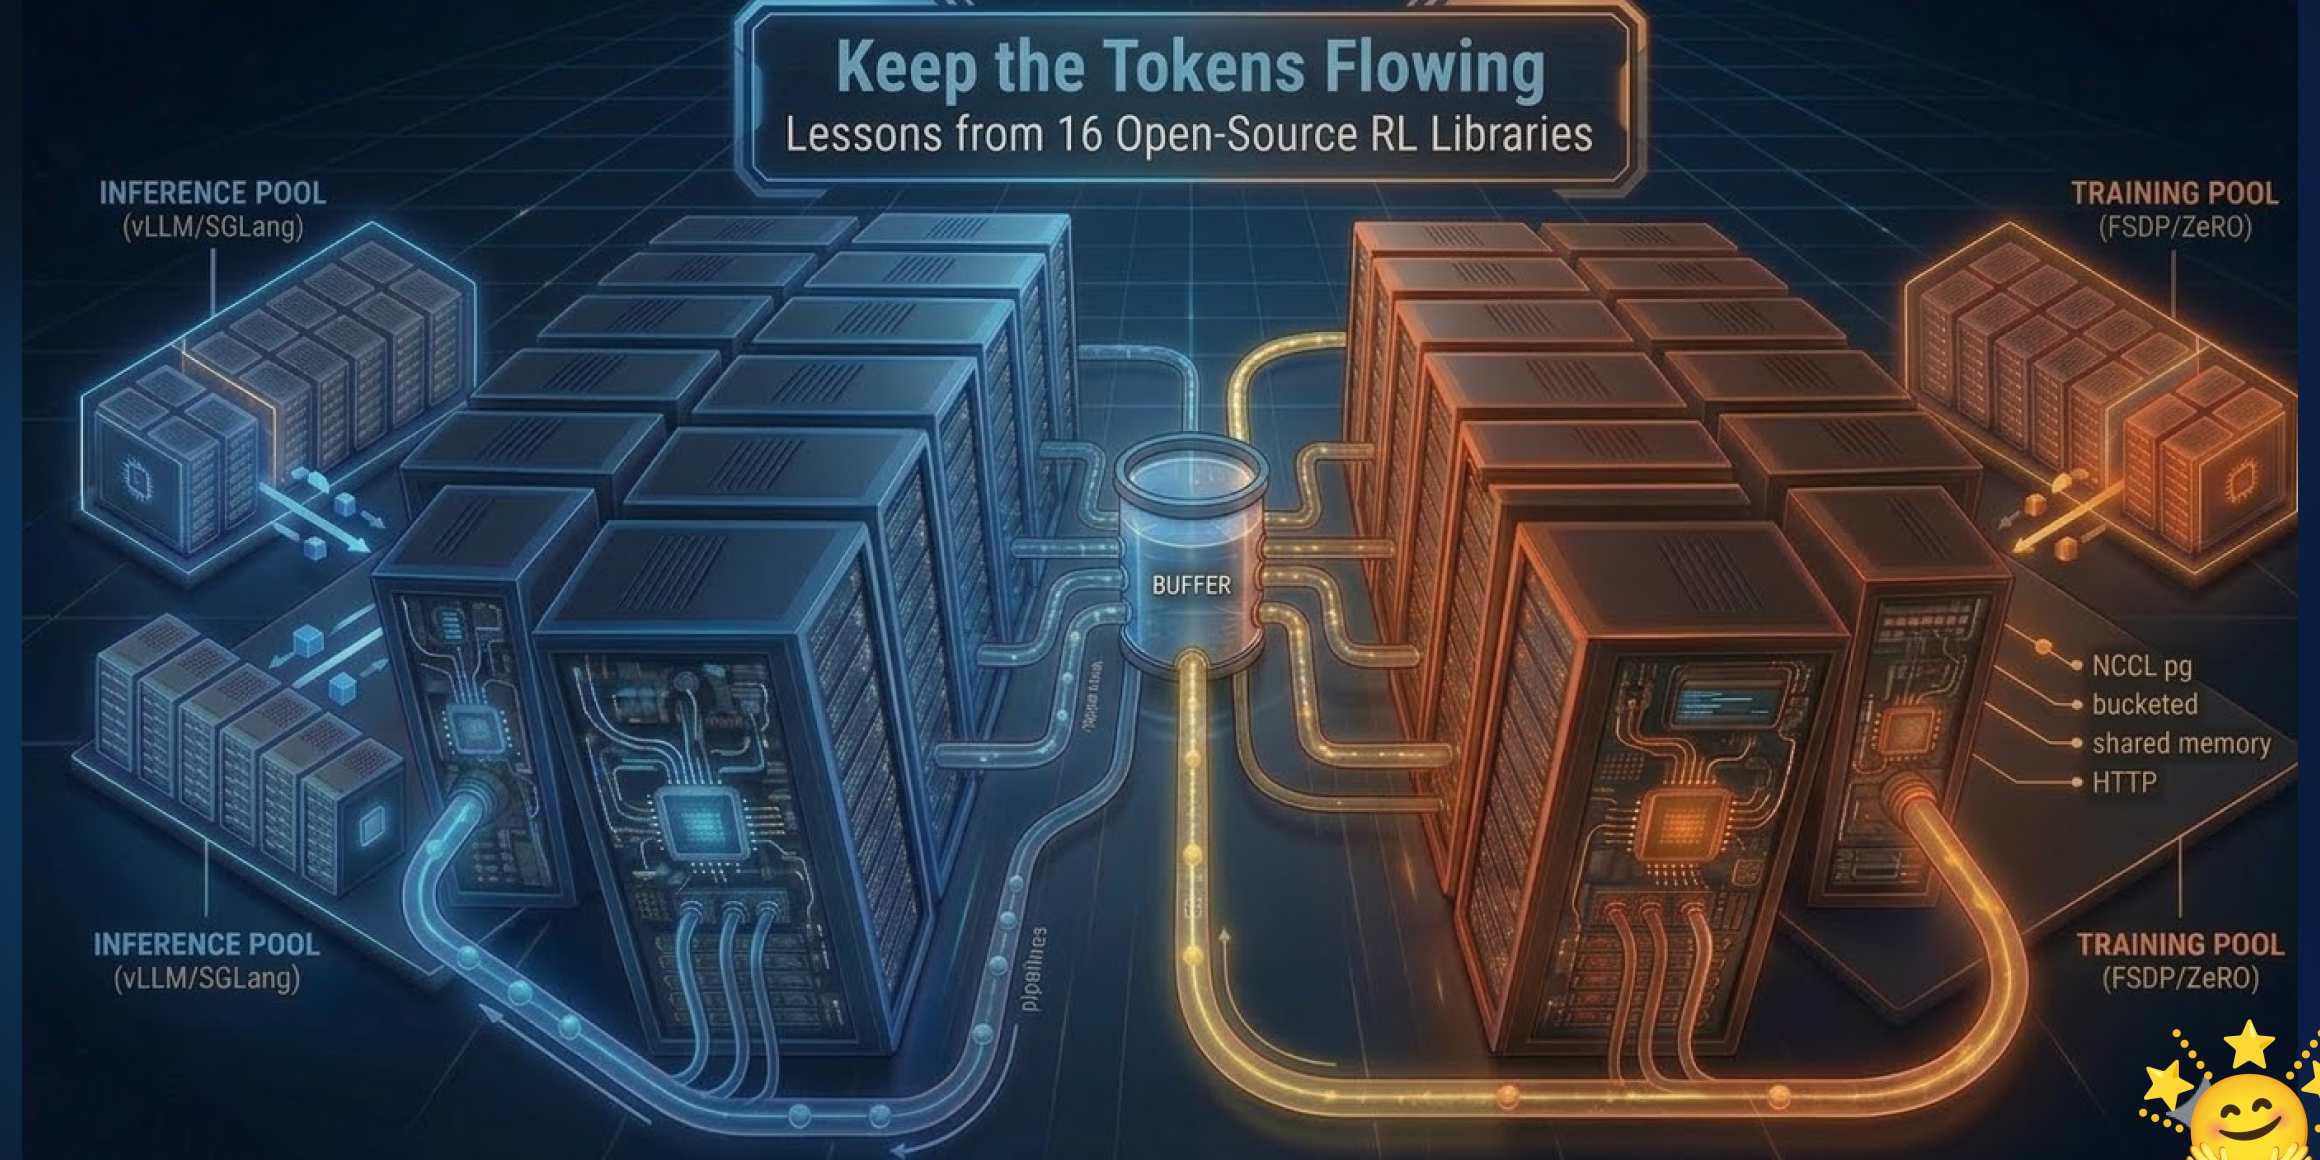
Держите токены в потоке: уроки из 16 открытых библиотек RL
Опубликовано 9 марта 2026
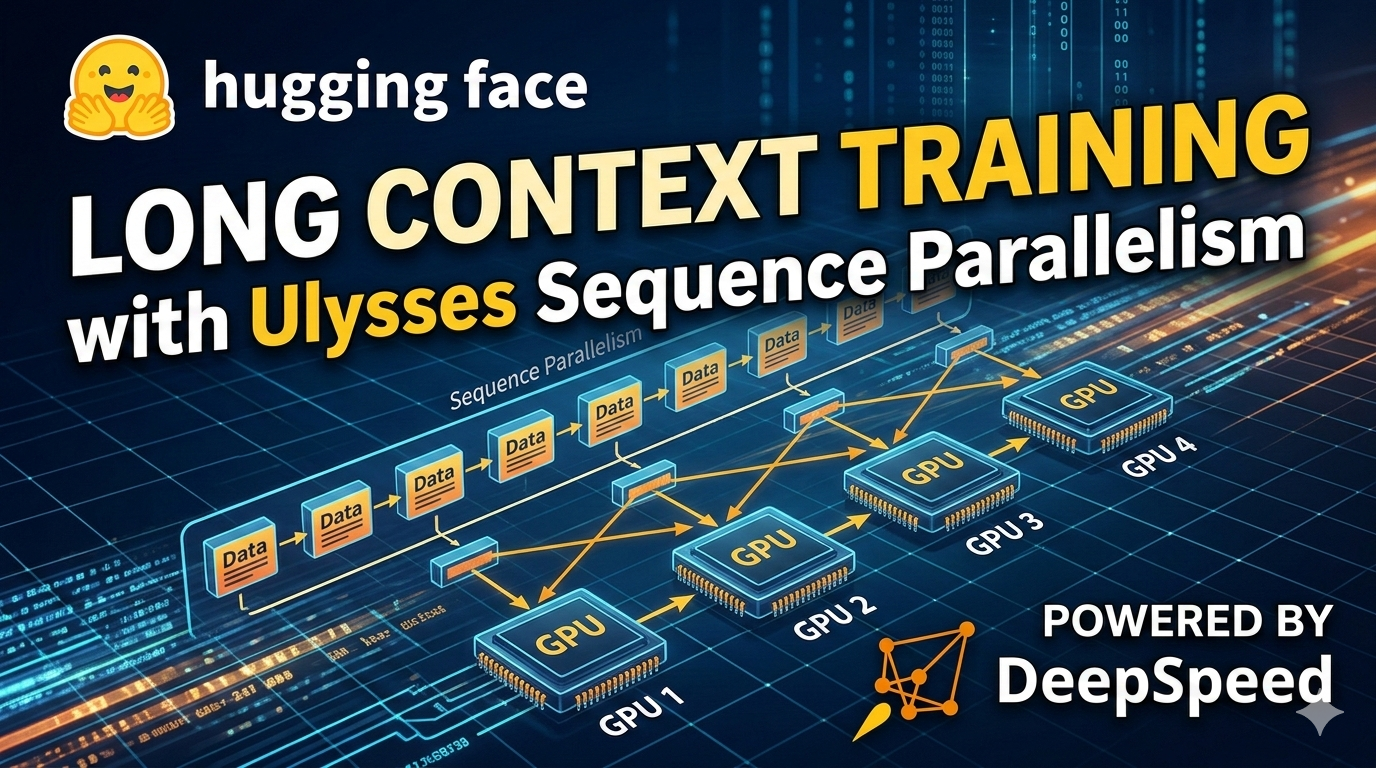
Параллелизм последовательности Ulysses: обучение с контекстами в миллионы токенов
Опубликовано 23 октября 2025
Вместе строим открытую экосистему агентов: представляем OpenEnv
Опубликовано 7 августа 2025
Выравнивание моделей зрения и языка в TRL ⚡️
Опубликовано 3 июня 2025
Ни один GPU не остаётся без дела: повышение эффективности с помощью vLLM, работающего в одном процессе, в TRL
Опубликовано 25 мая 2025
🐯 Liger GRPO встречает TRL
Опубликовано 28 января 2025
Open-R1: полностью открытая репродукция DeepSeek-R1
Опубликовано 10 июля 2024
Оптимизация предпочтений для мультимодальных моделей «зрение-язык» с TRL
Опубликовано 12 июня 2024
Возвращаем RL в RLHF
Опубликовано 10 января 2024
Ускорьте дообучение LLM в 2 раза с помощью Unsloth и 🤗 TRL
Опубликовано 29 сентября 2023
Допобучение моделей Stable Diffusion с помощью DDPO через TRL
Опубликовано 8 августа 2023
Доработка Llama 2 с помощью DPO
Опубликовано 5 апреля 2023
StackLLaMA: Практическое руководство по обучению LLaMA с помощью RLHF
Опубликовано 9 марта 2023
Доработка LLM на 20 млрд параметров с помощью RLHF на потребительском GPU с 24 ГБ
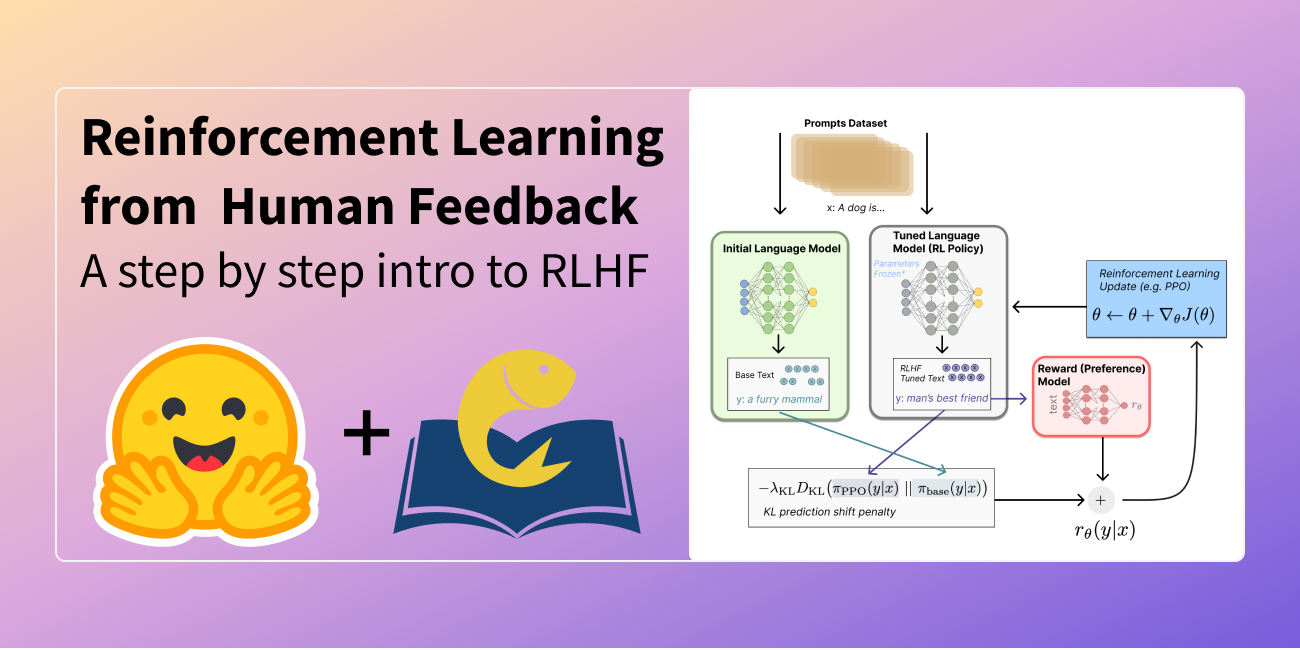
Опубликовано 9 декабря 2022
Иллюстрация обучения с подкреплением на основе обратной связи от человека
