
TRL documentation
TRL - 基于 Transformers 的强化学习

TRL - 基于 Transformers 的强化学习
TRL 是一个全栈库,我们提供了一系列工具,用于使用监督微调(SFT)、组相对策略优化(GRPO)、直接偏好优化(DPO)、奖励建模等方法训练 Transformer 语言模型。 该库与 🤗 transformers 集成。
🎉 新功能
🔥 Mistral Large 4:在单个 8 卡 B300 节点上,基于其 FP8 权重,使用 SFTTrainer 对 Mistral Large 4 进行微调。请参阅 LoRA 示例。
🚀 在 AMD GPU 上进行训练:TRL 的训练器现在可以通过 PyTorch 的 ROCm 构建版本在 AMD Instinct GPU 上运行。
🔥 Beam:使用 SFTTrainer 在单节点 8 张 B300 上对 Beam 进行微调。请参阅 LoRA 示例。
🔥 Muse Spark Open:使用 SFTTrainer 对 Muse Spark Open 进行微调,并在加载时将其分片到各 GPU 上。请参阅 8 节点 LoRA 示例。
🚀 在 AWS Trainium 上进行训练:TRL 的训练器现在可以通过 TorchNeuron(PyTorch 的原生 Neuron 后端)在 AWS Trainium 上运行。
分类
以下是按成熟度和方法类型整理的 TRL 训练器概览。
实验性
您还可以在 TRL Hugging Face 组织 中探索与 TRL 相关的模型、数据集和演示。
学习
在 🤗 smol course 中,学习使用 TRL 及其他库进行后训练。
目录
文档分为以下几个部分:
- 入门指南:安装和快速入门指南。
- 概念指南:数据集格式、训练常见问题解答以及日志解读。
- 操作指南:减少内存占用、加快训练速度、分布式训练等。
- 集成:DeepSpeed、PEFT 等
- 示例:示例概览、社区教程等。
- API:训练器、工具等。
博客文章
发布于 2026 年 5 月 27 日
使用 Hub 桶传输万亿参数:TRL 中的 Delta 权重同步

发布于 2026 年 3 月 31 日
TRL v1:当领域自身的前提被推翻时,依然可靠的后期训练库
发布于 2026 年 3 月 10 日
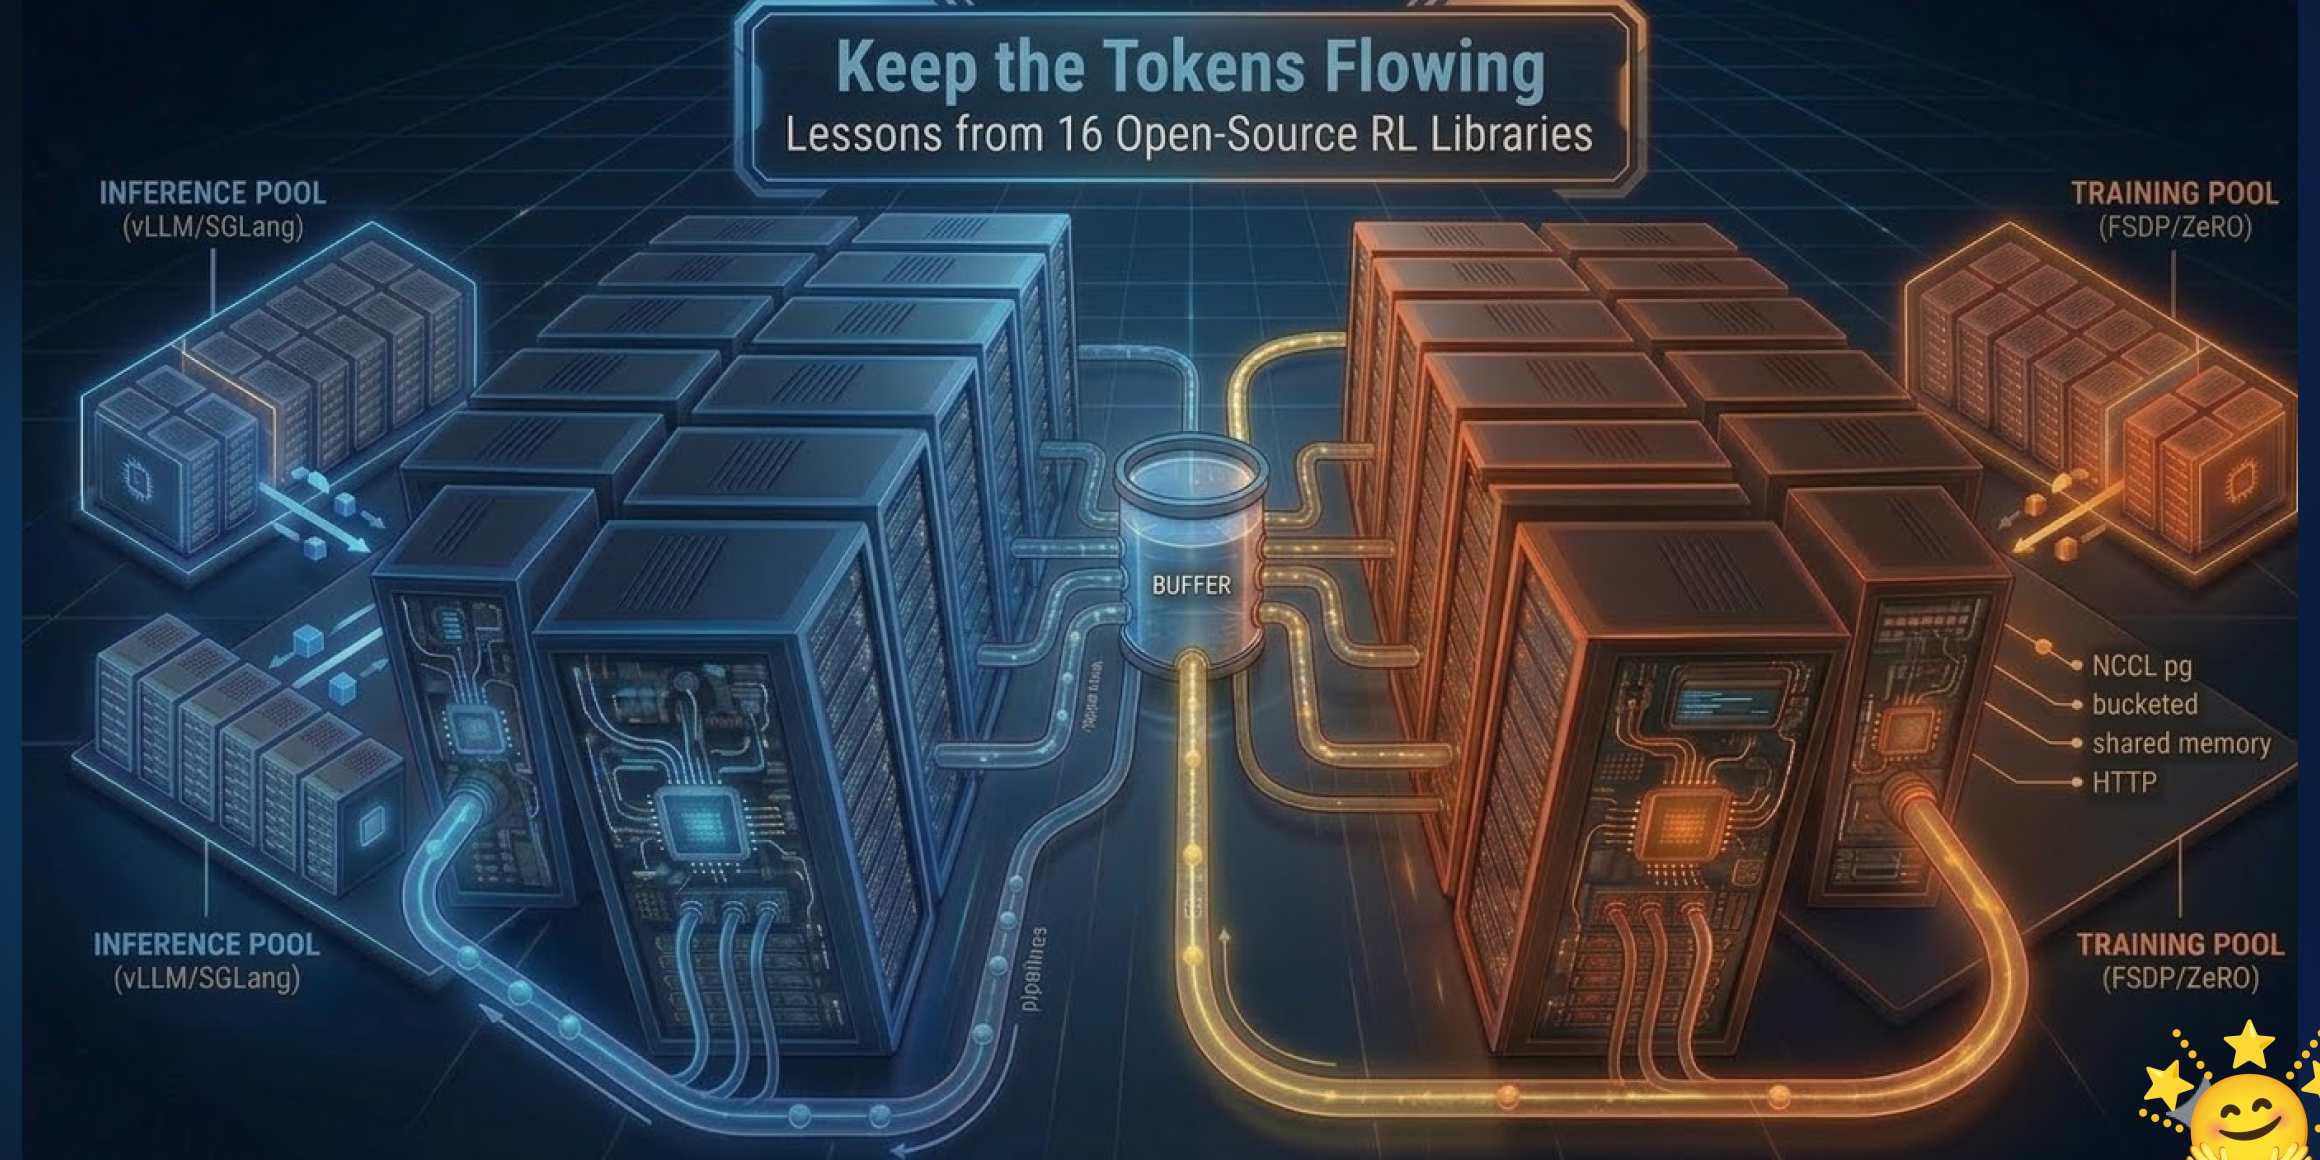
让 Token 持续流动:来自 16 个开源强化学习库的经验
发布于 2026 年 3 月 9 日
Ulysses 序列并行:使用百万级 Token 上下文进行训练
发布于 2025 年 10 月 23 日
共同构建开放智能体生态系统:推出 OpenEnv
发布于 2025 年 8 月 7 日
TRL 中的视觉语言模型对齐 ⚡️
发布于 2025 年 6 月 3 日
不让任何 GPU 闲置:在 TRL 中利用同置 vLLM 释放效率
发布于 2025 年 5 月 25 日
🐯 Liger GRPO 与 TRL 的结合
发布于 2025 年 1 月 28 日
Open-R1:对 DeepSeek-R1 的完全开源复现
发布于 2024 年 7 月 10 日
使用 TRL 对视觉语言模型进行偏好优化
发布于 2024 年 6 月 12 日
将 RL 重新引入 RLHF
发布于 2024 年 1 月 10 日
使用 Unsloth 和 🤗 TRL 将 LLM 微调速度提升 2 倍
发布于 2023 年 9 月 29 日
通过 TRL 使用 DDPO 微调 Stable Diffusion 模型
发布于 2023 年 8 月 8 日
使用 DPO 微调 Llama 2
发布于 2023 年 4 月 5 日
StackLLaMA:使用 RLHF 训练 LLaMA 的实战指南
发布于 2023 年 3 月 9 日
在 24GB 消费级 GPU 上使用 RLHF 微调 20B LLM
发布于 2022 年 12 月 9 日
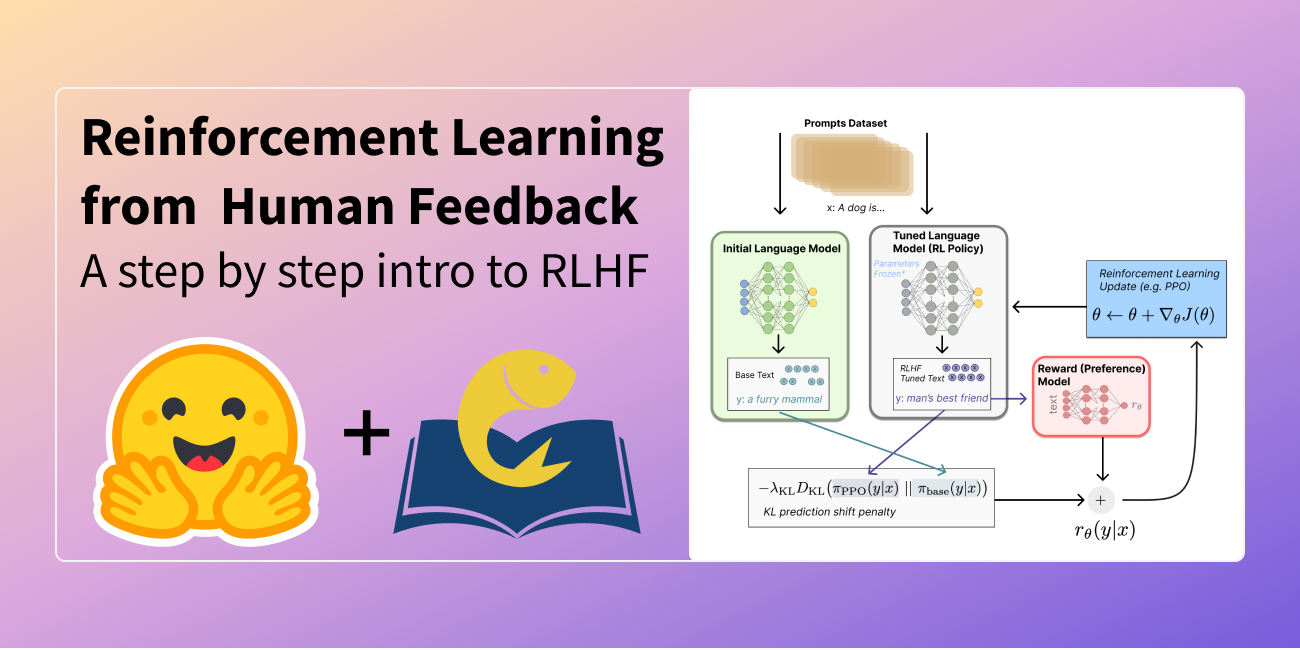
用人类反馈进行强化学习
