
TRL documentation
TRL - Transformers Reinforcement Learning

TRL - Transformers Reinforcement Learning
O TRL é uma biblioteca de pilha completa em que fornecemos um conjunto de ferramentas para treinar modelos de linguagem transformer com métodos como Supervised Fine-Tuning (SFT), Group Relative Policy Optimization (GRPO), Direct Preference Optimization (DPO), Reward Modeling, entre outros. A biblioteca é integrada ao 🤗 transformers.
🎉 Novidades
🔥 Mistral Large 4: Faça o fine-tuning de Mistral Large 4 com SFTTrainer em um único nó com 8 B300s, sobre seus pesos FP8. Veja o exemplo de LoRA.
🚀 Treinamento em GPUs AMD: Os treinadores do TRL agora rodam em GPUs AMD Instinct por meio da build ROCm do PyTorch.
🔥 Beam: Faça o fine-tuning do Beam com o SFTTrainer em um único nó com 8 B300s. Veja o exemplo de LoRA.
🔥 Muse Spark Open: Faça o fine-tuning de Muse Spark Open com SFTTrainer, distribuído em shards entre suas GPUs no momento do carregamento. Veja o exemplo de LoRA com 8 nós.
🚀 Treinamento no AWS Trainium: Os treinadores do TRL agora rodam no AWS Trainium por meio do TorchNeuron, o backend Neuron nativo do PyTorch.
Taxonomia
Abaixo está uma visão geral dos treinadores do TRL, organizados por maturidade e tipo de método.
Experimental
Você também pode explorar modelos, conjuntos de dados e demonstrações relacionados ao TRL na organização TRL no Hugging Face.
Aprender
Aprenda pós-treinamento com TRL e outras bibliotecas no 🤗 smol course.
Conteúdos
A documentação é organizada nas seguintes seções:
- Começando: guia de instalação e introdução rápida.
- Guias conceituais: formatos de conjunto de dados, perguntas frequentes sobre treinamento e compreensão de logs.
- Guias passo a passo: reduzir o uso de memória, acelerar o treinamento, distribuir o treinamento, etc.
- Integrações: DeepSpeed, PEFT, etc.
- Exemplos: visão geral de exemplos, tutoriais da comunidade, etc.
- API: treinadores, utilitários, etc.
Posts de blog
Publicado em 27 de maio de 2026
Enviando um Trilhão de Parâmetros com um Bucket do Hub: Sincronização de Pesos Delta no TRL

Publicado em 31 de março de 2026
TRL v1: Biblioteca de pós-treino que se sustenta quando o campo invalida suas próprias premissas
Publicado em 10 de março de 2026
Mantenha os Tokens em Fluxo: Lições de 16 Bibliotecas de RL de Código Aberto
Publicado em 9 de março de 2026
Paralelismo de Sequência Ulysses: Treinamento com Contextos de Milhões de Tokens
Publicado em 23 de outubro de 2025
Construindo o Ecossistema de Agentes Abertos Juntos: Apresentando o OpenEnv
Publicado em 7 de agosto de 2025
Alinhamento de Modelos de Linguagem Visuais no TRL ⚡️
Publicado em 3 de junho de 2025
Nenhuma GPU fica para trás: Desbloqueando a eficiência com vLLM co-localizado no TRL
Publicado em 25 de maio de 2025
🐯 Liger GRPO encontra TRL
Publicado em 28 de janeiro de 2025
Open-R1: uma reprodução totalmente aberta do DeepSeek-R1
Publicado em 10 de julho de 2024
Otimização de Preferências para Modelos de Visão e Linguagem com TRL
Publicado em 12 de junho de 2024
Colocando o RL de volta no RLHF
Publicado em 10 de janeiro de 2024
Acelere o fine-tuning de LLMs em 2x com Unsloth e 🤗 TRL
Publicado em 29 de setembro de 2023
Ajuste fino de modelos Stable Diffusion com DDPO via TRL
Publicado em 8 de agosto de 2023
Ajuste fino do Llama 2 com DPO
Publicado em 5 de abril de 2023
StackLLaMA: Um guia prático para treinar LLaMA com RLHF
Publicado em 9 de março de 2023
Fine-tuning de LLMs de 20B com RLHF em uma GPU de consumo de 24GB
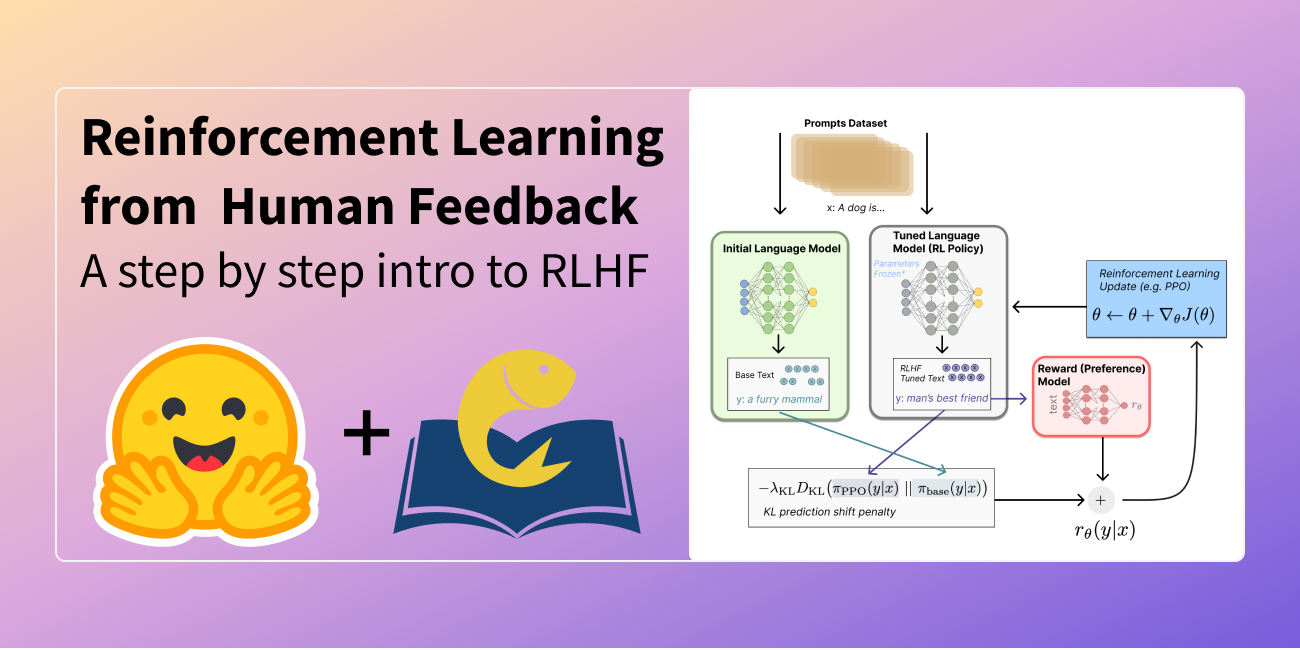
Publicado em 9 de dezembro de 2022
Ilustrando o Aprendizado por Reforço a partir de Feedback Humano
