
TRL documentation
TRL - Pembelajaran Penguatan Transformers

TRL - Pembelajaran Penguatan Transformers
TRL adalah pustaka full stack yang menyediakan seperangkat alat untuk melatih model bahasa transformer dengan metode seperti Supervised Fine-Tuning (SFT), Group Relative Policy Optimization (GRPO), Direct Preference Optimization (DPO), Reward Modeling, dan lainnya. Pustaka ini terintegrasi dengan 🤗 transformers.
🎉 Apa yang Baru
🔥 Mistral Large 4: Lakukan fine-tuning pada Mistral Large 4 menggunakan SFTTrainer di satu node dengan 8 B300, di atas bobot FP8-nya. Lihat contoh LoRA.
🚀 Pelatihan pada GPU AMD: Trainer TRL sekarang berjalan di AMD Instinct GPUs melalui build ROCm dari PyTorch.
🔥 Beam: Lakukan fine-tuning pada Beam menggunakan SFTTrainer di satu node dengan 8 B300. Lihat contoh LoRA.
🔥 Muse Spark Open: Lakukan fine-tuning pada Muse Spark Open menggunakan SFTTrainer, yang di-shard di seluruh GPU Anda saat load. Lihat contoh LoRA 8-node.
🚀 Pelatihan di AWS Trainium: Trainer TRL sekarang berjalan di AWS Trainium melalui TorchNeuron, backend Neuron native dari PyTorch.
Taksonomi
Berikut adalah ringkasan trainer TRL, yang diorganisasi berdasarkan tingkat kematangan dan jenis metode.
Eksperimental
Anda juga dapat menjelajahi model, dataset, dan demo terkait TRL di organisasi TRL Hugging Face.
Pelajari
Pelajari post-training dengan TRL dan pustaka lainnya di 🤗 smol course.
Isi
Dokumentasi ini disusun ke dalam bagian-bagian berikut:
- Mulai: panduan instalasi dan pengenalan cepat.
- Panduan Konseptual: format dataset, FAQ pelatihan, dan memahami log.
- Panduan Cara: mengurangi penggunaan memori, mempercepat pelatihan, mendistribusikan pelatihan, dll.
- Integrasi: DeepSpeed, PEFT, dll.
- Contoh: ringkasan contoh, tutorial komunitas, dll.
- API: trainer, util, dll.
Artikel blog
Diterbitkan pada 27 Mei 2026
Mengirimkan Triliun Parameter dengan Hub Bucket: Sinkronisasi Bobot Delta di TRL

Diterbitkan pada 31 Maret 2026
TRL v1: Perpustakaan Pelatihan Lanjutan yang Tetap Kokoh Saat Bidang Ini Membatalkan Asumsi Sendirinya
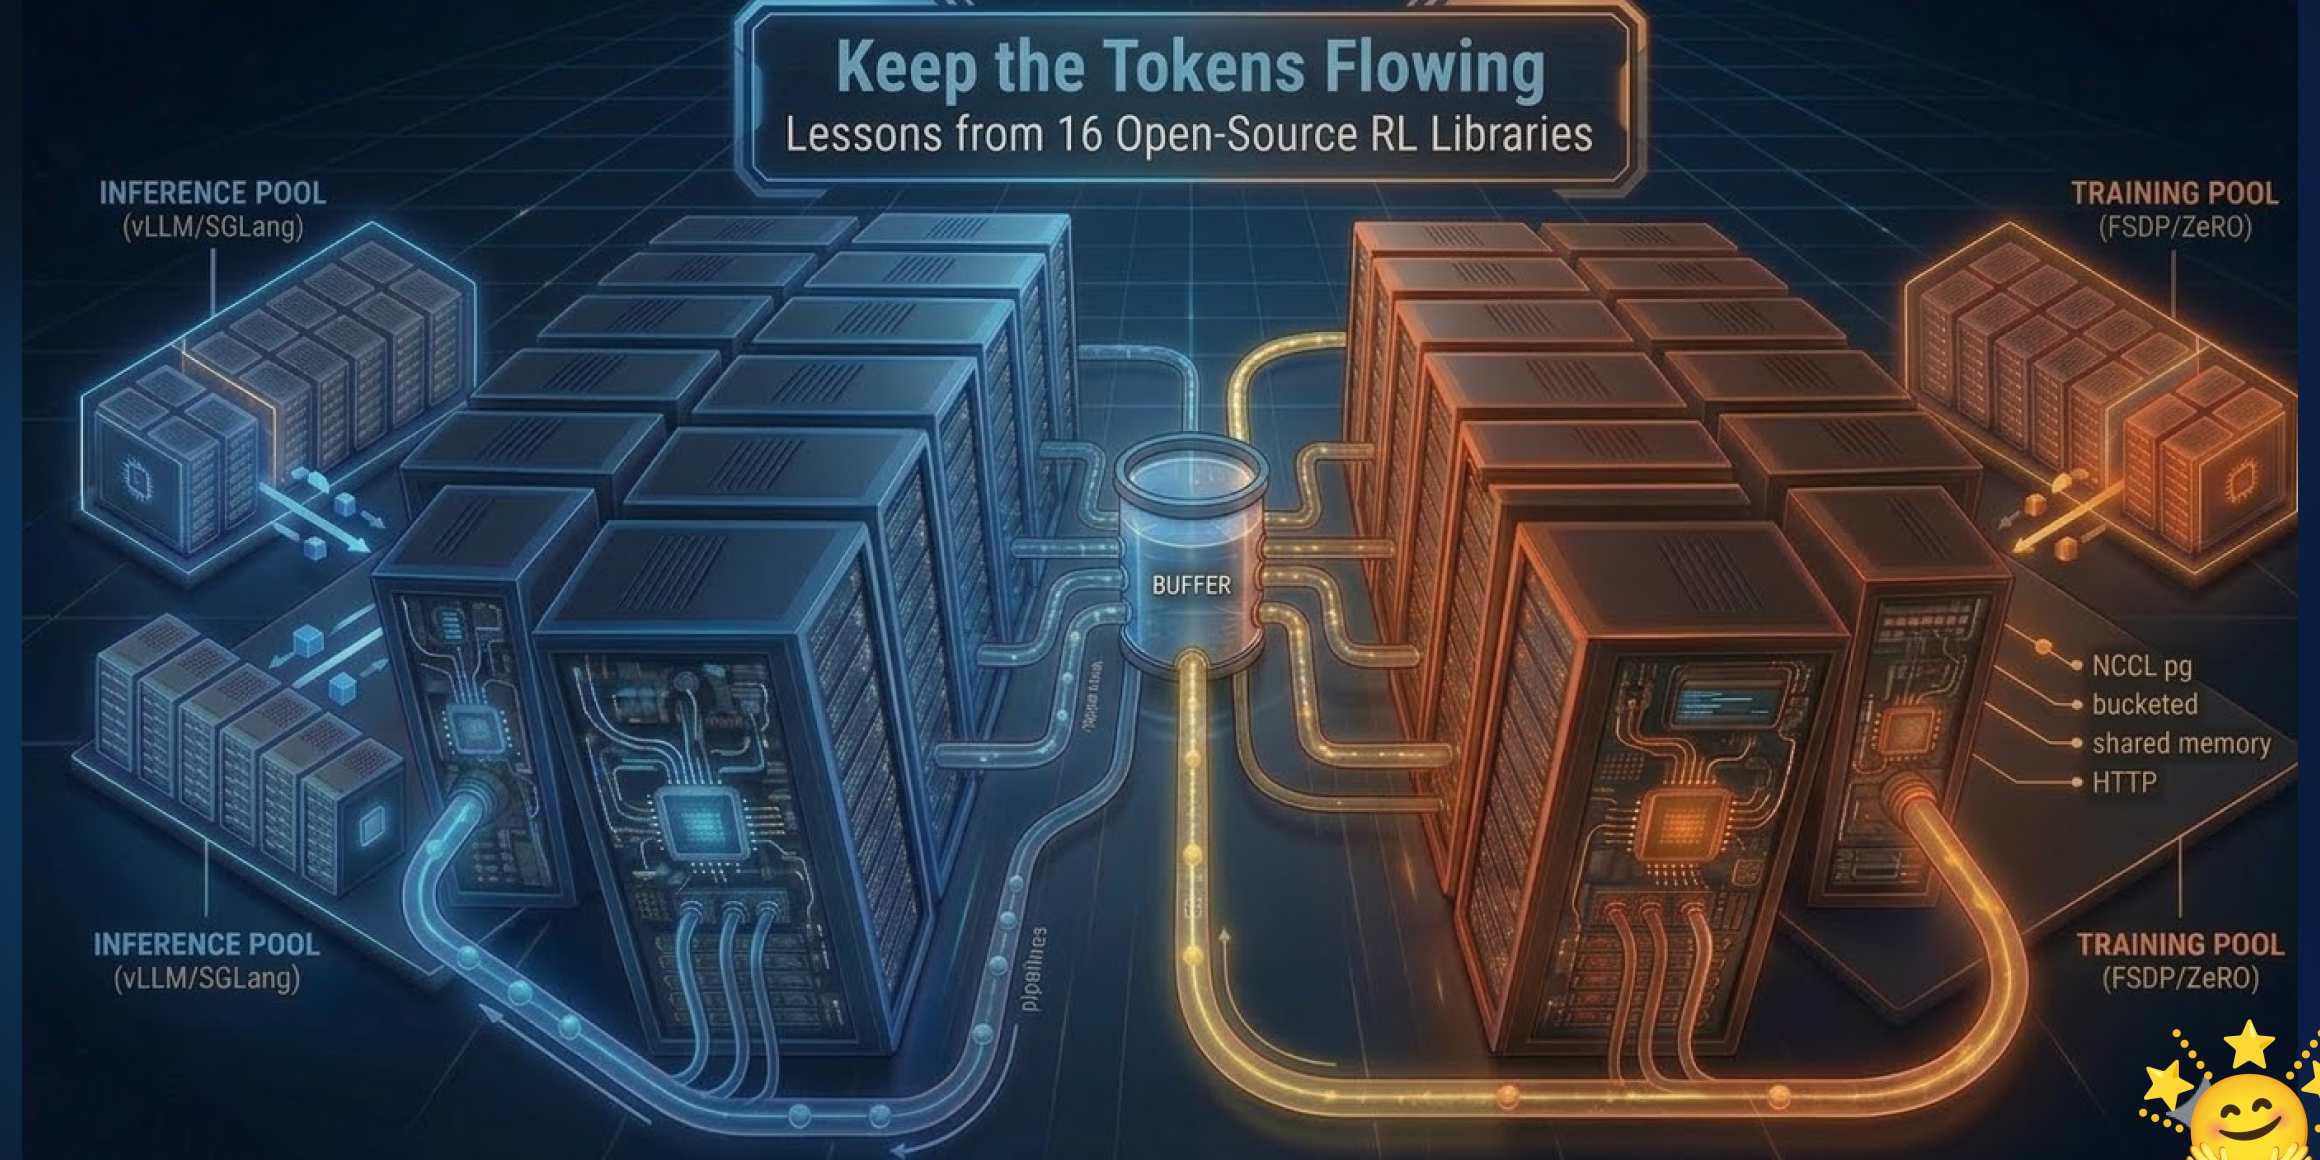
Diterbitkan pada 10 Maret 2026
Biarkan Token Mengalir: Pelajaran dari 16 Perpustakaan RL Open-Source
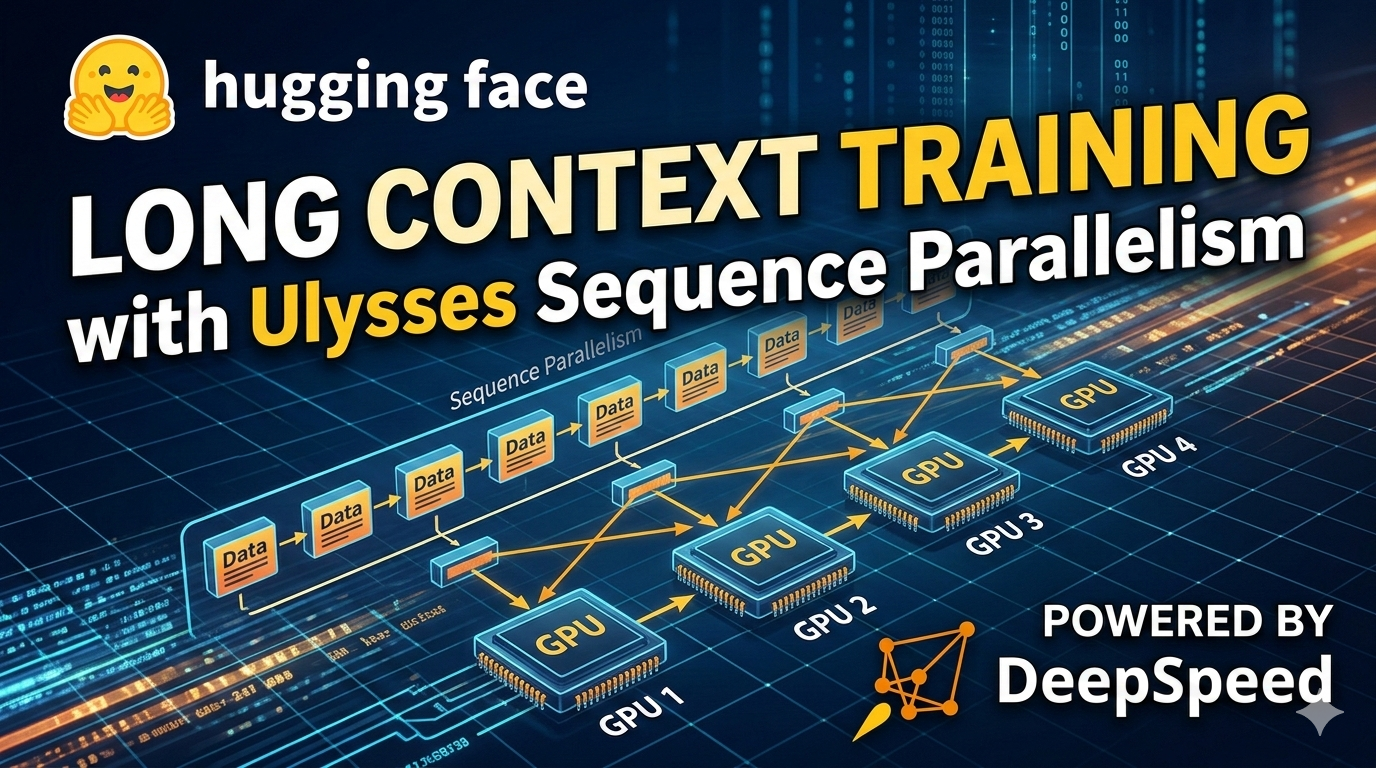
Diterbitkan pada 9 Maret 2026
Ulysses Sequence Parallelism: Pelatihan dengan Konteks Jutaan Token
Diterbitkan 23 Oktober 2025
Membangun Ekosistem Agen Terbuka Bersama: Memperkenalkan OpenEnv
Diterbitkan pada 7 Agustus 2025
Penyelarasan Model Bahasa Visi di TRL ⚡️
Diterbitkan pada 3 Juni 2025
Tidak ada GPU yang tertinggal: Membuka Efisiensi dengan vLLM Co-located di TRL
Diterbitkan pada 25 Mei 2025
🐯 Liger GRPO bertemu TRL
Diterbitkan pada 28 Januari 2025
Open-R1: reproduksi terbuka penuh dari DeepSeek-R1
Diterbitkan pada 10 Juli 2024
Optimasi Preferensi untuk Model Bahasa Visual dengan TRL
Diterbitkan pada 12 Juni 2024
Mengembalikan RL ke dalam RLHF
Diterbitkan pada 10 Januari 2024
Lakukan Fine-tuning LLM 2x lebih cepat dengan Unsloth dan 🤗 TRL
Diterbitkan pada 29 September 2023
Finetune Model Stable Diffusion dengan DDPO melalui TRL
Diterbitkan pada 8 Agustus 2023
Lakukan fine-tuning Llama 2 dengan DPO
Diterbitkan pada 5 April 2023
StackLLaMA: Panduan praktis untuk melatih LLaMA dengan RLHF
Diterbitkan pada 9 Maret 2023
Fine-tuning LLM 20B dengan RLHF pada GPU konsumen 24GB
Diterbitkan pada 9 Desember 2022
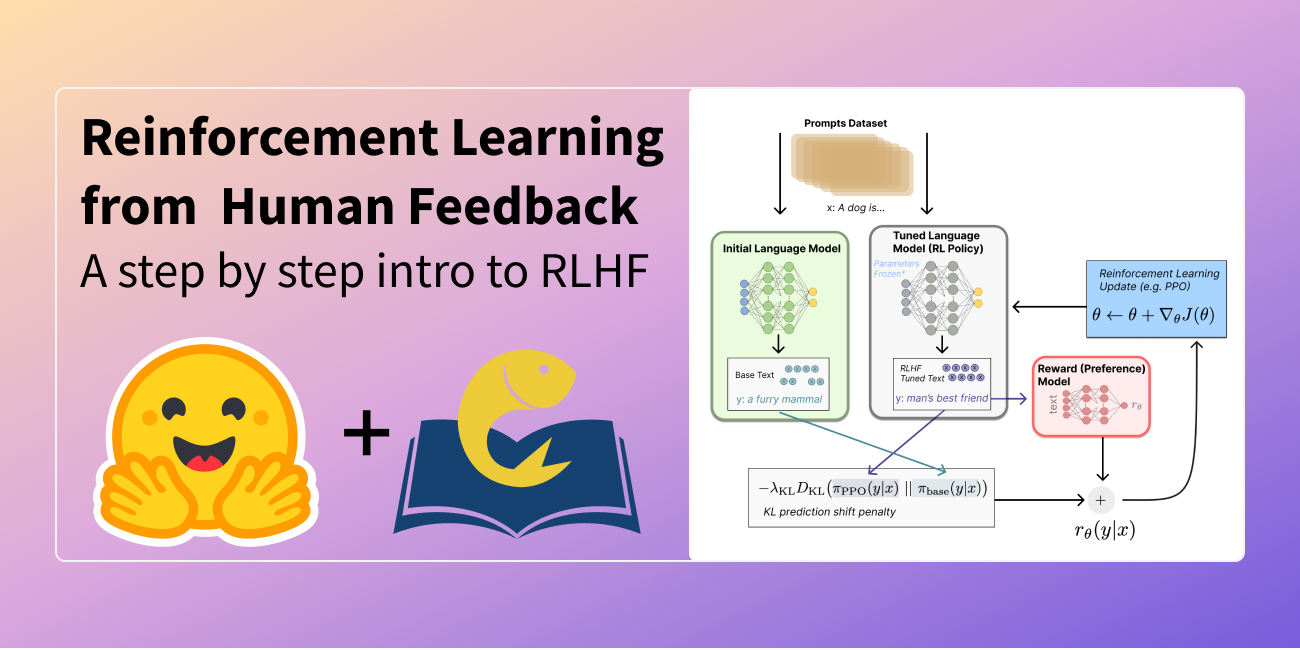
Mengilustrasikan Pembelajaran Penguatan dari Umpan Balik Manusia
