
Transformers documentation
Оптимизация LLM по скорости и памяти
Оптимизация LLM по скорости и памяти
Большые языковые модели (LLM), такие как GPT3/4, Falcon и Llama, стремительно развивают свои возможности в решении задач, ориентированных на человека, и становятся незаменимым инструментом в современных отраслях, основанных на знаниях. Однако развёртывание этих моделей в реальных задачах по-прежнему остаётся сложным:
- Чтобы демонстрировать возможности понимания и генерации текста, близкие к человеческим, LLMs в настоящее время должны состоять из миллиардов параметров (см. Kaplan et al, Wei et. al). Это, в свою очередь, многократно увеличивает требования к памяти при выводе.
- Во многих практических задачах LLM необходимо предоставлять обширную контекстную информацию. Это требует, чтобы модель могла обрабатывать очень длинные входные последовательности на этапе инференса.
Суть этих проблем заключается в расширении вычислительных и возможностей памяти LLM, особенно при обработке длинных входных последовательностей.
В этом руководстве мы рассмотрим эффективные методы для оптимизированного развертывания LLM:
Низкая точность: Исследования показали, что работа с пониженной числовой точностью, а именно 8-битной и 4-битной, позволяет получить вычислительные преимущества без существенного снижения качества модели.
Flash Attention: Flash Attention — это вариант алгоритма внимания, который не только обеспечивает более эффективное использование памяти, но и повышает общую производительность за счёт оптимизированного использования памяти GPU.
Архитектурные инновации: Поскольку LLMs всегда разворачиваются одинаковым образом на этапе инференса, а именно — авто-регрессивная генерация текста с длинным входным контекстом, были предложены специализированные архитектуры моделей, позволяющие осуществлять инференс более эффективно. Наиболее важными достижениями в области архитектур моделей являются Alibi, Rotary embeddings, Multi-Query Attention (MQA) и Grouped-Query-Attention (GQA).
В этом руководстве мы проанализируем авто-регрессивную генерацию с точки зрения тензоров. Мы рассмотрим преимущества и недостатки перехода к более низкой точности, подробно изучим новейшие алгоритмы внимания и обсудим улучшенные архитектуры LLM. По ходу изложения мы приводим практические примеры, демонстрирующие каждое из улучшений.
1. Более низкая точность
Требования к памяти для LLM лучше всего понять, рассматривая LLM как набор матриц и векторов весов, а текстовые входные данные — как последовательность векторов. В дальнейшем термин weights будет использоваться для обозначения всех матриц и векторов весов модели.
На момент написания этого руководства LLM состоят как минимум из нескольких миллиардов параметров. Каждый параметр представляет собой десятичное число, например 4.5689, которое обычно хранится в формате float32, bfloat16 или float16. Это позволяет легко вычислить объём памяти, необходимый для загрузки LLM в оперативную память:
Загрузка весов модели с X миллиардами параметров требует примерно 4 * X ГБ видеопамяти в точности float32
Сегодня модели, однако, редко обучают в полной точности float32, как правило, в точности bfloat16 или, реже, в float16. Поэтому правило большого пальца становится следующим:
Загрузка весов модели с X миллиардами параметров требует примерно 2 * X ГБ видеопамяти в точности bfloat16/float16
Для коротких входных текстов (менее 1024 токенов) требования к памяти при инференсе в значительной степени определяются объёмом памяти, необходимым для загрузки весов. Поэтому пока будем считать, что требования к памяти для инференса равны требованиям к памяти для загрузки модели в VRAM GPU.
Вот несколько примеров того, сколько VRAM примерно требуется для загрузки модели в bfloat16:
- GPT3 требует 2 * 175 ГБ = 350 ГБ VRAM
- Bloom требует 2 * 176 ГБ = 352 ГБ VRAM
- Llama-2-70b требует 2 * 70 ГБ = 140 ГБ VRAM
- Falcon-40b требует 2 * 40 ГБ = 80 ГБ VRAM
- MPT-30b требует 2 * 30 ГБ = 60 ГБ VRAM
- bigcode/starcoder требует 2 * 15,5 = 31 ГБ VRAM
На момент написания данного документа крупнейшим GPU-чипом на рынке является A100 & H100 с 80 ГБ видеопамяти. Большинство моделей, перечисленных выше, требуют более 80 ГБ только для загрузки и, следовательно, обязательно нуждаются в тензорном параллелизме и/или конвейерном параллелизме.
🤗 Transformers теперь поддерживает тензорный параллелизм для поддерживаемых моделей, у которых в соответствующих классах конфигурации есть base_tp_plan. Подробнее о тензорном параллелизме — здесь. Кроме того, если вы заинтересованы в написании моделей с учётом тензорного параллелизма, посмотрите библиотеку text-generation-inference.
Наивный параллелизм конвейера поддерживается из коробки. Для этого достаточно загрузить модель с параметром device="auto", который автоматически распределит различные слои по доступным GPU, как описано здесь.
Обратите внимание, что, хотя этот наивный параллелизм конвейера очень эффективен, он не решает проблему простоя GPU. Для этого требуется более продвинутый параллелизм конвейера, как описано здесь.
Если у вас есть доступ к узлу 8 x 80GB A100, вы можете загрузить BLOOM следующим образом
!pip install transformers accelerate bitsandbytes optimum
from transformers import AutoModelForCausalLM

model = AutoModelForCausalLM.from_pretrained("bigscience/bloom", device_map="auto", pad_token_id=0)
При использовании device_map="auto" слои внимания распределяются равномерно по всем доступным GPU.
В этом руководстве мы будем использовать bigcode/octocoder, так как его можно запустить на одном чипе GPU A100 с 40 ГБ памяти. Обратите внимание, что все оптимизации памяти и скорости, которые мы будем применять далее, в равной степени применимы к моделям, требующим параллелизма на уровне модели или тензоров.
Поскольку модель загружена в точности bfloat16, согласно нашему правилу выше, ожидаемое потребление памяти для запуска инференса с bigcode/octocoder составляет около 31 ГБ VRAM. Давайте попробуем.
Сначала мы загружаем модель и токенизатор, а затем передаём оба объекта в объект pipeline из Transformers.
from transformers import AutoModelForCausalLM, AutoTokenizer, pipeline
import torch

model = AutoModelForCausalLM.from_pretrained("bigcode/octocoder", dtype=torch.bfloat16, device_map="auto", pad_token_id=0)
tokenizer = AutoTokenizer.from_pretrained("bigcode/octocoder")

pipe = pipeline("text-generation", model=model, tokenizer=tokenizer)prompt = "Question: Please write a function in Python that transforms bytes to Giga bytes.\n\nAnswer:"
result = pipe(prompt, max_new_tokens=60)[0]["generated_text"][len(prompt):]
resultРезультат:
Here is a Python function that transforms bytes to Giga bytes:\n\n```python\ndef bytes_to_giga_bytes(bytes):\n return bytes / 1024 / 1024 / 1024\n```\n\nThis function takes a single
Отлично, теперь мы можем напрямую использовать результат для преобразования байтов в гигабайты.
def bytes_to_giga_bytes(bytes):
  return bytes / 1024 / 1024 / 1024
Вызовем torch.accelerator.memory.max_memory_allocated, чтобы измерить пиковое выделение памяти на ускорителе.
bytes_to_giga_bytes(torch.accelerator.max_memory_allocated())
Результат:
29.0260648727417
Достаточно близко к нашей приблизительной оценке! Мы видим, что число не совсем точное, так как для перехода из байтов в килобайты требуется умножение на 1024, а не на 1000. Следовательно, формулу для приблизительной оценки можно также понимать как вычисление «не более X ГБ». Обратите внимание, что если бы мы попытались запустить модель в полной точности float32, потребовалось бы целых 64 ГБ видеопамяти.
Почти все модели сейчас обучаются в bfloat16, поэтому нет смысла запускать модель в полной точности float32, если ваша GPU поддерживает bfloat16. Float32 не даст лучших результатов инференса, чем та точность, которая использовалась при обучении модели.
Если вы не уверены, в каком формате на Hub хранятся веса модели, вы всегда можете посмотреть параметр "dtype" в конфигурации чекпоинта, например здесь. Рекомендуется при загрузке с помощью from_pretrained(..., dtype=...) устанавливать для модели тот же тип точности, что указан в конфигурации, за исключением случая, когда исходный тип — float32, тогда для инференса можно использовать как float16, так и bfloat16.
Определим функцию flush(...) для освобождения всей выделенной памяти, чтобы точно измерить пиковый объём выделенной памяти GPU.
del pipe
del model

import gc
import torch

def flush():
  gc.collect()
  torch.accelerator.empty_cache()
  torch.accelerator.reset_peak_memory_stats()
Вызовем его сейчас для следующего эксперимента.
flush()
Из библиотеки Accelerate также можно использовать метод release_memory, не зависящий от конкретного устройства, который учитывает различные аппаратные бэкенды, такие как XPU, MLU, NPU, MPS и другие.
from accelerate.utils import release_memory
# ...

release_memory(model)
А что, если у вашей GPU нет 32 ГБ видеопамяти? Было установлено, что веса модели можно квантовать до 8 или 4 бит без значительной потери производительности (см. Dettmers et al.). Как показано в недавней статье GPTQ, модель можно квантовать даже до 3 или 2 бит с приемлемой потерей производительности 🤯.
Не вдаваясь в излишние подробности, схемы квантования направлены на снижение точности весов при сохранении максимально возможной точности результатов инференса модели (то есть как можно ближе к bfloat16).
Обратите внимание, что квантование особенно хорошо работает для генерации текста, поскольку нас интересует только выбор набора наиболее вероятных следующих токенов, а точные значения распределения логитов следующего токена нас не волнуют.
Важно лишь, чтобы распределение логитов следующего токена оставалось примерно таким же, чтобы операции argmax или topk давали те же результаты.
Существуют различные методы квантования, которые мы не будем подробно рассматривать здесь, но в целом все методы квантования работают следующим образом:
- Квантовать все веса до целевой точности
- Загрузите квантованные веса и передайте входную последовательность векторов в точности bfloat16
- Динамически деквантовать веса в bfloat16 для выполнения вычислений с их входными векторами в точности bfloat16
Короче говоря, это означает, что входная матрица умножается на где входы, матрица весов, а выход:
изменяются на
для каждого умножения матриц. Декуантизация и рекуантизация выполняются последовательно для всех матриц весов по мере прохождения входных данных через граф сети.
Поэтому время инференса часто не сокращается при использовании квантованных весов, а, напротив, увеличивается.
Достаточно теории, давайте попробуем! Чтобы квантовать веса с помощью Transformers, убедитесь, что
установлена библиотека bitsandbytes.
!pip install bitsandbytes
Затем мы можем загрузить модели в 8-битном квантовании, просто добавив флаг load_in_8bit=True к from_pretrained.
model = AutoModelForCausalLM.from_pretrained("bigcode/octocoder", quantization_config=BitsAndBytesConfig(load_in_8bit=True), pad_token_id=0)Теперь давайте снова запустим наш пример и измерим потребление памяти.
pipe = pipeline("text-generation", model=model, tokenizer=tokenizer)

result = pipe(prompt, max_new_tokens=60)[0]["generated_text"][len(prompt):]
resultРезультат:
Here is a Python function that transforms bytes to Giga bytes:\n\n```python\ndef bytes_to_giga_bytes(bytes):\n return bytes / 1024 / 1024 / 1024\n```\n\nThis function takes a single
Отлично, мы получили тот же результат, что и раньше, так что точность не пострадала! Посмотрим, сколько памяти было использовано на этот раз.
bytes_to_giga_bytes(torch.accelerator.max_memory_allocated())
Результат:
15.219234466552734
Значительно меньше! Мы снизили потребление до чуть более 15 ГБ, что позволяет запускать эту модель на потребительских GPU, таких как 4090. Мы наблюдаем значительный прирост эффективности использования памяти и практически отсутствие деградации качества вывода модели. Однако также можно заметить небольшое замедление во время инференса.
Мы удаляем модели и снова очищаем память.
del model
del pipeflush()
Посмотрим, какое потребление видеопамяти GPU даёт 4-битное квантование. Квантование модели до 4 бит выполняется с помощью того же API, что и раньше, — на этот раз передавая load_in_4bit=True вместо load_in_8bit=True.
model = AutoModelForCausalLM.from_pretrained("bigcode/octocoder", quantization_config=BitsAndBytesConfig(load_in_4bit=True), pad_token_id=0)

pipe = pipeline("text-generation", model=model, tokenizer=tokenizer)

result = pipe(prompt, max_new_tokens=60)[0]["generated_text"][len(prompt):]
resultРезультат:
Here is a Python function that transforms bytes to Giga bytes:\n\n```\ndef bytes_to_gigabytes(bytes):\n return bytes / 1024 / 1024 / 1024\n```\n\nThis function takes a single argument
Мы почти видим тот же самый вывод, что и раньше — просто отсутствует python непосредственно перед фрагментом кода. Посмотрим, сколько памяти потребовалось.
bytes_to_giga_bytes(torch.accelerator.max_memory_allocated())
Результат:
9.543574333190918
Всего 9,5 ГБ! Это действительно немного для модели с более чем 15 миллиардами параметров.
Хотя в нашем случае точность модели практически не снижается, 4-битное квантование на практике часто приводит к другим результатам по сравнению с 8-битным квантованием или полным выводом в bfloat16. Пользователю следует самостоятельно проверить это на практике.
Также обратите внимание, что здесь инференс снова был немного медленнее по сравнению с 8-битным квантованием, что обусловлено более агрессивным методом квантования, используемым для 4-битного квантования, из-за чего и занимают больше времени во время инференса.
del model
del pipeflush()
В целом мы увидели, что запуск OctoCoder с точностью 8 бит сокращает требуемый объём видеопамяти GPU с 32 ГБ до 15 ГБ, а запуск модели с точностью 4 бит дополнительно снижает требуемый объём видеопамяти GPU чуть выше 9 ГБ.
4-битная квантизация позволяет запускать модель на GPU, таких как RTX3090, V100 и T4, которые доступны большинству пользователей.
Для получения дополнительной информации о квантовании и о том, как можно квантовать модели так, чтобы они требовали ещё меньше видеопамяти GPU, чем в 4-битном представлении, рекомендуем ознакомиться с реализацией GPT-QModel.
В заключение важно помнить, что квантование моделей повышает эффективность использования памяти за счёт точности, а в некоторых случаях — и времени инференса.
Если объём видеопамяти GPU не является ограничением для вашей задачи, часто нет необходимости изучать квантование. Однако многие GPU просто не способны запускать LLM без методов квантования, и в этом случае схемы 4-битного и 8-битного квантования становятся крайне полезными инструментами.
Для получения более подробной информации об использовании мы настоятельно рекомендуем ознакомиться с документацией Transformers по квантованию. Далее рассмотрим, как можно повысить вычислительную и энергетическую эффективность за счёт применения более совершенных алгоритмов и улучшенной архитектуры модели.
2. Flash Attention
Современные высокопроизводительные LLM в целом используют одну и ту же базовую архитектуру, состоящую из полносвязных слоёв, слоёв активации, слоёв нормализации по слоям и, что наиболее важно, слоёв само-внимания.
Слои self-attention играют центральную роль в больших языковых моделях (LLM), поскольку они позволяют модели понимать контекстуальные связи между входными токенами. Однако пиковое потребление памяти GPU для слоёв self-attention растёт квадратично как по вычислительной, так и по памяти сложности с количеством входных токенов (также называемых длиной последовательности) , которую в дальнейшем мы обозначаем как . Хотя для коротких входных последовательностей (до 1000 входных токенов) это не так заметно, для более длинных входных последовательностей (около 16000 входных токенов) это становится серьёзной проблемой.
Рассмотрим подробнее. Формула для вычисления выходного значения слоя self-attention для входных данных длиной имеет вид:
является входной последовательностью для слоя внимания. Проекции и будут состоять из векторов, что приводит к тому, что имеет размер .
LLM обычно имеют несколько головок внимания, поэтому выполняют несколько вычислений само-внимания параллельно. Допустим, LLM имеет 40 головок внимания и работает с точностью bfloat16, тогда мы можем рассчитать объём памяти, необходимый для хранения матриц, который составляет байт. Для нужно всего около 50 МБ видеопамяти, однако для потребуется 19 ГБ видеопамяти, а для потребуется почти 1 ТБ только для хранения матриц.
Коротко: алгоритм само-внимания по умолчанию быстро становится неприемлемо затратным по памяти для больших входных контекстов.
По мере того, как LLM становятся лучше в понимании и генерации текста, их применяют для всё более сложных задач. Если раньше модели справлялись с переводом или суммаризацией нескольких предложений, то теперь они обрабатывают целые страницы, что требует способности работать с длинными входными последовательностями.
Как нам избавиться от чрезмерных требований к памяти при больших длинах входных последовательностей? Нам нужен новый способ вычисления механизма self-attention, который позволяет избежать формирования матрицы матрицы. Tri Dao и соавт. разработали именно такой новый алгоритм и назвали его Flash Attention.
Короче говоря, Flash Attention разделяет вычисление и вместо этого вычисляет небольшие фрагменты вывода, итерируя несколько шагов вычисления softmax:
где и являются некоторыми статистиками нормализации softmax, которые необходимо пересчитывать для каждого и .
Обратите внимание, что весь механизм Flash Attention несколько сложнее и здесь сильно упрощён, поскольку углублённое рассмотрение выходит за рамки данного руководства. Читателю предлагается ознакомиться с хорошо написанной статьей о Flash Attention для получения дополнительных деталей.
Главный вывод здесь:
Отслеживая статистику нормализации softmax и применяя ряд математических приёмов, Flash Attention обеспечивает численно идентичные результаты по сравнению со стандартным слоем self-attention при затратах памяти, которые растут лишь линейно с .
Судя по формуле, можно интуитивно предположить, что Flash Attention должен работать значительно медленнее по сравнению с формулой стандартного self-attention, так как требуется выполнить больше вычислений. Действительно, Flash Attention требует больше FLOPs по сравнению с обычным attention, поскольку статистика нормализации softmax должна постоянно пересчитываться (см. статью для получения дополнительных деталей, если интересно)
Однако Flash Attention значительно быстрее при инференсе по сравнению со стандартным attention, что обусловлено его способностью существенно снижать нагрузку на более медленную память GPU с высокой пропускной способностью (VRAM), переключая фокус на более быструю память на чипе (SRAM).
По сути, Flash Attention обеспечивает выполнение всех промежуточных операций записи и чтения с использованием быстрой встроенной в чип памяти SRAM, а не медленной памяти VRAM, для вычисления выходного вектора .
На практике на данный момент нет абсолютно никаких причин не использовать Flash Attention, если он доступен. Алгоритм дает математически идентичные результаты, при этом он быстрее и эффективнее с точки зрения использования памяти.
3. Архитектурные инновации
До сих пор мы рассматривали способы повышения вычислительной и энергетической эффективности, а именно:
- Преобразование весов в формат с меньшей точностью
- Замена алгоритма само-внимания на более эффективную по памяти и вычислениям версию
Теперь рассмотрим, как можно изменить архитектуру LLM, чтобы сделать её максимально эффективной и производительной для задач, требующих длинных входных текстов, например:
- Вопросно-ответная система с расширением за счёт поиска,
- Суммаризация,
- Чат
Обратите внимание, что chat требует от LLM не только обработки длинных текстовых входных данных, но и эффективного ведения диалога между пользователем и ассистентом (например, как в ChatGPT).
После обучения базовую архитектуру LLM сложно изменить, поэтому важно заранее продумать задачи, которые должна решать LLM, и в соответствии с этим оптимизировать архитектуру модели. В архитектуре модели есть два важных компонента, которые при работе с длинными входными последовательностями быстро становятся узким местом по памяти и/или производительности.
- Позиционные эмбеддинги
- Кэш ключей и значений
Рассмотрим каждый компонент подробнее
3.1 Улучшение позиционных эмбеддингов LLM
Механизм self-attention устанавливает связи между каждым токеном и остальными токенами. Например, матрица для входной последовательности текста “«Hello», «I», «love», «you» может выглядеть следующим образом:

Каждому токену слова присваивается вероятность, с которой он обращается ко всем остальным токенам слов, и тем самым устанавливает связь со всеми остальными токенами слов. Например, слово «love» обращается к слову «Hello» с вероятностью 5%, к «I» — с вероятностью 30%, и к самому себе — с вероятностью 65%.
A LLM based on self-attention, but without position embeddings would have great difficulties in understanding the positions of the text inputs to each other. This is because the probability score computed by relates each word token to each other word token in computations regardless of their relative positional distance to each other. Therefore, for the LLM without position embeddings each token appears to have the same distance to all other tokens, e.g. differentiating between “Hello I love you” and “You love I hello” would be very challenging.
Чтобы LLM понимала порядок слов в предложении, требуется дополнительный сигнал, который обычно реализуется в виде позиционных кодировок (также называемых позиционными эмбеддингами). Позиционные кодировки кодируют позицию каждого токена в числовое представление, которое LLM может использовать для более точного понимания порядка слов в предложении.
Авторы статьи Attention Is All You Need предложили синусоидальные позиционные эмбеддинги . где каждый вектор вычисляется как синусоидальная функция его позиции . Затем позиционные кодировки просто прибавляются к векторам входной последовательности = чтобы подсказать модели правильный порядок слов в предложении.
Вместо использования фиксированных позиционных эмбеддингов другие (например, Devlin et al.) использовали обучаемые позиционные кодировки, для которых позиционные эмбеддинги обучаются в процессе тренировки.
Синусоидальные и обучаемые позиционные эмбеддинги долгое время были основными методами кодирования порядка слов в LLM, однако было выявлено несколько проблем, связанных с этими позиционными кодировками:
- Синусоидальные и обучаемые позиционные эмбеддинги являются абсолютными позиционными эмбеддингами, i.e. то есть кодируют уникальное эмбеддинг для каждого идентификатора позиции: . Как показано Huang et al. и Su et al., абсолютные позиционные эмбеддинги приводят к низкой производительности LLM при работе с длинными текстовыми входами. Для длинных текстовых входов предпочтительнее, чтобы модель обучалась относительному позиционному расстоянию между входными токенами, а не их абсолютному положению.
- При использовании обучаемых позиционных эмбеддингов LLM необходимо обучать на фиксированной длине входа $N$, что затрудняет экстраполяцию на длину входа, превышающую ту, на которой модель обучалась.
Недавно стали более популярными относительные позиционные эмбеддинги, способные решить вышеупомянутые проблемы, в частности:
Оба RoPE и ALiBi утверждают, что лучше всего указывать LLM порядок предложений непосредственно в алгоритме само-внимания, поскольку именно там токены слов связываются друг с другом. Более конкретно, порядок предложений должен указываться путем модификации вычисления.
Не вдаваясь в излишние подробности, RoPE отмечает, что позиционная информация может быть закодирована в пары запрос-ключ, e.g. и путём поворота каждого вектора на угол и соответственно, где описывает позиционное место каждого вектора в предложении:
представляет собой матрицу поворота. не обучается во время обучения, а задаётся заранее определённым значением, которое зависит от максимальной длины входной последовательности при обучении.
Таким образом, вероятностная оценка между и изменяется только если и зависит исключительно от относительного расстояния независимо от конкретных позиций каждого вектора и .
RoPE используется в нескольких из самых важных LLM на сегодняшний день, таких как:
В качестве альтернативы ALiBi предлагает гораздо более простую схему кодирования относительных позиций. Относительное расстояние между входными токенами добавляется в виде отрицательного целого числа, масштабированного заранее определённым значением m к каждой записи query-key в матрице непосредственно перед вычислением softmax.
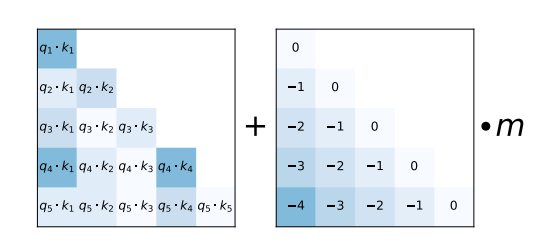
Как показано в статье ALiBi, это простое относительное позиционное кодирование позволяет модели сохранять высокую производительность даже на очень длинных входных последовательностях текста.
ALiBi используется во многих из самых важных LLM на сегодняшний день, таких как:
Оба RoPE и ALiBi позволяют экстраполировать на длины входных данных, не встречавшиеся во время обучения, при этом было показано, что экстраполяция из коробки работает значительно лучше для ALiBi по сравнению с RoPE. Для ALiBi достаточно просто увеличить значения нижнетреугольной матрицы позиций, чтобы они соответствовали длине входной последовательности. Для RoPE, сохранение того же , который использовался во время обучения, приводит к плохим результатам при обработке текстовых входных данных, значительно более длинных, чем те, что встречались во время обучения, c.f Press et al.. Однако сообщество нашло несколько эффективных приёмов, адаптирующих $\theta$, что позволяет RoPE позиционным эмбеддингам хорошо работать для экстраполированных входных последовательностей текста (см. здесь).
RoPE и ALiBi — это относительные позиционные эмбеддинги, которые не обучаются в процессе обучения, а основаны на следующих интуициях:
- Позиционные сигналы о текстовых входных данных должны передаваться непосредственно в матрицу слоя self-attention.
- LLM должна поощряться к обучению константного относительного позиционного кодирования.
- Чем дальше друг от друга расположены токены входного текста, тем ниже вероятность их query-value. И RoPE, и ALiBi снижают вероятность query-key для токенов, находящихся далеко друг от друга. RoPE делает это, уменьшая их скалярное произведение за счёт увеличения угла между векторами query и key. ALiBi снижает вероятность, прибавляя к скалярному произведению большие отрицательные числа.
Подводя итог, LLM, предназначенные для задач, требующих обработки больших текстовых входных данных, лучше обучать с использованием относительных позиционных эмбеддингов, таких как RoPE и ALiBi. Также обратите внимание, что даже если LLM с RoPE и ALiBi обучалась только на фиксированной длине, например она всё равно может использоваться на практике с текстовыми входными данными, значительно превышающими $N_1$, например $N_2 = 8192 > N_1$, за счёт экстраполяции позиционных эмбеддингов.
3.2 Кэш ключей и значений
Авто-регрессивная генерация текста с помощью LLM работает за счёт итеративного ввода входной последовательности, выборки следующего токена, добавления этого токена к входной последовательности и продолжения этого процесса, пока LLM не сгенерирует токен, сигнализирующий об окончании генерации.
Ознакомьтесь с руководством по генерации текста в Transformers, чтобы нагляднее понять, как работает авто-регрессивная генерация.
Давайте выполним короткий фрагмент кода, чтобы показать, как на практике работает авто-регрессивное генерирование. Мы просто возьмём наиболее вероятный следующий токен с помощью torch.argmax.
input_ids = tokenizer(prompt, return_tensors="pt")["input_ids"].to(model.device)

for _ in range(5):
  next_logits = model(input_ids)["logits"][:, -1:]
  next_token_id = torch.argmax(next_logits,dim=-1)

  input_ids = torch.cat([input_ids, next_token_id], dim=-1)
  print("shape of input_ids", input_ids.shape)

generated_text = tokenizer.batch_decode(input_ids[:, -5:])
generated_textРезультат:
shape of input_ids torch.Size([1, 21])
shape of input_ids torch.Size([1, 22])
shape of input_ids torch.Size([1, 23])
shape of input_ids torch.Size([1, 24])
shape of input_ids torch.Size([1, 25])
[' Here is a Python function']
Как мы видим, каждый раз мы увеличиваем входные токены текста на только что сэмплированный токен.
За редким исключением, LLM обучаются с использованием цели каузального языкового моделирования и поэтому маскируют верхний треугольник матрицы оценок внимания — именно поэтому на двух диаграммах выше оценки внимания оставлены пустыми (то есть имеют вероятность 0). Для краткого повторения каузального языкового моделирования можно обратиться к блогу Illustrated Self Attention.
Вследствие этого токены никогда не зависят от последующих токенов, а точнее, вектор никогда не связывается с какими-либо векторами ключей и значений при $j > i$. Вместо этого обращает внимание только на предыдущие векторы ключей и значений $\mathbf{k}{m < i}, \mathbf{v}{m < i} \text{ , для } m \in {0, \ldots i - 1}$. Чтобы сократить ненужные вычисления, можно кэшировать векторы ключей и значений каждого слоя для всех предыдущих временных шагов.
Далее мы будем указывать LLM использовать кэш ключей и значений, извлекая его и передавая на каждом проходе вперед.
В Transformers мы можем извлечь кэш ключей и значений, передав флаг use_cache в вызов forward, а затем передать его вместе с текущим токеном.
past_key_values = None # past_key_values is the key-value cache
generated_tokens = []
next_token_id = tokenizer(prompt, return_tensors="pt")["input_ids"].to(model.device)

for _ in range(5):
  next_logits, past_key_values = model(next_token_id, past_key_values=past_key_values, use_cache=True).to_tuple()
  next_logits = next_logits[:, -1:]
  next_token_id = torch.argmax(next_logits, dim=-1)

  print("shape of input_ids", next_token_id.shape)
  print("length of key-value cache", past_key_values.get_seq_length())  # past_key_values are of shape [num_layers, 0 for k, 1 for v, batch_size, length, hidden_dim]
  generated_tokens.append(next_token_id.item())

generated_text = tokenizer.batch_decode(generated_tokens)
generated_textРезультат:
shape of input_ids torch.Size([1, 1])
length of key-value cache 20
shape of input_ids torch.Size([1, 1])
length of key-value cache 21
shape of input_ids torch.Size([1, 1])
length of key-value cache 22
shape of input_ids torch.Size([1, 1])
length of key-value cache 23
shape of input_ids torch.Size([1, 1])
length of key-value cache 24
[' Here', ' is', ' a', ' Python', ' function']
Как видно, при использовании кэша ключей и значений токены текстового входа не увеличиваются в длине, а остаются единым входным вектором. Длина кэша ключей и значений, в свою очередь, увеличивается на единицу на каждом шаге декодирования.
Использование кэша ключей и значений означает, что по сути сводится к где является проекцией запроса для текущего входного токена, которая всегда представляет собой всего один вектор.
Использование кэша ключей и значений имеет два преимущества:
- Значительное повышение вычислительной эффективности, так как выполняется меньше вычислений по сравнению с полным вычислением матрицы. Это приводит к увеличению скорости инференса
- Максимальный требуемый объём памяти не возрастает квадратично с числом сгенерированных токенов, а увеличивается только линейно.
Всегда следует использовать кэш ключей и значений, так как это обеспечивает идентичные результаты и значительное ускорение для длинных входных последовательностей. В Transformers кэш ключей и значений включён по умолчанию при использовании текстового конвейера или метода
generate. У нас есть отдельное руководство, посвящённое кэшированию, здесь.
Обратите внимание, что, несмотря на нашу рекомендацию использовать кэши ключей и значений, вывод вашей LLM может немного отличаться при их использовании. Это свойство самих ядер матричного умножения — подробнее об этом можно прочитать здесь.
3.2.1 Многократный диалог
Кэш ключей и значений особенно полезен для таких приложений, как чат, где требуется несколько проходов авто-регрессивного декодирования. Рассмотрим пример.
User: How many people live in France?
Assistant: Roughly 75 million people live in France
User: And how many are in Germany?
Assistant: Germany has ca. 81 million inhabitants
В этом чате LLM выполняет авто-регрессивное декодирование дважды:
- В первый раз кэш ключей и значений пуст, входной промпт —
"User: How many people live in France?", а модель авто-регрессивно генерирует текст"Roughly 75 million people live in France", увеличивая кэш ключей и значений на каждом шаге декодирования. - Во второй раз входной промпт —
"User: How many people live in France? \n Assistant: Roughly 75 million people live in France \n User: And how many in Germany?". Благодаря кэшу все ключевые и значения векторы для первых двух предложений уже вычислены. Поэтому входной промпт состоит только из"User: And how many in Germany?". Во время обработки сокращённого входного промпта его вычисленные ключевые и значения векторы конкатенируются с кэшем ключей и значений первого декодирования. Затем второй ответ Assistant"Germany has ca. 81 million inhabitants"генерируется авто-регрессивно с использованием кэша ключей и значений, состоящего из закодированных ключевых и значений векторов"User: How many people live in France? \n Assistant: Roughly 75 million people live in France \n User: And how many are in Germany?".
Здесь стоит отметить две вещи:
- Сохранение всего контекста имеет решающее значение для LLM, используемых в чатах, чтобы модель понимала весь предыдущий контекст разговора. Например, в приведённом выше примере LLM должна понимать, что пользователь имеет в виду население, когда задаёт вопрос
"And how many are in Germany". - Кэш ключей и значений крайне полезен для чатов, поскольку позволяет непрерывно наращивать закодированную историю диалога, а не перекодировать её с нуля (как, например, в случае использования архитектуры «кодек-декодер»).
В transformers вызов generate возвращает past_key_values, если передан параметр return_dict_in_generate=True в дополнение к параметру use_cache=True по умолчанию. Обратите внимание, что эта функция пока недоступна через интерфейс pipeline.
# Generation as usual
prompt = system_prompt + "Question: Please write a function in Python that transforms bytes to Giga bytes.\n\nAnswer: Here"
model_inputs = tokenizer(prompt, return_tensors='pt')
generation_output = model.generate(**model_inputs, max_new_tokens=60, return_dict_in_generate=True)
decoded_output = tokenizer.batch_decode(generation_output.sequences)[0]

# Piping the returned `past_key_values` to speed up the next conversation round
prompt = decoded_output + "\nQuestion: How can I modify the function above to return Mega bytes instead?\n\nAnswer: Here"
model_inputs = tokenizer(prompt, return_tensors='pt')
generation_output = model.generate(
  **model_inputs,
  past_key_values=generation_output.past_key_values,
  max_new_tokens=60,
  return_dict_in_generate=True
)
tokenizer.batch_decode(generation_output.sequences)[0][len(prompt):]Результат:
 is a modified version of the function that returns Mega bytes instead.

def bytes_to_megabytes(bytes):
   return bytes / 1024 / 1024

Answer: The function takes a number of bytes as input and returns the number of
Отлично, дополнительное время на пересчёт одних и тех же ключей и значений для слоя внимания не тратится! Однако есть одна оговорка. Хотя пиковая память, необходимая для матрицы, значительно сокращается, хранение кэша ключей и значений в памяти может стать очень затратным по памяти для длинных входных последовательностей или многоходового чата. Помните, что кэш ключей и значений должен хранить векторы ключей и значений для всех предыдущих входных векторов для всех слоёв само-внимания и для всех головок внимания.
Вычислим количество значений типа float, которые необходимо сохранить в кэше ключей и значений для LLM bigcode/octocoder, которую мы использовали ранее.
Количество значений типа float равно произведению двух, длины последовательности, количества головок внимания, размерности головки внимания и количества слоёв.
Вычисление этого значения для нашей LLM при гипотетической длине входной последовательности 16000 даёт:
config = model.config
2 * 16_000 * config.n_layer * config.n_head * config.n_embd // config.n_headРезультат:
7864320000
Около 8 миллиардов значений типа float! Хранение 8 миллиардов значений float в точности float16 требует примерно 15 ГБ оперативной памяти, что составляет около половины от размера самих весов модели!
Исследователи предложили два метода, позволяющих значительно снизить затраты памяти на хранение кэша ключей и значений, которые рассматриваются в следующих подразделах.
3.2.2 Multi-Query-Attention (MQA)
Multi-Query-Attention был предложен в статье Noam Shazeer Fast Transformer Decoding: One Write-Head is All You Need. Как следует из названия, Noam обнаружил, что вместо использования весов проекций ключей и значений для n_head можно использовать одну пару весов проекции ключа и значения, общую для всех головок внимания, без значительного снижения производительности модели.
Используя одну пару весов проекции head-value, векторы ключей и значений должны быть идентичными для всех головок внимания, что означает, что в кэше нужно хранить только одну пару проекций ключ-значение вместо
n_headпар.
Поскольку большинство LLM используют от 20 до 100 головок внимания, MQA значительно снижает потребление памяти кэш-памятью ключей и значений. Для LLM, используемой в этом ноутбуке, это позволяет сократить требуемое потребление памяти с 15 ГБ до менее чем 400 МБ при длине входной последовательности 16000.
Помимо экономии памяти, MQA также повышает вычислительную эффективность, что объясняется ниже. При авто-регрессивном декодировании большие векторы ключей и значений необходимо повторно загружать, конкатенировать с текущей парой векторов ключа и значения, а затем передавать в вычисление на каждом шаге. При авто-регрессивном декодировании требуемая пропускная способность памяти для постоянного повторного чтения может стать серьезным узким местом по времени. За счет уменьшения размера векторов ключей и значений требуется обращаться к меньшему объему памяти, что снижает узкое место пропускной способности памяти. Более подробную информацию см. в статье Ноама.
Важно понимать, что сокращение числа ключевых и value-голов внимания до 1 имеет смысл только при использовании кэша ключей и значений. Пиковое потребление памяти модели за один прямой проход без кэша ключей и значений остаётся неизменным, поскольку у каждой головы внимания по-прежнему есть уникальный вектор запроса, и каждая голова внимания по-прежнему имеет разную матрицу.
MQA получил широкое распространение в сообществе и сейчас используется во многих самых популярных LLM:
Также контрольная точка, используемая в этом ноутбуке — bigcode/octocoder — использует MQA.
3.2.3 Grouped-Query-Attention (GQA)
Grouped-Query-Attention, предложенная Айнсли и соавторами из Google, показала, что использование MQA часто приводит к ухудшению качества по сравнению с использованием стандартных проекций нескольких ключевых и value-голов. В статье утверждается, что сохранить производительность модели можно, менее радикально сокращая количество весов проекций query-голов. Вместо использования всего одного набора весов проекции key-value следует использовать n < n_head наборов весов проекции key-value. Выбрав n значительно меньшим, чем n_head, например 2, 4 или 8, можно сохранить почти все преимущества MQA в плане памяти и скорости, пожертвовав при этом меньшей ёмкостью модели и, следовательно, меньшей производительностью.
Более того, авторы GQA выяснили, что существующие контрольные точки моделей можно дообучить до архитектуры GQA, затратив всего 5% вычислительных ресурсов исходного предобучения. Хотя 5% исходных вычислительных ресурсов предобучения всё ещё могут составлять значительный объём, дообучение GQA позволяет использовать существующие контрольные точки для более длинных входных последовательностей.
GQA был предложен совсем недавно, поэтому на момент написания этого ноутбука его применение еще не получило широкого распространения. Самым примечательным применением GQA является Llama-v2.
В качестве вывода настоятельно рекомендуется использовать GQA или MQA, если LLM развернута с авто-регрессивным декодированием и должна обрабатывать длинные входные последовательности, как, например, в чат-приложениях.
Заключение
Исследовательское сообщество постоянно предлагает новые, изящные способы ускорения времени вывода для всё более крупных LLM. В качестве примера, одним из перспективных направлений исследований является speculative decoding, при котором «простые токены» генерируются более маленькими и быстрыми языковыми моделями, а «сложные токены» — самой LLM. Более подробное описание выходит за рамки данного ноутбука, но с ним можно ознакомиться в этой хорошей статье в блоге.
Причина, по которой крупные LLM, такие как GPT3/4, Llama-2-70b, Claude, PaLM, работают так быстро в чат-интерфейсах, как Hugging Face Chat или ChatGPT, во многом заключается в упомянутых выше улучшениях точности, алгоритмов и архитектуры. В дальнейшем ускорители, такие как GPU, TPU и т. д., будут становиться только быстрее и поддерживать больший объём памяти, однако всё равно следует всегда использовать лучшие доступные алгоритмы и архитектуры, чтобы получить максимальную отдачу от вложенных средств 🤗
Update on GitHub