# CLIPSeg
## Обзор
Модель CLIPSeg была предложена в работе [Image Segmentation Using Text and Image Prompts](https://huggingface.co/papers/2112.10003) Тимо Люддеке и Александра Эккера. CLIPSeg добавляет минимальный декодер поверх замороженной модели [CLIP](clip) для сегментации изображений в режимах zero-shot и one-shot.
Аннотация из статьи следующая:
*Сегментация изображений обычно решается путём обучения модели для фиксированного набора классов объектов. Добавление дополнительных классов или более сложных запросов на поздних этапах обходится дорого, поскольку требует переобучения модели на датасете, охватывающем эти выражения. Здесь мы предлагаем систему, способную генерировать сегментации изображений на основе произвольных промптов во время тестирования. Промптом может быть текст или изображение. Такой подход позволяет создать единую модель (обученную один раз) для трёх распространённых задач сегментации, каждая из которых несёт в себе особые сложности: сегментация по указывающим выражениям, сегментация в режиме zero-shot и сегментация в режиме one-shot. Мы используем модель CLIP в качестве базовой архитектуры, расширяя её трансформерным декодером, который обеспечивает плотное предсказание. После обучения на расширенной версии датасета PhraseCut наша система генерирует бинарную карту сегментации для изображения на основе промпта в виде свободного текста или дополнительного изображения, выражающего запрос. Мы подробно анализируем различные варианты последних, то есть изображений, используемых в качестве промптов. Этот новый гибридный вход позволяет динамически адаптироваться не только к трём упомянутым выше задачам сегментации, но и к любой бинарной задаче сегментации, для которой можно сформулировать текстовый или визуальный запрос. Наконец, мы обнаруживаем, что наша система хорошо адаптируется к обобщённым запросам, связанным с affordances или свойствами*
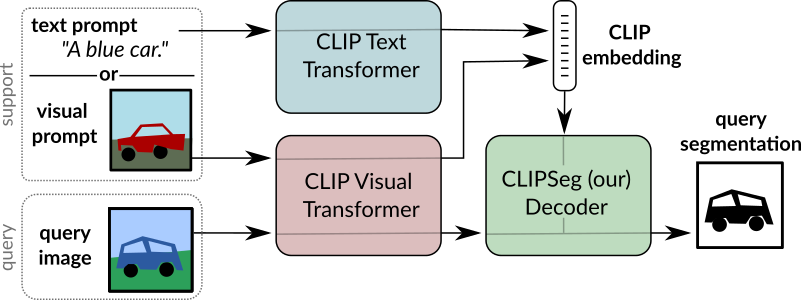 Обзор CLIPSeg. Взято из оригинальной статьи.
Эта модель была предоставлена пользователем [nielsr](https://huggingface.co/nielsr). Исходный код можно найти [здесь](https://github.com/timojl/clipseg).
## Советы по использованию
- [CLIPSegForImageSegmentation](/docs/transformers/v5.23.0/ru/model_doc/clipseg#transformers.CLIPSegForImageSegmentation) добавляет декодер поверх [CLIPSegModel](/docs/transformers/v5.23.0/ru/model_doc/clipseg#transformers.CLIPSegModel). Последний идентичен [CLIPModel](/docs/transformers/v5.23.0/ru/model_doc/clip#transformers.CLIPModel).
- [CLIPSegForImageSegmentation](/docs/transformers/v5.23.0/ru/model_doc/clipseg#transformers.CLIPSegForImageSegmentation) может генерировать сегментации изображений на основе произвольных промптов во время тестирования. Промпт может быть текстом
(предоставляется модели в виде `input_ids`) или изображение (предоставляется модели в виде `conditional_pixel_values`). Также можно предоставить пользовательские условные эмбеддинги (предоставляются модели в виде `conditional_embeddings`).
## Ресурсы
Список официальных ресурсов Hugging Face и сообщества (отмечены 🌎), которые помогут вам начать работу с CLIPSeg. Если вы хотите предложить ресурс для включения в этот список, пожалуйста, создайте Pull Request, и мы его рассмотрим! В идеале ресурс должен демонстрировать что-то новое, а не дублировать существующие материалы.
- Ноутбук, демонстрирующий [zero-shot сегментацию изображений с помощью CLIPSeg](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/CLIPSeg/Zero_shot_image_segmentation_with_CLIPSeg.ipynb).
## CLIPSegConfig[[transformers.CLIPSegConfig]]
#### transformers.CLIPSegConfig[[transformers.CLIPSegConfig]]
```python
transformers.CLIPSegConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, text_config: dict | transformers.models.clipseg.configuration_clipseg.CLIPSegTextConfig | None = None, vision_config: dict | transformers.models.clipseg.configuration_clipseg.CLIPSegVisionConfig | None = None, projection_dim: int | None = 512, logit_scale_init_value: float | int | None = 2.6592, initializer_factor: float | None = 1.0, extract_layers: list[int] | tuple[int, ...] = (3, 6, 9), reduce_dim: int = 64, decoder_num_attention_heads: int = 4, decoder_attention_dropout: float | int = 0.0, decoder_hidden_act: str = 'quick_gelu', decoder_intermediate_size: int = 2048, conditional_layer: int = 0, use_complex_transposed_convolution: bool = False)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/configuration_clipseg.py#L124)
**Параметры:**
text_config (`Union[dict, ~models.clipseg.configuration_clipseg.CLIPSegTextConfig]`, *необязательный*) : Объект конфигурации или словарь текстового бэкбона.
vision_config (`Union[dict, ~models.clipseg.configuration_clipseg.CLIPSegVisionConfig]`, *optional*) : Объект конфигурации или словарь для визуального бэкбона.
projection_dim (`int`, *optional*, по умолчанию `512`) : Размерность проекционных слоёв для текста и изображений.
logit_scale_init_value (`Union[float, int]`, *необязательный*, по умолчанию `2.6592`) : Начальное значение параметра *logit_scale*.
initializer_factor (`float`, *необязательный*, по умолчанию `1.0`) : Коэффициент для инициализации всех матриц весов (должен оставаться равным 1, используется внутренне для тестирования инициализации).
extract_layers (`list[int]`, *необязательный*, по умолчанию `[3, 6, 9]`) : Слои, из которых извлекаются признаки при пропускании изображения-запроса через замороженный визуальный бэкбон CLIP.
reduce_dim (`int`, *optional*, по умолчанию 64) : Размерность, до которой нужно уменьшить CLIP vision embedding.
decoder_num_attention_heads (`int`, *необязательный*, по умолчанию `4`) : Количество головок внимания для каждого слоя внимания в декодере Transformer.
decoder_attention_dropout (`Union[float, int]`, *необязательный*, по умолчанию `0.0`) : Коэффициент dropout для вероятностей внимания.
decoder_hidden_act (`str`, *необязательный*, по умолчанию `quick_gelu`) : Нелинейная функция активации (функция или строка) в декодере. Например, `"gelu"`, `"relu"`, `"silu"` и т. д.
decoder_intermediate_size (`int`, *необязательный*, по умолчанию `2048`) : Размерность представлений MLP.
conditional_layer (`int`, *optional*, по умолчанию 0) : Слой кодировщика Transformer, активации которого будут объединены с эмбеддингами условия с помощью FiLM (Feature-wise Linear Modulation). Если указано 0, используется последний слой.
use_complex_transposed_convolution (`bool`, *необязательный*, по умолчанию `False`) : Использовать ли более сложную транспонированную свёртку в декодере, что позволяет выполнять более детальную сегментацию.
Это класс конфигурации для хранения настроек модели CLIPSegModel. Он используется для создания модели Clipseg в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации [CIDAS/clipseg-rd64](https://huggingface.co/CIDAS/clipseg-rd64)
Объекты конфигурации наследуются от [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig) и могут использоваться для управления выводами модели. Подробнее см. в документации [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig).
Пример:
```python
>>> from transformers import CLIPSegConfig, CLIPSegModel
>>> # Initializing a CLIPSegConfig with CIDAS/clipseg-rd64 style configuration
>>> configuration = CLIPSegConfig()
>>> # Initializing a CLIPSegModel (with random weights) from the CIDAS/clipseg-rd64 style configuration
>>> model = CLIPSegModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
>>> # We can also initialize a CLIPSegConfig from a CLIPSegTextConfig and a CLIPSegVisionConfig
>>> # Initializing a CLIPSegText and CLIPSegVision configuration
>>> config_text = CLIPSegTextConfig()
>>> config_vision = CLIPSegVisionConfig()
>>> config = CLIPSegConfig(text_config=config_text, vision_config=config_vision)
```
## CLIPSegTextConfig[[transformers.CLIPSegTextConfig]]
#### transformers.CLIPSegTextConfig[[transformers.CLIPSegTextConfig]]
```python
transformers.CLIPSegTextConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 49408, hidden_size: int = 512, intermediate_size: int = 2048, num_hidden_layers: int = 12, num_attention_heads: int = 8, max_position_embeddings: int = 77, hidden_act: str = 'quick_gelu', layer_norm_eps: float | None = 1e-05, attention_dropout: int | float | None = 0.0, initializer_range: float = 0.02, initializer_factor: float | None = 1.0, pad_token_id: int | None = 1, bos_token_id: int | None = 49406, eos_token_id: int | list[int] | None = 49407)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/configuration_clipseg.py#L31)
**Параметры:**
vocab_size (`int`, *необязательный*, по умолчанию `49408`) : Размер словаря модели. Определяет количество различных токенов, которые могут быть представлены в `input_ids`.
hidden_size (`int`, *необязательный*, по умолчанию `512`) : Размерность скрытых представлений.
intermediate_size (`int`, *необязательный*, по умолчанию `2048`) : Размерность представлений MLP.
num_hidden_layers (`int`, *необязательный*, по умолчанию `12`) : Количество скрытых слоев в декодере Transformer.
num_attention_heads (`int`, *необязательный*, по умолчанию `8`) : Количество головок внимания для каждого слоя внимания в декодере Transformer.
max_position_embeddings (`int`, *необязательный*, по умолчанию `77`) : Максимальная длина последовательности, с которой может использоваться эта модель.
hidden_act (`str`, *необязательный*, по умолчанию `quick_gelu`) : Нелинейная функция активации (функция или строка) в декодере. Например, `"gelu"`, `"relu"`, `"silu"` и т. д.
layer_norm_eps (`float`, *необязательный*, по умолчанию `1e-05`) : Значение epsilon, используемое слоями нормализации.
attention_dropout (`Union[int, float]`, *необязательный*, по умолчанию `0.0`) : Доля dropout для вероятностей внимания.
initializer_range (`float`, *необязательный*, по умолчанию `0.02`) : Стандартное отклонение truncated_normal_initializer для инициализации всех матриц весов.
initializer_factor (`float`, *необязательный*, по умолчанию `1.0`) : Коэффициент для инициализации всех матриц весов (должен оставаться равным 1, используется внутренне для тестирования инициализации).
pad_token_id (`int`, *необязательный*, по умолчанию `1`) : Идентификатор токена, используемый для выравнивания в словаре.
bos_token_id (`int`, *необязательный*, по умолчанию `49406`) : Идентификатор токена, используемый для обозначения начала потока в словаре.
eos_token_id (`Union[int, list[int]]`, *необязательный*, по умолчанию `49407`) : Идентификатор токена, используемый для обозначения конца потока в словаре.
Это класс конфигурации для хранения настроек модели CLIPSegModel. Он используется для создания модели Clipseg в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации [CIDAS/clipseg-rd64](https://huggingface.co/CIDAS/clipseg-rd64)
Объекты конфигурации наследуются от [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig) и могут использоваться для управления выводами модели. Подробнее см. в документации [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig).
Пример:
```python
>>> from transformers import CLIPSegTextConfig, CLIPSegTextModel
>>> # Initializing a CLIPSegTextConfig with CIDAS/clipseg-rd64 style configuration
>>> configuration = CLIPSegTextConfig()
>>> # Initializing a CLIPSegTextModel (with random weights) from the CIDAS/clipseg-rd64 style configuration
>>> model = CLIPSegTextModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## CLIPSegVisionConfig[[transformers.CLIPSegVisionConfig]]
#### transformers.CLIPSegVisionConfig[[transformers.CLIPSegVisionConfig]]
```python
transformers.CLIPSegVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, intermediate_size: int = 3072, num_hidden_layers: int = 12, num_attention_heads: int = 12, num_channels: int = 3, image_size: int | list[int] | tuple[int, int] | None = 224, patch_size: int | list[int] | tuple[int, int] | None = 32, hidden_act: str = 'quick_gelu', layer_norm_eps: float = 1e-05, attention_dropout: int | float | None = 0.0, initializer_range: float = 0.02, initializer_factor: float = 1.0)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/configuration_clipseg.py#L80)
**Параметры:**
hidden_size (`int`, *optional*, по умолчанию `768`) : Размерность скрытых представлений.
intermediate_size (`int`, *optional*, по умолчанию `3072`) : Размерность представлений MLP.
num_hidden_layers (`int`, *необязательный*, по умолчанию `12`) : Количество скрытых слоев в декодере Transformer.
num_attention_heads (`int`, *необязательный*, по умолчанию `12`) : Количество головок внимания для каждого слоя внимания в декодере Transformer.
num_channels (`int`, *необязательный*, по умолчанию `3`) : Количество входных каналов.
image_size (`Union[int, list[int], tuple[int, int]]`, *необязательный*, по умолчанию `224`) : Размер (разрешение) каждого изображения.
patch_size (`Union[int, list[int], tuple[int, int]]`, *необязательный*, по умолчанию `32`) : Размер (разрешение) каждого патча.
hidden_act (`str`, *необязательный*, по умолчанию `quick_gelu`) : Нелинейная функция активации (функция или строка) в декодере. Например, `"gelu"`, `"relu"`, `"silu"` и т. д.
layer_norm_eps (`float`, *необязательный*, по умолчанию `1e-05`) : Значение epsilon, используемое слоями нормализации.
attention_dropout (`Union[int, float]`, *необязательный*, по умолчанию `0.0`) : Доля dropout для вероятностей внимания.
initializer_range (`float`, *необязательный*, по умолчанию `0.02`) : Стандартное отклонение truncated_normal_initializer для инициализации всех матриц весов.
initializer_factor (`float`, *необязательный*, по умолчанию `1.0`) : Коэффициент для инициализации всех матриц весов (должен оставаться равным 1, используется внутренне для тестирования инициализации).
Это класс конфигурации для хранения настроек модели CLIPSegModel. Он используется для создания модели Clipseg в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации [CIDAS/clipseg-rd64](https://huggingface.co/CIDAS/clipseg-rd64)
Объекты конфигурации наследуются от [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig) и могут использоваться для управления выводами модели. Подробнее см. в документации [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig).
Пример:
```python
>>> from transformers import CLIPSegVisionConfig, CLIPSegVisionModel
>>> # Initializing a CLIPSegVisionConfig with CIDAS/clipseg-rd64 style configuration
>>> configuration = CLIPSegVisionConfig()
>>> # Initializing a CLIPSegVisionModel (with random weights) from the CIDAS/clipseg-rd64 style configuration
>>> model = CLIPSegVisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## CLIPSegProcessor[[transformers.CLIPSegProcessor]]
#### transformers.CLIPSegProcessor[[transformers.CLIPSegProcessor]]
```python
transformers.CLIPSegProcessor(image_processor = None, tokenizer = None, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/processing_clipseg.py#L24)
**Параметры:**
image_processor (`ViTImageProcessor`) : процессор изображений является обязательным входным параметром.
tokenizer (`CLIPTokenizer`) : Токенизатор является обязательным входным параметром.
Создаёт CLIPSegProcessor, который объединяет процессор изображений и токенизатор в единый процессор.
[CLIPSegProcessor](/docs/transformers/v5.23.0/ru/model_doc/clipseg#transformers.CLIPSegProcessor) предоставляет все возможности [ViTImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/vit#transformers.ViTImageProcessor) и [CLIPTokenizer](/docs/transformers/v5.23.0/ru/model_doc/clip#transformers.CLIPTokenizer). Подробнее см. в документации [~ViTImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/vit#transformers.ViTImageProcessor) и [~CLIPTokenizer](/docs/transformers/v5.23.0/ru/model_doc/clip#transformers.CLIPTokenizer).
#### __call__[[transformers.CLIPSegProcessor.__call__]]
```python
__call__(text = None, images = None, visual_prompt = None, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/processing_clipseg.py#L28)
**Параметры:**
text (``) : The sequence or batch of sequences to be encoded. Each sequence can be a string or a list of strings (pretokenized string). If you pass a pretokenized input, set `is_split_into_words=True` to avoid ambiguity with batched inputs.
images (``) : Image to preprocess. Expects a single or batch of images with pixel values ranging from 0 to 255. If passing in images with pixel values between 0 and 1, set `do_rescale=False`.
visual_prompt (`PIL.Image.Image`, `np.ndarray`, `torch.Tensor`, `list[PIL.Image.Image]`, `list[np.ndarray]`, `list[torch.Tensor]`) : Изображение визуального промпта или пакет изображений для подготовки. Каждое изображение визуального промпта может быть изображением PIL, массивом NumPy или тензором PyTorch. В случае массива NumPy/тензора PyTorch каждое изображение должно иметь форму (C, H, W), где C — количество каналов, H и W — высота и ширина изображения.
return_tensors (`str` или [TensorType](/docs/transformers/v5.23.0/ru/internal/file_utils#transformers.TensorType), *optional*) : Если задано, возвращает тензоры конкретного фреймворка. Допустимые значения: - `'pt'`: возвращает объекты `torch.Tensor` PyTorch. - `'np'`: возвращает объекты `np.ndarray` NumPy.
**Возвращает:** [BatchEncoding](/docs/transformers/v5.23.0/ru/main_classes/tokenizer#transformers.BatchEncoding)
[BatchEncoding](/docs/transformers/v5.23.0/ru/main_classes/tokenizer#transformers.BatchEncoding) со следующими полями:
- **input_ids** -- Список идентификаторов токенов, передаваемых в модель. Возвращается, если `text` не равен `None`.
- **attention_mask** -- Список индексов, указывающих, на какие токены модель должна обращать внимание (когда `return_attention_mask=True` или если *"attention_mask"* входит в `self.model_input_names` и если `text` не равно `None`).
- **pixel_values** -- Значения пикселей, передаваемые в модель. Возвращается, если `images` не равно `None`.
## CLIPSegModel[[transformers.CLIPSegModel]]
#### transformers.CLIPSegModel[[transformers.CLIPSegModel]]
```python
transformers.CLIPSegModel(config: CLIPSegConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L783)
**Параметры:**
config ([CLIPSegConfig](/docs/transformers/v5.23.0/ru/model_doc/clipseg#transformers.CLIPSegConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Модель Clipseg без дополнительных слоёв, выводящая необработанные скрытые состояния.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.CLIPSegModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, return_loss: bool | None = None, interpolate_pos_encoding: bool = True, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L877)
**Параметры:**
input_ids (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательно*) : Индексы токенов входной последовательности в словаре. По умолчанию заполнение (padding) игнорируется. Индексы можно получить с помощью [AutoTokenizer](/docs/transformers/v5.23.0/ru/model_doc/auto#transformers.AutoTokenizer). Подробности см. в [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) и [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__). [Что такое входные идентификаторы?](../glossary#input-ids)
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`, *необязательно*) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [ViTImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/vit#transformers.ViTImageProcessor). Подробности см. в [ViTImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) ([CLIPSegProcessor](/docs/transformers/v5.23.0/ru/model_doc/clipseg#transformers.CLIPSegProcessor) использует [ViTImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/vit#transformers.ViTImageProcessor) для обработки изображений).
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
position_ids (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательно*) : Индексы позиций токенов каждого входного последовательности в позиционных эмбеддингах. Выбираются из диапазона `[0, config.n_positions - 1]`. [Что такое position IDs?](../glossary#position-ids)
return_loss (`bool`, *необязательный*) : Нужно ли возвращать контрастную потерю.
interpolate_pos_encoding (`bool`, *необязательный*, по умолчанию `True`) : Интерполировать ли предобученные позиционные кодирования.
**Возвращает:** `CLIPSegOutput` или `tuple(torch.Tensor)`
Объект `CLIPSegOutput` или кортеж из `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([CLIPSegConfig](/docs/transformers/v5.23.0/ru/model_doc/clipseg#transformers.CLIPSegConfig)) и входных данных.
Метод forward модели [CLIPSegModel](/docs/transformers/v5.23.0/ru/model_doc/clipseg#transformers.CLIPSegModel) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor` формы `(1,)`, *необязательный*, возвращается, если `return_loss` равно `True`) -- Контрастивная функция потерь для сходства изображения и текста.
- **logits_per_image** (`torch.Tensor` формы `(image_batch_size, text_batch_size)`) -- Оценки масштабированного скалярного произведения между `image_embeds` и `text_embeds`. Это представляет собой оценки сходства между изображением и текстом.
- **logits_per_text** (`torch.Tensor` формы `(text_batch_size, image_batch_size)`) -- Оценки масштабированного скалярного произведения между `text_embeds` и `image_embeds`. Это представляет собой оценки сходства между текстом и изображением.
- **text_embeds** (`torch.Tensor` формы `(batch_size, output_dim`) -- Векторы текста, полученные применением слоя проекции к агрегированному выводу [CLIPSegTextModel](/docs/transformers/v5.23.0/ru/model_doc/clipseg#transformers.CLIPSegTextModel).
- **image_embeds** (`torch.Tensor` формы `(batch_size, output_dim`) -- Векторные представления изображений, полученные применением слоя проекции к агрегированному выходу [CLIPSegVisionModel](/docs/transformers/v5.23.0/ru/model_doc/clipseg#transformers.CLIPSegVisionModel).
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *необязательный*) -- Выход [CLIPSegTextModel](/docs/transformers/v5.23.0/ru/model_doc/clipseg#transformers.CLIPSegTextModel).
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *необязательный*) -- Выход [CLIPSegVisionModel](/docs/transformers/v5.23.0/ru/model_doc/clipseg#transformers.CLIPSegVisionModel).
Примеры:
```python
>>> import torch
>>> from transformers import AutoProcessor, CLIPSegModel
>>> from transformers.image_utils import load_image
>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegModel.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(
... text=["a photo of a cat", "a photo of a dog"], images=image, return_tensors="pt", padding=True
... )
>>> with torch.inference_mode():
... outputs = model(**inputs)
>>> logits_per_image = outputs.logits_per_image # this is the image-text similarity score
>>> probs = logits_per_image.softmax(dim=1) # we can take the softmax to get the label probabilities
```
#### get_text_features[[transformers.CLIPSegModel.get_text_features]]
```python
get_text_features(input_ids: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L804)
**Параметры:**
input_ids (`torch.Tensor` формы `(batch_size, sequence_length)`) : Индексы токенов входной последовательности в словаре. По умолчанию заполнение (padding) игнорируется. Индексы можно получить с помощью [AutoTokenizer](/docs/transformers/v5.23.0/ru/model_doc/auto#transformers.AutoTokenizer). Подробности см. в [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) и [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__). [Что такое входные идентификаторы?](../glossary#input-ids)
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
position_ids (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Индексы позиций токенов каждого входного последовательности в позиционных эмбеддингах. Выбираются из диапазона `[0, config.n_positions - 1]`. [Что такое идентификаторы позиций?](../glossary#position-ids)
**Возвращает:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или `tuple(torch.Tensor)`
Объект [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([CLIPSegConfig](/docs/transformers/v5.23.0/ru/model_doc/clipseg#transformers.CLIPSegConfig)) и входных данных.
- **last_hidden_state** (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`) -- Последовательность скрытых состояний на выходе последнего слоя модели.
- **pooler_output** (`torch.Tensor` формы `(batch_size, hidden_size)`) -- Скрытое состояние последнего слоя для первого токена последовательности (токен классификации) после дополнительной обработки слоями, используемыми для вспомогательной задачи предварительного обучения. Например, для моделей семейства BERT это возвращает токен классификации после обработки линейным слоем и функцией активации tanh. Веса линейного слоя обучаются по задаче предсказания следующего предложения (классификации) во время предварительного обучения.
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Примеры:
```python
>>> import torch
>>> from transformers import AutoTokenizer, CLIPSegModel
>>> tokenizer = AutoTokenizer.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegModel.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> inputs = tokenizer(["a photo of a cat", "a photo of a dog"], padding=True, return_tensors="pt")
>>> with torch.inference_mode():
... text_features = model.get_text_features(**inputs)
```
#### get_image_features[[transformers.CLIPSegModel.get_image_features]]
```python
get_image_features(pixel_values: Tensor, interpolate_pos_encoding: bool = True, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L839)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [ViTImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/vit#transformers.ViTImageProcessor). Подробности см. в [ViTImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) ([CLIPSegProcessor](/docs/transformers/v5.23.0/ru/model_doc/clipseg#transformers.CLIPSegProcessor) использует [ViTImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/vit#transformers.ViTImageProcessor) для обработки изображений).
interpolate_pos_encoding (`bool`, *необязательный*, по умолчанию `True`) : Интерполировать ли предобученные позиционные кодирования.
**Возвращает:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или `tuple(torch.Tensor)`
Объект [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([CLIPSegConfig](/docs/transformers/v5.23.0/ru/model_doc/clipseg#transformers.CLIPSegConfig)) и входных данных.
- **last_hidden_state** (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`) -- Последовательность скрытых состояний на выходе последнего слоя модели.
- **pooler_output** (`torch.Tensor` формы `(batch_size, hidden_size)`) -- Скрытое состояние последнего слоя для первого токена последовательности (токен классификации) после дополнительной обработки слоями, используемыми для вспомогательной задачи предварительного обучения. Например, для моделей семейства BERT это возвращает токен классификации после обработки линейным слоем и функцией активации tanh. Веса линейного слоя обучаются по задаче предсказания следующего предложения (классификации) во время предварительного обучения.
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Примеры:
```python
>>> import torch
>>> from transformers import AutoProcessor, CLIPSegModel
>>> from transformers.image_utils import load_image
>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegModel.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(images=image, return_tensors="pt")
>>> with torch.inference_mode():
... image_features = model.get_image_features(**inputs)
```
## CLIPSegTextModel[[transformers.CLIPSegTextModel]]
#### transformers.CLIPSegTextModel[[transformers.CLIPSegTextModel]]
```python
transformers.CLIPSegTextModel(config: CLIPSegTextConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L594)
**Параметры:**
config ([CLIPSegTextConfig](/docs/transformers/v5.23.0/ru/model_doc/clipseg#transformers.CLIPSegTextConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Текстовая модель из CLIPSEG без какой-либо головы или проекции сверху.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.CLIPSegTextModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L610)
**Параметры:**
input_ids (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Индексы токенов входной последовательности в словаре. По умолчанию заполнение (padding) игнорируется. Индексы можно получить с помощью [AutoTokenizer](/docs/transformers/v5.23.0/ru/model_doc/auto#transformers.AutoTokenizer). Подробности см. в [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) и [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__). [Что такое входные идентификаторы?](../glossary#input-ids)
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
position_ids (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Индексы позиций токенов каждого входного последовательности в позиционных эмбеддингах. Выбираются из диапазона `[0, config.n_positions - 1]`. [Что такое идентификаторы позиций?](../glossary#position-ids)
**Возвращает:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или `tuple(torch.Tensor)`
Объект [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([CLIPSegConfig](/docs/transformers/v5.23.0/ru/model_doc/clipseg#transformers.CLIPSegConfig)) и входных данных.
Метод forward модели [CLIPSegTextModel](/docs/transformers/v5.23.0/ru/model_doc/clipseg#transformers.CLIPSegTextModel) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **last_hidden_state** (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`) -- Последовательность скрытых состояний на выходе последнего слоя модели.
- **pooler_output** (`torch.Tensor` формы `(batch_size, hidden_size)`) -- Скрытое состояние последнего слоя для первого токена последовательности (токен классификации) после дополнительной обработки слоями, используемыми для вспомогательной задачи предварительного обучения. Например, для моделей семейства BERT это возвращает токен классификации после обработки линейным слоем и функцией активации tanh. Веса линейного слоя обучаются по задаче предсказания следующего предложения (классификации) во время предварительного обучения.
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Примеры:
```python
>>> from transformers import AutoTokenizer, CLIPSegTextModel
>>> tokenizer = AutoTokenizer.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegTextModel.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> inputs = tokenizer(["a photo of a cat", "a photo of a dog"], padding=True, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output # pooled (EOS token) states
```
## CLIPSegVisionModel[[transformers.CLIPSegVisionModel]]
#### transformers.CLIPSegVisionModel[[transformers.CLIPSegVisionModel]]
```python
transformers.CLIPSegVisionModel(config: CLIPSegVisionConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L694)
**Параметры:**
config ([CLIPSegVisionConfig](/docs/transformers/v5.23.0/ru/model_doc/clipseg#transformers.CLIPSegVisionConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Модель зрения из CLIPSEG без какой-либо головы или проекции сверху.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.CLIPSegVisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor], interpolate_pos_encoding: bool | None = True, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L710)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`, *необязательно*) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [ViTImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/vit#transformers.ViTImageProcessor). Подробности см. в [ViTImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) ([CLIPSegProcessor](/docs/transformers/v5.23.0/ru/model_doc/clipseg#transformers.CLIPSegProcessor) использует [ViTImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/vit#transformers.ViTImageProcessor) для обработки изображений).
interpolate_pos_encoding (`bool`, *необязательный*, по умолчанию `True`) : Интерполировать ли предобученные позиционные кодирования.
**Возвращает:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или `tuple(torch.Tensor)`
Объект [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([CLIPSegConfig](/docs/transformers/v5.23.0/ru/model_doc/clipseg#transformers.CLIPSegConfig)) и входных данных.
Метод forward модели [CLIPSegVisionModel](/docs/transformers/v5.23.0/ru/model_doc/clipseg#transformers.CLIPSegVisionModel) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **last_hidden_state** (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`) -- Последовательность скрытых состояний на выходе последнего слоя модели.
- **pooler_output** (`torch.Tensor` формы `(batch_size, hidden_size)`) -- Скрытое состояние последнего слоя для первого токена последовательности (токен классификации) после дополнительной обработки слоями, используемыми для вспомогательной задачи предварительного обучения. Например, для моделей семейства BERT это возвращает токен классификации после обработки линейным слоем и функцией активации tanh. Веса линейного слоя обучаются по задаче предсказания следующего предложения (классификации) во время предварительного обучения.
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Примеры:
```python
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> from transformers import AutoProcessor, CLIPSegVisionModel
>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegVisionModel.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> inputs = processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output # pooled CLS states
```
## CLIPSegForImageSegmentation[[transformers.CLIPSegForImageSegmentation]]
#### transformers.CLIPSegForImageSegmentation[[transformers.CLIPSegForImageSegmentation]]
```python
transformers.CLIPSegForImageSegmentation(config: CLIPSegConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L961)
**Параметры:**
config ([CLIPSegConfig](/docs/transformers/v5.23.0/ru/model_doc/clipseg#transformers.CLIPSegConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Модель CLIPSeg с декодером на основе Transformer для сегментации изображений в режимах zero-shot и one-shot.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.CLIPSegForImageSegmentation.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, conditional_pixel_values: typing.Optional[torch.Tensor] = None, conditional_embeddings: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, labels: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = True, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L1001)
**Параметры:**
input_ids (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Индексы токенов входной последовательности в словаре. По умолчанию заполнение (padding) игнорируется. Индексы можно получить с помощью [AutoTokenizer](/docs/transformers/v5.23.0/ru/model_doc/auto#transformers.AutoTokenizer). Подробности см. в [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) и [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__). [Что такое входные идентификаторы?](../glossary#input-ids)
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`, *необязательно*) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [ViTImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/vit#transformers.ViTImageProcessor). Подробности см. в [ViTImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) ([CLIPSegProcessor](/docs/transformers/v5.23.0/ru/model_doc/clipseg#transformers.CLIPSegProcessor) использует [ViTImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/vit#transformers.ViTImageProcessor) для обработки изображений).
conditional_pixel_values (`torch.Tensor`, *необязательный*) : Пиксельные значения условных изображений.
conditional_embeddings (`torch.Tensor` формы `(batch_size, config.projection_dim)`, *необязательный*) : Условные эмбеддинги для изображений запроса. Если предоставлено, модель будет использовать это значение вместо вычисления эмбеддингов из conditional_pixel_values.
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
position_ids (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательно*) : Индексы позиций токенов каждого входного последовательности в позиционных эмбеддингах. Выбираются из диапазона `[0, config.n_positions - 1]`. [Что такое position IDs?](../glossary#position-ids)
labels (`torch.Tensor` формы `(batch_size, height, width)`, *необязательный*) : Метки сегментации (ground truth), значения которых лежат в диапазоне `[0, 1]` и имеют такое же пространственное разрешение, как у `logits`. Между предсказанными logits и этими масками вычисляется бинарная кросс-энтропия.
interpolate_pos_encoding (`bool`, *необязательный*, по умолчанию `True`) : Интерполировать ли предобученные позиционные кодирования.
**Возвращает:** `CLIPSegOutput` или `tuple(torch.Tensor)`
Объект `CLIPSegOutput` или кортеж из `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([CLIPSegConfig](/docs/transformers/v5.23.0/ru/model_doc/clipseg#transformers.CLIPSegConfig)) и входных данных.
Метод forward класса [CLIPSegForImageSegmentation](/docs/transformers/v5.23.0/ru/model_doc/clipseg#transformers.CLIPSegForImageSegmentation) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor` формы `(1,)`, *необязательный*, возвращается, если `return_loss` равно `True`) -- Контрастивная функция потерь для сходства изображения и текста.
- **logits_per_image** (`torch.Tensor` формы `(image_batch_size, text_batch_size)`) -- Оценки масштабированного скалярного произведения между `image_embeds` и `text_embeds`. Это представляет собой оценки сходства между изображением и текстом.
- **logits_per_text** (`torch.Tensor` формы `(text_batch_size, image_batch_size)`) -- Оценки масштабированного скалярного произведения между `text_embeds` и `image_embeds`. Это представляет собой оценки сходства между текстом и изображением.
- **text_embeds** (`torch.Tensor` формы `(batch_size, output_dim`) -- Векторы текста, полученные применением слоя проекции к агрегированному выводу [CLIPSegTextModel](/docs/transformers/v5.23.0/ru/model_doc/clipseg#transformers.CLIPSegTextModel).
- **image_embeds** (`torch.Tensor` формы `(batch_size, output_dim`) -- Векторные представления изображений, полученные применением слоя проекции к агрегированному выходу [CLIPSegVisionModel](/docs/transformers/v5.23.0/ru/model_doc/clipseg#transformers.CLIPSegVisionModel).
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *необязательный*) -- Выход [CLIPSegTextModel](/docs/transformers/v5.23.0/ru/model_doc/clipseg#transformers.CLIPSegTextModel).
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *необязательный*) -- Выход [CLIPSegVisionModel](/docs/transformers/v5.23.0/ru/model_doc/clipseg#transformers.CLIPSegVisionModel).
Примеры:
```python
>>> import torch
>>> from transformers import AutoProcessor, CLIPSegForImageSegmentation
>>> from transformers.image_utils import load_image
>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegForImageSegmentation.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> texts = ["a cat", "a remote", "a blanket"]
>>> inputs = processor(text=texts, images=[image] * len(texts), padding=True, return_tensors="pt")
>>> with torch.inference_mode():
... outputs = model(**inputs)
>>> logits = outputs.logits
>>> print(logits.shape)
torch.Size([3, 352, 352])
```