# Nougat
## 개요
Nougat 모델은 Lukas Blecher, Guillem Cucurull, Thomas Scialom, Robert Stojnic이 [Nougat: Neural Optical Understanding for Academic Documents](https://huggingface.co/papers/2308.13418)에서 제안했습니다. Nougat는 [Donut](donut)과 동일한 아키텍처를 사용하여 이미지 Transformer 인코더와 자기 회귀적 텍스트 Transformer 디코더를 통해 과학적 PDF를 markdown으로 변환하며, 이를 통해 해당 문서에 대한 접근성을 높입니다.
해당 논문의 초록은 다음과 같습니다:
*과학 지식은 주로 책과 과학 저널에 저장되며, 대부분 PDF 형태로 존재합니다. 그러나 PDF 형식은 수학 표현을 포함한 의미론적 정보의 손실을 초래합니다. 본 논문에서는 과학 문서를 마크업 언어로 처리하기 위해 OCR(광학 문자 인식) 작업을 수행하는 Visual Transformer 모델인 Nougat(Neural Optical Understanding for Academic Documents)를 제안하고, 새로운 과학 문서 데이터셋에서 해당 모델의 효과를 입증합니다. 제안된 접근법은 사람이 읽을 수 있는 문서와 기계가 읽을 수 있는 텍스트 사이의 격차를 줄여 디지털 시대의 과학 지식 접근성을 높이는 데 유망한 해결책입니다. 과학 텍스트 인식에 대한 후속 연구를 촉진하기 위해 모델과 코드를 공개합니다.*
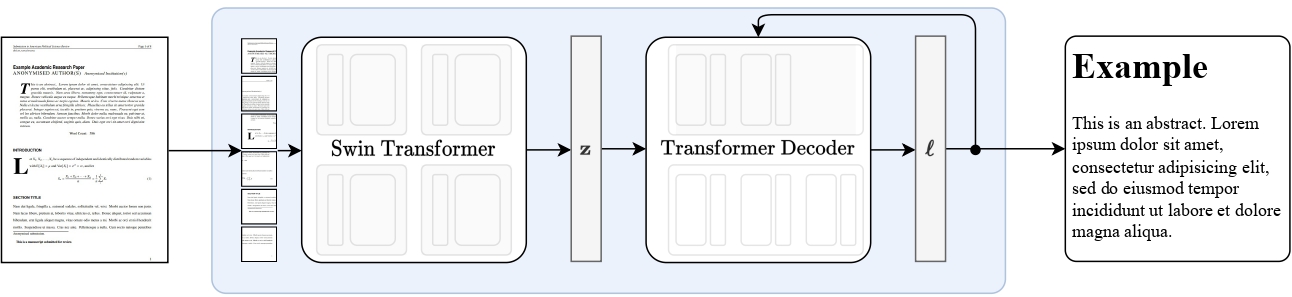 Nougat의 고수준 개요. 원 논문에서 가져왔습니다.
이 모델은 [nielsr](https://huggingface.co/nielsr)에 의해 기여되었습니다. 원본 코드는 [여기](https://github.com/facebookresearch/nougat)에서 찾을 수 있습니다.
## 사용 팁
- Nougat을 가장 빠르게 시작하는 방법은 추론 시 모델 사용법과 커스텀 데이터로 파인튜닝하는 방법을 보여주는 [tutorial notebooks](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/Nougat)를 확인하는 것입니다.
- Nougat은 항상 [VisionEncoderDecoder](vision-encoder-decoder) 프레임워크 내에서 사용됩니다. 이 모델은 아키텍처 측면에서 [Donut](donut)과 동일합니다.
## 추론
Nougat의 `VisionEncoderDecoder` 모델은 이미지를 입력으로 받아 [generate()](/docs/transformers/v5.23.0/ko/main_classes/text_generation#transformers.GenerationMixin.generate)를 사용하여 입력된 이미지에 기반하여 텍스트를 자기회귀적으로 생성합니다.
[NougatImageProcessor](/docs/transformers/v5.23.0/ko/model_doc/nougat#transformers.NougatImageProcessor) 클래스는 입력 이미지의 전처리를 담당하며, [NougatTokenizerFast](/docs/transformers/v5.23.0/ko/model_doc/nougat#transformers.NougatTokenizer)는 생성된 대상 토큰을 대상 문자열로 디코딩합니다. [NougatProcessor](/docs/transformers/v5.23.0/ko/model_doc/nougat#transformers.NougatProcessor)는 [NougatImageProcessor](/docs/transformers/v5.23.0/ko/model_doc/nougat#transformers.NougatImageProcessor)와 [NougatTokenizerFast](/docs/transformers/v5.23.0/ko/model_doc/nougat#transformers.NougatTokenizer) 클래스를 단일 인스턴스로 묶어 입력 특징을 추출하고 예측된 토큰 ID를 디코딩합니다.
- 단계별 PDF 전사
```python
from huggingface_hub import hf_hub_download
from PIL import Image
from transformers import AutoModelForImageTextToText, NougatProcessor
processor = NougatProcessor.from_pretrained("facebook/nougat-base")
model = AutoModelForImageTextToText.from_pretrained("facebook/nougat-base", device_map="auto")
model.to(model.device) # doctest: +IGNORE_RESULT
# prepare PDF image for the model
filepath = hf_hub_download(repo_id="hf-internal-testing/fixtures_docvqa", filename="nougat_paper.png", repo_type="dataset")
image = Image.open(filepath)
pixel_values = processor(image, return_tensors="pt").to(model.device).pixel_values
# generate transcription (here we only generate 30 tokens)
outputs = model.generate(
pixel_values.to(model.device),
min_length=1,
max_new_tokens=30,
bad_words_ids=[[processor.tokenizer.unk_token_id]],
)
sequence = processor.batch_decode(outputs, skip_special_tokens=True)[0]
sequence = processor.post_process_generation(sequence, fix_markdown=False)
# note: we're using repr here such for the sake of printing the \n characters, feel free to just print the sequence
print(repr(sequence))
'\n\n# Nougat: Neural Optical Understanding for Academic Documents\n\n Lukas Blecher\n\nCorrespondence to: lblecher@'
```
Nougat 체크포인트를 찾으려면 [모델 허브](https://huggingface.co/models?filter=nougat)를 참조하세요.
해당 모델은 아키텍처 측면에서 [Donut](donut)와 동일합니다.
## NougatConfig[[transformers.NougatConfig]]
#### transformers.NougatConfig[[transformers.NougatConfig]]
```python
transformers.NougatConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, is_encoder_decoder: bool = True, encoder: dict | transformers.configuration_utils.PreTrainedConfig | None = None, decoder: dict | transformers.configuration_utils.PreTrainedConfig | None = None)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/configuration_nougat.py#L28)
**매개변수:**
is_encoder_decoder (`bool`, *선택 사항*, 기본값 `True`) : 모델이 인코더/디코더로 사용되는지 여부.
encoder (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *선택*) : 인코더 백본의 config 객체 또는 사전.
decoder (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *선택*) : 디코더 백본의 config 객체 또는 사전.
이것은 NougatModel의 구성을 저장하기 위한 구성 클래스입니다. 지정된 인자에 따라 Nougat 모델을 인스턴스화하고 모델 아키텍처를 정의하는 데 사용됩니다. 기본값으로 구성을 인스턴스화하면 [facebook/nougat-base](https://huggingface.co/facebook/nougat-base)와 유사한 구성이 생성됩니다.
Configuration 객체는 [PreTrainedConfig](/docs/transformers/v5.23.0/ko/main_classes/configuration#transformers.PreTrainedConfig)를 상속하며, 모델 출력을 제어하는 데 사용할 수 있습니다. 자세한 내용은 [PreTrainedConfig](/docs/transformers/v5.23.0/ko/main_classes/configuration#transformers.PreTrainedConfig)의 문서를 참고하세요.
예:
```python
>>> from transformers import NougatConfig, VisionEncoderDecoderModel
>>> # Initializing a Nougat configuration
>>> config = NougatConfig()
>>> # Initializing a VisionEncoderDecoder model (with random weights) from a Nougat configurations
>>> model = VisionEncoderDecoderModel(config=config)
```
#### from_encoder_decoder_configs[[transformers.NougatConfig.from_encoder_decoder_configs]]
```python
from_encoder_decoder_configs(encoder_config: PreTrainedConfig, decoder_config: PreTrainedConfig, **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/configuration_nougat.py#L52)
**반환값:** [VisionEncoderDecoderConfig](/docs/transformers/v5.23.0/ko/model_doc/vision-encoder-decoder#transformers.VisionEncoderDecoderConfig)
설정 객체의 인스턴스
Instantiate a [VisionEncoderDecoderConfig](/docs/transformers/v5.23.0/ko/model_doc/vision-encoder-decoder#transformers.VisionEncoderDecoderConfig) (or a derived class) from a pre-trained encoder model configuration and decoder model configuration.
## NougatImageProcessor[[transformers.NougatImageProcessor]]
#### transformers.NougatImageProcessor[[transformers.NougatImageProcessor]]
```python
transformers.NougatImageProcessor(**kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/image_processing_nougat.py#L57)
**매개변수:**
do_convert_rgb (`bool`, *kwargs*, *선택*) : 이미지를 RGB로 변환할지 여부.
do_resize (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 리사이즈할지 여부.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, 기본값 `{'height' : 896, 'width': 672}`): 모델에 입력되는 최대 차원을 설명합니다.
default_to_square (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : size가 int인 경우 리사이즈 시 정사각형 이미지로 설정할지 여부.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop`를 적용한 후의 출력 이미지 크기.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, 기본값 `2`) : 이미지를 리사이즈할 때 사용할 리샘플링 필터입니다. 이는 `PILImageResampling` enum 중 하나일 수 있습니다. `do_resize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_rescale (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 다시 스케일링할지 여부.
rescale_factor (`float`, *kwargs*, *선택 사항*, 기본값 `0.00392156862745098`) : `do_rescale`이 `True`로 설정된 경우 이미지를 재조정하는 데 사용되는 재조정 계수입니다.
do_normalize (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 정규화할지 여부.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택 사항*, 기본값은 `[0.485, 0.456, 0.406]`) : 정규화에 사용할 이미지 평균입니다. `do_normalize`가 `True`로 설정된 경우에만 효과가 있습니다.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택 사항*, 기본값은 `[0.229, 0.224, 0.225]`) : 정규화에 사용할 이미지 표준 편차입니다. `do_normalize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_pad (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 패딩할지 여부입니다. 패딩은 배치 내 가장 큰 크기로 수행하거나 이미지마다 고정된 정사각형 크기로 수행합니다. 정확한 패딩 전략은 모델에 따라 달라집니다.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 이미지를 패딩할 `{"height": int, "width" int}` 크기를 지정합니다. 전처리용으로 제공된 모든 이미지 크기보다 커야 합니다. `pad_size`가 제공되지 않으면, 이미지는 배치 내 가장 큰 높이와 너비로 패딩됩니다. `do_pad=True.`일 때만 적용됩니다.
do_center_crop (`bool`, *kwargs*, *선택*) : 이미지를 중앙 크롭할지 여부.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : `ChannelDimension.FIRST`만 지원됩니다. 느린 프로세서와의 호환성을 위해 추가되었습니다.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : 입력 이미지의 채널 차원 형식입니다. 설정하지 않으면 입력 이미지에서 채널 차원 형식을 추론합니다. 다음 중 하나일 수 있습니다: - `"channels_first"` 또는 `ChannelDimension.FIRST`: (num_channels, height, width) 형식의 이미지. - `"channels_last"` 또는 `ChannelDimension.LAST`: (height, width, num_channels) 형식의 이미지. - `"none"` 또는 `ChannelDimension.NONE`: (height, width) 형식의 이미지.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 비디오를 처리할 장치입니다. 설정되지 않은 경우, 입력 비디오에서 장치를 추론합니다.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`로 설정된 경우 스택된 텐서를 반환하고, 그렇지 않으면 텐서 목록을 반환합니다.
disable_grouping (`bool`, *kwargs*, *선택*) : 이미지의 크기에 따른 그룹화를 비활성화하여 이미지를 배치 대신 개별적으로 처리할지 여부입니다. None인 경우, 이미지가 CPU에 있으면 True, 그렇지 않으면 False로 설정됩니다. 이 선택은 https://github.com/huggingface/transformers/pull/38157에 자세히 설명된 경험적 관찰에 기반합니다.
image_seq_length (`int`, *kwargs*, *선택*) : 입력의 각 이미지에 사용할 이미지 토큰의 수입니다. 하위 호환성을 위해 추가되었지만, 향후 모델에서는 프로세서 속성으로 설정해야 합니다.
do_crop_margin (`bool`, *kwargs*, *선택 사항*, 기본값은 `self.do_crop_margin`) : 이미지 여백을 자를지 여부.
do_thumbnail (`bool`, *kwargs*, *선택 사항*, 기본값은 `self.do_thumbnail`) : thumbnail 메서드를 사용하여 이미지를 리사이즈할지 여부.
do_align_long_axis (`bool`, *kwargs*, *선택 사항*, 기본값은 `self.do_align_long_axis`) : 이미지를 90도 회전시켜 이미지의 긴 축을 `size`의 긴 축과 정렬할지 여부.
NougatImageProcessor 이미지 프로세서를 생성합니다.
#### preprocess[[transformers.NougatImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/image_processing_nougat.py#L74)
**매개변수:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : 전처리할 이미지. 픽셀 값이 0에서 255 범위로 이루어진 단일 이미지 또는 배치 이미지를 기대합니다. 픽셀 값이 0에서 1 범위로 이루어진 이미지를 전달하는 경우 `do_rescale=False`로 설정하세요.
do_convert_rgb (`bool`, *kwargs*, *선택*) : 이미지를 RGB로 변환할지 여부.
do_resize (`bool`, *kwargs*, *선택*) : 이미지를 리사이즈할지 여부.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 모델의 최대 입력 차원을 설명합니다.
default_to_square (`bool`, *kwargs*, *선택*) : size가 int인 경우 리사이즈 시 정사각형 이미지로 기본 설정할지 여부.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop`를 적용한 후의 출력 이미지 크기.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : 이미지를 리사이즈할 때 사용할 리샘플링 필터입니다. `PILImageResampling` enum 중 하나를 사용할 수 있습니다. `do_resize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_rescale (`bool`, *kwargs*, *선택*) : 이미지를 다시 스케일링할지 여부.
rescale_factor (`float`, *kwargs*, *선택*) : `do_rescale`가 `True`로 설정된 경우 이미지를 재조정하는 데 사용되는 재조정 계수입니다.
do_normalize (`bool`, *kwargs*, *선택*) : 이미지를 정규화할지 여부.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택*) : 정규화에 사용할 이미지 평균값. `do_normalize`이 `True`로 설정된 경우에만 효과가 있습니다.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택*) : 정규화에 사용할 이미지 표준 편차. `do_normalize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_pad (`bool`, *kwargs*, *선택*) : 이미지를 패딩할지 여부입니다. 패딩은 배치 내 가장 큰 크기로 수행하거나, 이미지마다 고정된 정사각형 크기로 수행합니다. 정확한 패딩 전략은 모델에 따라 달라집니다.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 이미지를 패딩할 `{"height": int, "width" int}` 크기를 지정합니다. 전처리용으로 제공된 모든 이미지 크기보다 커야 합니다. `pad_size`가 제공되지 않으면, 이미지는 배치 내 가장 큰 높이와 너비로 패딩됩니다. `do_pad=True.`일 때만 적용됩니다.
do_center_crop (`bool`, *kwargs*, *선택*) : 이미지를 중앙 크롭할지 여부.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : `ChannelDimension.FIRST`만 지원됩니다. 느린 프로세서와의 호환성을 위해 추가되었습니다.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : 입력 이미지의 채널 차원 형식입니다. 설정하지 않으면 입력 이미지에서 채널 차원 형식을 추론합니다. 다음 중 하나일 수 있습니다: - `"channels_first"` 또는 `ChannelDimension.FIRST`: (num_channels, height, width) 형식의 이미지. - `"channels_last"` 또는 `ChannelDimension.LAST`: (height, width, num_channels) 형식의 이미지. - `"none"` 또는 `ChannelDimension.NONE`: (height, width) 형식의 이미지.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 비디오를 처리할 장치입니다. 설정되지 않은 경우, 입력 비디오에서 장치를 추론합니다.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`로 설정된 경우 스택된 텐서를 반환하고, 그렇지 않으면 텐서 목록을 반환합니다.
disable_grouping (`bool`, *kwargs*, *선택*) : 이미지의 크기에 따른 그룹화를 비활성화하여 이미지를 배치 대신 개별적으로 처리할지 여부입니다. None인 경우, 이미지가 CPU에 있으면 True, 그렇지 않으면 False로 설정됩니다. 이 선택은 https://github.com/huggingface/transformers/pull/38157에 자세히 설명된 경험적 관찰에 기반합니다.
image_seq_length (`int`, *kwargs*, *선택*) : 입력의 각 이미지에 사용할 이미지 토큰의 수입니다. 하위 호환성을 위해 추가되었지만, 향후 모델에서는 프로세서 속성으로 설정해야 합니다.
do_crop_margin (`bool`, *kwargs*, *선택 사항*, 기본값은 `self.do_crop_margin`) : 이미지 여백을 자를지 여부.
do_thumbnail (`bool`, *kwargs*, *선택 사항*, 기본값은 `self.do_thumbnail`) : thumbnail 메서드를 사용하여 이미지를 리사이즈할지 여부.
do_align_long_axis (`bool`, *kwargs*, *선택 사항*, 기본값은 `self.do_align_long_axis`) : 이미지를 90도 회전시켜 이미지의 긴 축을 `size`의 긴 축과 정렬할지 여부.
**반환값:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ 메서드가 반환하는 리스트/배열/텐서 딕셔너리('pixel_values' 등).
- **tensor_type** (`Union[None, str, TensorType]`, *선택 사항*) -- 초기화 시 PyTorch/Numpy 텐서에서 정수 목록을 변환하려면 여기에 tensor_type을 지정할 수 있습니다.
## NougatImageProcessorPil[[transformers.NougatImageProcessorPil]]
#### transformers.NougatImageProcessorPil[[transformers.NougatImageProcessorPil]]
```python
transformers.NougatImageProcessorPil(**kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/image_processing_pil_nougat.py#L59)
**매개변수:**
do_convert_rgb (`bool`, *kwargs*, *선택*) : 이미지를 RGB로 변환할지 여부.
do_resize (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 리사이즈할지 여부.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, 기본값 `{'height' : 896, 'width': 672}`): 모델에 입력되는 최대 차원을 설명합니다.
default_to_square (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : size가 int인 경우 리사이즈 시 정사각형 이미지로 설정할지 여부.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop`를 적용한 후의 출력 이미지 크기.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, 기본값 `2`) : 이미지를 리사이즈할 때 사용할 리샘플링 필터입니다. 이는 `PILImageResampling` enum 중 하나일 수 있습니다. `do_resize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_rescale (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 다시 스케일링할지 여부.
rescale_factor (`float`, *kwargs*, *선택 사항*, 기본값 `0.00392156862745098`) : `do_rescale`이 `True`로 설정된 경우 이미지를 재조정하는 데 사용되는 재조정 계수입니다.
do_normalize (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 정규화할지 여부.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택 사항*, 기본값은 `[0.485, 0.456, 0.406]`) : 정규화에 사용할 이미지 평균입니다. `do_normalize`가 `True`로 설정된 경우에만 효과가 있습니다.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택 사항*, 기본값은 `[0.229, 0.224, 0.225]`) : 정규화에 사용할 이미지 표준 편차입니다. `do_normalize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_pad (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 패딩할지 여부입니다. 패딩은 배치 내 가장 큰 크기로 수행하거나 이미지마다 고정된 정사각형 크기로 수행합니다. 정확한 패딩 전략은 모델에 따라 달라집니다.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 이미지를 패딩할 `{"height": int, "width" int}` 크기를 지정합니다. 전처리용으로 제공된 모든 이미지 크기보다 커야 합니다. `pad_size`가 제공되지 않으면, 이미지는 배치 내 가장 큰 높이와 너비로 패딩됩니다. `do_pad=True.`일 때만 적용됩니다.
do_center_crop (`bool`, *kwargs*, *선택*) : 이미지를 중앙 크롭할지 여부.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : `ChannelDimension.FIRST`만 지원됩니다. 느린 프로세서와의 호환성을 위해 추가되었습니다.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : 입력 이미지의 채널 차원 형식입니다. 설정하지 않으면 입력 이미지에서 채널 차원 형식을 추론합니다. 다음 중 하나일 수 있습니다: - `"channels_first"` 또는 `ChannelDimension.FIRST`: (num_channels, height, width) 형식의 이미지. - `"channels_last"` 또는 `ChannelDimension.LAST`: (height, width, num_channels) 형식의 이미지. - `"none"` 또는 `ChannelDimension.NONE`: (height, width) 형식의 이미지.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 비디오를 처리할 장치입니다. 설정되지 않은 경우, 입력 비디오에서 장치를 추론합니다.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`로 설정된 경우 스택된 텐서를 반환하고, 그렇지 않으면 텐서 목록을 반환합니다.
disable_grouping (`bool`, *kwargs*, *선택*) : 이미지의 크기에 따른 그룹화를 비활성화하여 이미지를 배치 대신 개별적으로 처리할지 여부입니다. None인 경우, 이미지가 CPU에 있으면 True, 그렇지 않으면 False로 설정됩니다. 이 선택은 https://github.com/huggingface/transformers/pull/38157에 자세히 설명된 경험적 관찰에 기반합니다.
image_seq_length (`int`, *kwargs*, *선택*) : 입력의 각 이미지에 사용할 이미지 토큰의 수입니다. 하위 호환성을 위해 추가되었지만, 향후 모델에서는 프로세서 속성으로 설정해야 합니다.
do_crop_margin (`bool`, *kwargs*, *선택 사항*, 기본값은 `self.do_crop_margin`) : 이미지 여백을 자를지 여부.
do_thumbnail (`bool`, *kwargs*, *선택 사항*, 기본값은 `self.do_thumbnail`) : thumbnail 메서드를 사용하여 이미지를 리사이즈할지 여부.
do_align_long_axis (`bool`, *kwargs*, *선택 사항*, 기본값은 `self.do_align_long_axis`) : 이미지를 90도 회전시켜 이미지의 긴 축을 `size`의 긴 축과 정렬할지 여부.
NougatImageProcessor 이미지 프로세서를 생성합니다.
#### preprocess[[transformers.NougatImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/image_processing_pil_nougat.py#L76)
**매개변수:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : 전처리할 이미지. 픽셀 값이 0에서 255 범위로 이루어진 단일 이미지 또는 배치 이미지를 기대합니다. 픽셀 값이 0에서 1 범위로 이루어진 이미지를 전달하는 경우 `do_rescale=False`로 설정하세요.
do_convert_rgb (`bool`, *kwargs*, *선택*) : 이미지를 RGB로 변환할지 여부.
do_resize (`bool`, *kwargs*, *선택*) : 이미지를 리사이즈할지 여부.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 모델의 최대 입력 차원을 설명합니다.
default_to_square (`bool`, *kwargs*, *선택*) : size가 int인 경우 리사이즈 시 정사각형 이미지로 기본 설정할지 여부.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop`를 적용한 후의 출력 이미지 크기.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : 이미지를 리사이즈할 때 사용할 리샘플링 필터입니다. `PILImageResampling` enum 중 하나를 사용할 수 있습니다. `do_resize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_rescale (`bool`, *kwargs*, *선택*) : 이미지를 다시 스케일링할지 여부.
rescale_factor (`float`, *kwargs*, *선택*) : `do_rescale`가 `True`로 설정된 경우 이미지를 재조정하는 데 사용되는 재조정 계수입니다.
do_normalize (`bool`, *kwargs*, *선택*) : 이미지를 정규화할지 여부.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택*) : 정규화에 사용할 이미지 평균값. `do_normalize`이 `True`로 설정된 경우에만 효과가 있습니다.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택*) : 정규화에 사용할 이미지 표준 편차. `do_normalize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_pad (`bool`, *kwargs*, *선택*) : 이미지를 패딩할지 여부입니다. 패딩은 배치 내 가장 큰 크기로 수행하거나, 이미지마다 고정된 정사각형 크기로 수행합니다. 정확한 패딩 전략은 모델에 따라 달라집니다.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 이미지를 패딩할 `{"height": int, "width" int}` 크기를 지정합니다. 전처리용으로 제공된 모든 이미지 크기보다 커야 합니다. `pad_size`가 제공되지 않으면, 이미지는 배치 내 가장 큰 높이와 너비로 패딩됩니다. `do_pad=True.`일 때만 적용됩니다.
do_center_crop (`bool`, *kwargs*, *선택*) : 이미지를 중앙 크롭할지 여부.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : `ChannelDimension.FIRST`만 지원됩니다. 느린 프로세서와의 호환성을 위해 추가되었습니다.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : 입력 이미지의 채널 차원 형식입니다. 설정하지 않으면 입력 이미지에서 채널 차원 형식을 추론합니다. 다음 중 하나일 수 있습니다: - `"channels_first"` 또는 `ChannelDimension.FIRST`: (num_channels, height, width) 형식의 이미지. - `"channels_last"` 또는 `ChannelDimension.LAST`: (height, width, num_channels) 형식의 이미지. - `"none"` 또는 `ChannelDimension.NONE`: (height, width) 형식의 이미지.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 비디오를 처리할 장치입니다. 설정되지 않은 경우, 입력 비디오에서 장치를 추론합니다.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`로 설정된 경우 스택된 텐서를 반환하고, 그렇지 않으면 텐서 목록을 반환합니다.
disable_grouping (`bool`, *kwargs*, *선택*) : 이미지의 크기에 따른 그룹화를 비활성화하여 이미지를 배치 대신 개별적으로 처리할지 여부입니다. None인 경우, 이미지가 CPU에 있으면 True, 그렇지 않으면 False로 설정됩니다. 이 선택은 https://github.com/huggingface/transformers/pull/38157에 자세히 설명된 경험적 관찰에 기반합니다.
image_seq_length (`int`, *kwargs*, *선택*) : 입력의 각 이미지에 사용할 이미지 토큰의 수입니다. 하위 호환성을 위해 추가되었지만, 향후 모델에서는 프로세서 속성으로 설정해야 합니다.
do_crop_margin (`bool`, *kwargs*, *선택 사항*, 기본값은 `self.do_crop_margin`) : 이미지 여백을 자를지 여부.
do_thumbnail (`bool`, *kwargs*, *선택 사항*, 기본값은 `self.do_thumbnail`) : thumbnail 메서드를 사용하여 이미지를 리사이즈할지 여부.
do_align_long_axis (`bool`, *kwargs*, *선택 사항*, 기본값은 `self.do_align_long_axis`) : 이미지를 90도 회전시켜 이미지의 긴 축을 `size`의 긴 축과 정렬할지 여부.
**반환값:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ 메서드가 반환하는 리스트/배열/텐서 딕셔너리('pixel_values' 등).
- **tensor_type** (`Union[None, str, TensorType]`, *선택 사항*) -- 초기화 시 PyTorch/Numpy 텐서에서 정수 목록을 변환하려면 여기에 tensor_type을 지정할 수 있습니다.
## NougatTokenizer[[transformers.NougatTokenizer]]
#### transformers.NougatTokenizer[[transformers.NougatTokenizer]]
```python
transformers.NougatTokenizer(errors: str = 'replace', unk_token: str = '', bos_token: str = '
', eos_token: str = '', pad_token: str = '', vocab: str | dict | list | None = None, merges: str | list | None = None, **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/tokenization_nougat.py#L347)
**매개변수:**
vocab_file (`str`, *선택 사항*) : 어휘 파일의 경로.
merges_file (`str`, *선택 사항*) : merges 파일의 경로.
tokenizer_file (`str`, *선택 사항*) : 토크나이저를 로드하는 데 필요한 모든 정보를 포함하는 [tokenizers](https://github.com/huggingface/tokenizers) 파일(일반적으로 .json 확장자를 가짐).
clean_up_tokenization_spaces (`str`, *선택 사항*, 기본값 `False`) : 디코딩 후 공백을 정리할지 여부입니다. 정리는 불필요한 공백과 같은 잠재적 아티팩트를 제거하는 작업을 포함합니다.
unk_token (`str`, *선택*, 기본값 `""`) : 알 수 없는 토큰. 어휘에 없는 토큰은 ID로 변환할 수 없으므로 이 토큰으로 설정됩니다.
bos_token (`str`, *선택 사항*, 기본값 `""`) : 사전 학습 시 사용된 시퀀스 시작 토큰입니다. 시퀀스 분류기 토큰으로 사용할 수 있습니다.
eos_token (`str`, *선택 사항*, 기본값 `""`) : 시퀀스 종료 토큰입니다.
pad_token (`str`, *선택 사항*, 기본값 `""`) : 패딩에 사용되는 토큰입니다. 예를 들어 길이가 다른 시퀀스를 배치할 때 사용됩니다.
vocab (`str`, `dict` 또는 `list`, *선택 사항*) : 사용자 정의 어휘 사전. 제공되지 않으면 vocab_file에서 어휘가 로드됩니다.
merges (`str` 또는 `list`, *선택 사항*) : 사용자 지정 병합 목록. 제공되지 않으면 병합이 merges_file에서 로드됩니다.
Nougat용 토크나이저(HuggingFace tokenizers 라이브러리를 기반으로 함).
이 토크나이저는 대부분의 주요 메서드를 포함하는 [TokenizersBackend](/docs/transformers/v5.23.0/ko/main_classes/tokenizer#transformers.TokenizersBackend)에서 상속됩니다. 해당 메서드에 대한 자세한 정보는 이 상위 클래스를 참고하세요. 이 클래스는 주로 생성된 텍스트를 후처리하기 위한 Nougat 전용 메서드를 추가합니다.
#### correct_tables[[transformers.NougatTokenizer.correct_tables]]
```python
correct_tables(generation: str)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/tokenization_nougat.py#L493)
**매개변수:**
generation (str) : 후처리할 생성된 텍스트.
**반환값:** `str`
후처리된 텍스트.
생성된 문자열을 받아 마크다운 형식에 맞게 테이블/표 형식을 수정합니다.
예:
```python
correct_tables("\begin{table} \begin{tabular}{l l} & \ \end{tabular} \end{table}")
"\begin{table}
abular}{l l} & \ \end{tabular}
le}"
```
#### post_process_generation[[transformers.NougatTokenizer.post_process_generation]]
```python
post_process_generation(generation: str | list[str], fix_markdown: bool = True, num_workers: int | None = None)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/tokenization_nougat.py#L623)
**매개변수:**
generation (Union[str, list[str]]) : 생성된 텍스트 또는 생성된 텍스트의 목록.
fix_markdown (`bool`, *선택 사항*, 기본값 `True`) : Markdown 형식 수정을 수행할지 여부.
num_workers (`int`, *선택 사항*) : 멀티프로세싱을 활용하기 위해 전달할 워커의 수(여러 텍스트를 병렬로 후처리).
**반환값:** Union[str, list[str]]
후처리된 텍스트 또는 후처리된 텍스트 목록.
생성된 텍스트 또는 생성된 텍스트 목록을 후처리합니다.
이 함수는 생성된 텍스트에 대한 후처리, 예를 들어 Markdown 형식 수정 등을 수행하는 데 사용할 수 있습니다.
Postprocessing은 상당히 느리므로, 처리 속도를 높이기 위해 multiprocessing 사용을 권장합니다.
#### post_process_single[[transformers.NougatTokenizer.post_process_single]]
```python
post_process_single(generation: str, fix_markdown: bool = True)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/tokenization_nougat.py#L528)
**매개변수:**
generation (str) : 후처리할 생성된 텍스트.
fix_markdown (bool, optional) : Markdown 형식 수정을 수행할지 여부. 기본값은 True입니다.
**반환값:** `str`
후처리된 텍스트.
Postprocess a single generated text. 여기서 사용되는 정규식은 Nougat 논문 저자들로부터 직접 가져온 것입니다. 명확성을 위해 주석이 달렸으며, 대부분의 경우 end-to-end로 테스트되었습니다.
#### remove_hallucinated_references[[transformers.NougatTokenizer.remove_hallucinated_references]]
```python
remove_hallucinated_references(text: str)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/tokenization_nougat.py#L463)
**매개변수:**
text (`str`) : 참조가 포함된 입력 텍스트.
**반환값:** `str`
환각된 참조가 제거된 텍스트.
텍스트에서 환각된 참조나 누락된 참조를 제거합니다.
이 함수는 입력 텍스트에서 누락되거나 환각된 것으로 표시된 참조를 식별하고 제거합니다.
## NougatProcessor[[transformers.NougatProcessor]]
#### transformers.NougatProcessor[[transformers.NougatProcessor]]
```python
transformers.NougatProcessor(image_processor, tokenizer)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/processing_nougat.py#L24)
**매개변수:**
image_processor (`NougatImageProcessor`) : 이미지 프로세서가 필수 입력입니다.
tokenizer (`NougatTokenizer`) : 토크나이저는 필수 입력입니다.
이미지 프로세서와 토크나이저를 단일 프로세서로 감싸는 NougatProcessor를 생성합니다.
[NougatProcessor](/docs/transformers/v5.23.0/ko/model_doc/nougat#transformers.NougatProcessor)는 [NougatImageProcessor](/docs/transformers/v5.23.0/ko/model_doc/nougat#transformers.NougatImageProcessor)와 [NougatTokenizer](/docs/transformers/v5.23.0/ko/model_doc/nougat#transformers.NougatTokenizer)의 모든 기능을 제공합니다. 자세한 내용은 [~NougatImageProcessor](/docs/transformers/v5.23.0/ko/model_doc/nougat#transformers.NougatImageProcessor)와 [~NougatTokenizer](/docs/transformers/v5.23.0/ko/model_doc/nougat#transformers.NougatTokenizer)를 참고하세요.
#### __call__[[transformers.NougatProcessor.__call__]]
```python
__call__(images = None, text = None, **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/processing_nougat.py#L32)
**매개변수:**
images (``) : Image to preprocess. Expects a single or batch of images with pixel values ranging from 0 to 255. If passing in images with pixel values between 0 and 1, set `do_rescale=False`.
text (``) : The sequence or batch of sequences to be encoded. Each sequence can be a string or a list of strings (pretokenized string). If you pass a pretokenized input, set `is_split_into_words=True`를 설정하여 배치 입력과의 혼동을 피하세요.
return_tensors (`str` 또는 [TensorType](/docs/transformers/v5.23.0/ko/internal/file_utils#transformers.TensorType), *optional*) : 설정된 경우, 특정 프레임워크의 텐서를 반환합니다. 허용되는 값은 다음과 같습니다: - `'pt'`: PyTorch `torch.Tensor` 객체를 반환합니다. - `'np'`: NumPy `np.ndarray` 객체를 반환합니다.
#### from_pretrained[[transformers.NougatProcessor.from_pretrained]]
```python
from_pretrained(pretrained_model_name_or_path: str | os.PathLike, cache_dir: str | os.PathLike | None = None, force_download: bool = False, local_files_only: bool = False, token: str | bool | None = None, revision: str = 'main', **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L1799)
**매개변수:**
pretrained_model_name_or_path (`str` 또는 `os.PathLike`) : 다음 중 하나일 수 있습니다. - huggingface.co의 모델 저장소에 호스팅된 사전 학습된 feature_extractor의 *model id*인 문자열. - [save_pretrained()](/docs/transformers/v5.23.0/ko/main_classes/feature_extractor#transformers.FeatureExtractionMixin.save_pretrained) 메서드를 사용하여 저장된 feature extractor 파일이 포함된 *디렉터리*의 경로, 예: `./my_model_directory/`. - 저장된 feature extractor JSON *파일*의 경로, 예: `./my_model_directory/preprocessor_config.json`.
- ****kwargs** : [from_pretrained()](/docs/transformers/v5.23.0/ko/main_classes/feature_extractor#transformers.FeatureExtractionMixin.from_pretrained)와 `~tokenization_utils_base.PreTrainedTokenizer.from_pretrained`에 함께 전달되는 추가 키워드 인자입니다.
과(와) 연관된 를 초기화합니다.
이 클래스 메서드는 단순히 feature extractor의 [from_pretrained()](/docs/transformers/v5.23.0/ko/main_classes/feature_extractor#transformers.FeatureExtractionMixin.from_pretrained), image processor의 [ImageProcessingMixin](/docs/transformers/v5.23.0/ko/internal/image_processing_utils#transformers.ImageProcessingMixin) 및 tokenizer의 `~tokenization_utils_base.PreTrainedTokenizer.from_pretrained` 메서드를 호출합니다. 자세한 내용은 위 메서드들의 docstring을 참고하세요.
#### save_pretrained[[transformers.NougatProcessor.save_pretrained]]
```python
save_pretrained(save_directory, push_to_hub: bool = False, **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L1182)
**매개변수:**
save_directory (`str` 또는 `os.PathLike`) : feature extractor JSON 파일과 tokenizer 파일이 저장될 디렉터리 (존재하지 않으면 생성됩니다).
push_to_hub (`bool`, *선택 사항*, 기본값 `False`) : 모델을 저장한 후 Hugging Face 모델 허브에 푸시할지 여부입니다. `repo_id`를 사용하여 푸시할 저장소를 지정할 수 있으며, 지정하지 않으면 네임스페이스 내 `save_directory`의 이름이 기본값으로 사용됩니다.
kwargs (`dict[str, Any]`, *선택*) : [push_to_hub()](/docs/transformers/v5.23.0/ko/main_classes/model#transformers.utils.PushToHubMixin.push_to_hub) 메서드에 함께 전달되는 추가 키워드 인자입니다.
이 프로세서의 속성(피처 추출기, 토크나이저...)을 지정된 디렉터리에 저장하여 [from_pretrained()](/docs/transformers/v5.23.0/ko/model_doc/wav2vec2#transformers.Wav2Vec2Processor.from_pretrained) 메서드를 사용해 다시 로드할 수 있도록 합니다.
이 클래스 메서드는 단순히 [save_pretrained()](/docs/transformers/v5.23.0/ko/main_classes/feature_extractor#transformers.FeatureExtractionMixin.save_pretrained)와 [save_pretrained()](/docs/transformers/v5.23.0/ko/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.save_pretrained)를 호출합니다. 자세한 내용은 위 메서드의 docstring을 참고하세요.
#### batch_decode[[transformers.NougatProcessor.batch_decode]]
```python
batch_decode(*args, **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L2054)
이 메서드는 모든 인수를 PreTrainedTokenizer의 [batch_decode()](/docs/transformers/v5.23.0/ko/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.batch_decode)로 전달합니다. 자세한 내용은 해당 메서드의 docstring을 참조하세요.
#### decode[[transformers.NougatProcessor.decode]]
```python
decode(*args, **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L2063)
이 메서드는 모든 인수를 PreTrainedTokenizer의 [decode()](/docs/transformers/v5.23.0/ko/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.decode)로 전달합니다. 자세한 내용은 해당 메서드의 docstring을 참조하세요.
#### post_process_generation[[transformers.NougatProcessor.post_process_generation]]
```python
post_process_generation(*args, **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/processing_nougat.py#L40)
이 메서드는 모든 인수를 NougatTokenizer의 `~PreTrainedTokenizer.post_process_generation`으로 전달합니다. 자세한 내용은 해당 메서드의 docstring을 참조하세요.