# ConvNeXT
## Aperçu
Le modèle ConvNeXT a été proposé dans [A ConvNet for the 2020s](https://huggingface.co/papers/2201.03545) par Zhuang Liu, Hanzi Mao, Chao-Yuan Wu, Christoph Feichtenhofer, Trevor Darrell et Saining Xie. ConvNeXT est un modèle purement convolutif (ConvNet), inspiré de la conception des Vision Transformers, qui prétend les surpasser.
L'abstract de l'article est le suivant :
*Les « Roaring 20s » de la reconnaissance visuelle ont commencé avec l’introduction des Vision Transformers (ViTs), qui ont rapidement supplanté les ConvNets en tant que modèle de classification d’images de l’état de l’art. En revanche, un ViT standard rencontre des difficultés lorsqu’il est appliqué à des tâches générales de vision par ordinateur, telles que la détection d’objets et la segmentation sémantique. Ce sont les Transformers hiérarchiques (par exemple, les Swin Transformers) qui ont réintroduit plusieurs a priori des ConvNets, rendant les Transformers pratiquement viables comme colonne vertébrale générique pour la vision et démontrant des performances remarquables sur une grande variété de tâches de vision. Cependant, l’efficacité de ces approches hybrides est encore largement attribuée à la supériorité intrinsèque des Transformers, plutôt qu’aux biais inductifs inhérents aux convolutions. Dans ce travail, nous réexaminons les espaces de conception et testons les limites de ce qu’un ConvNet pur peut accomplir. Nous « modernisons » progressivement un ResNet standard vers la conception d’un vision Transformer, et découvrons plusieurs composants clés qui contribuent à l’écart de performance au fil du processus. Le résultat de cette exploration est une famille de modèles ConvNet purs nommés ConvNeXt. Construits entièrement à partir de modules ConvNet standard, les ConvNeXt rivalisent favorablement avec les Transformers en termes de précision et de scalabilité, atteignant 87,8 % de précision top-1 sur ImageNet et surpassant les Swin Transformers sur la détection COCO et la segmentation ADE20K, tout en conservant la simplicité et l’efficacité des ConvNets standard.*
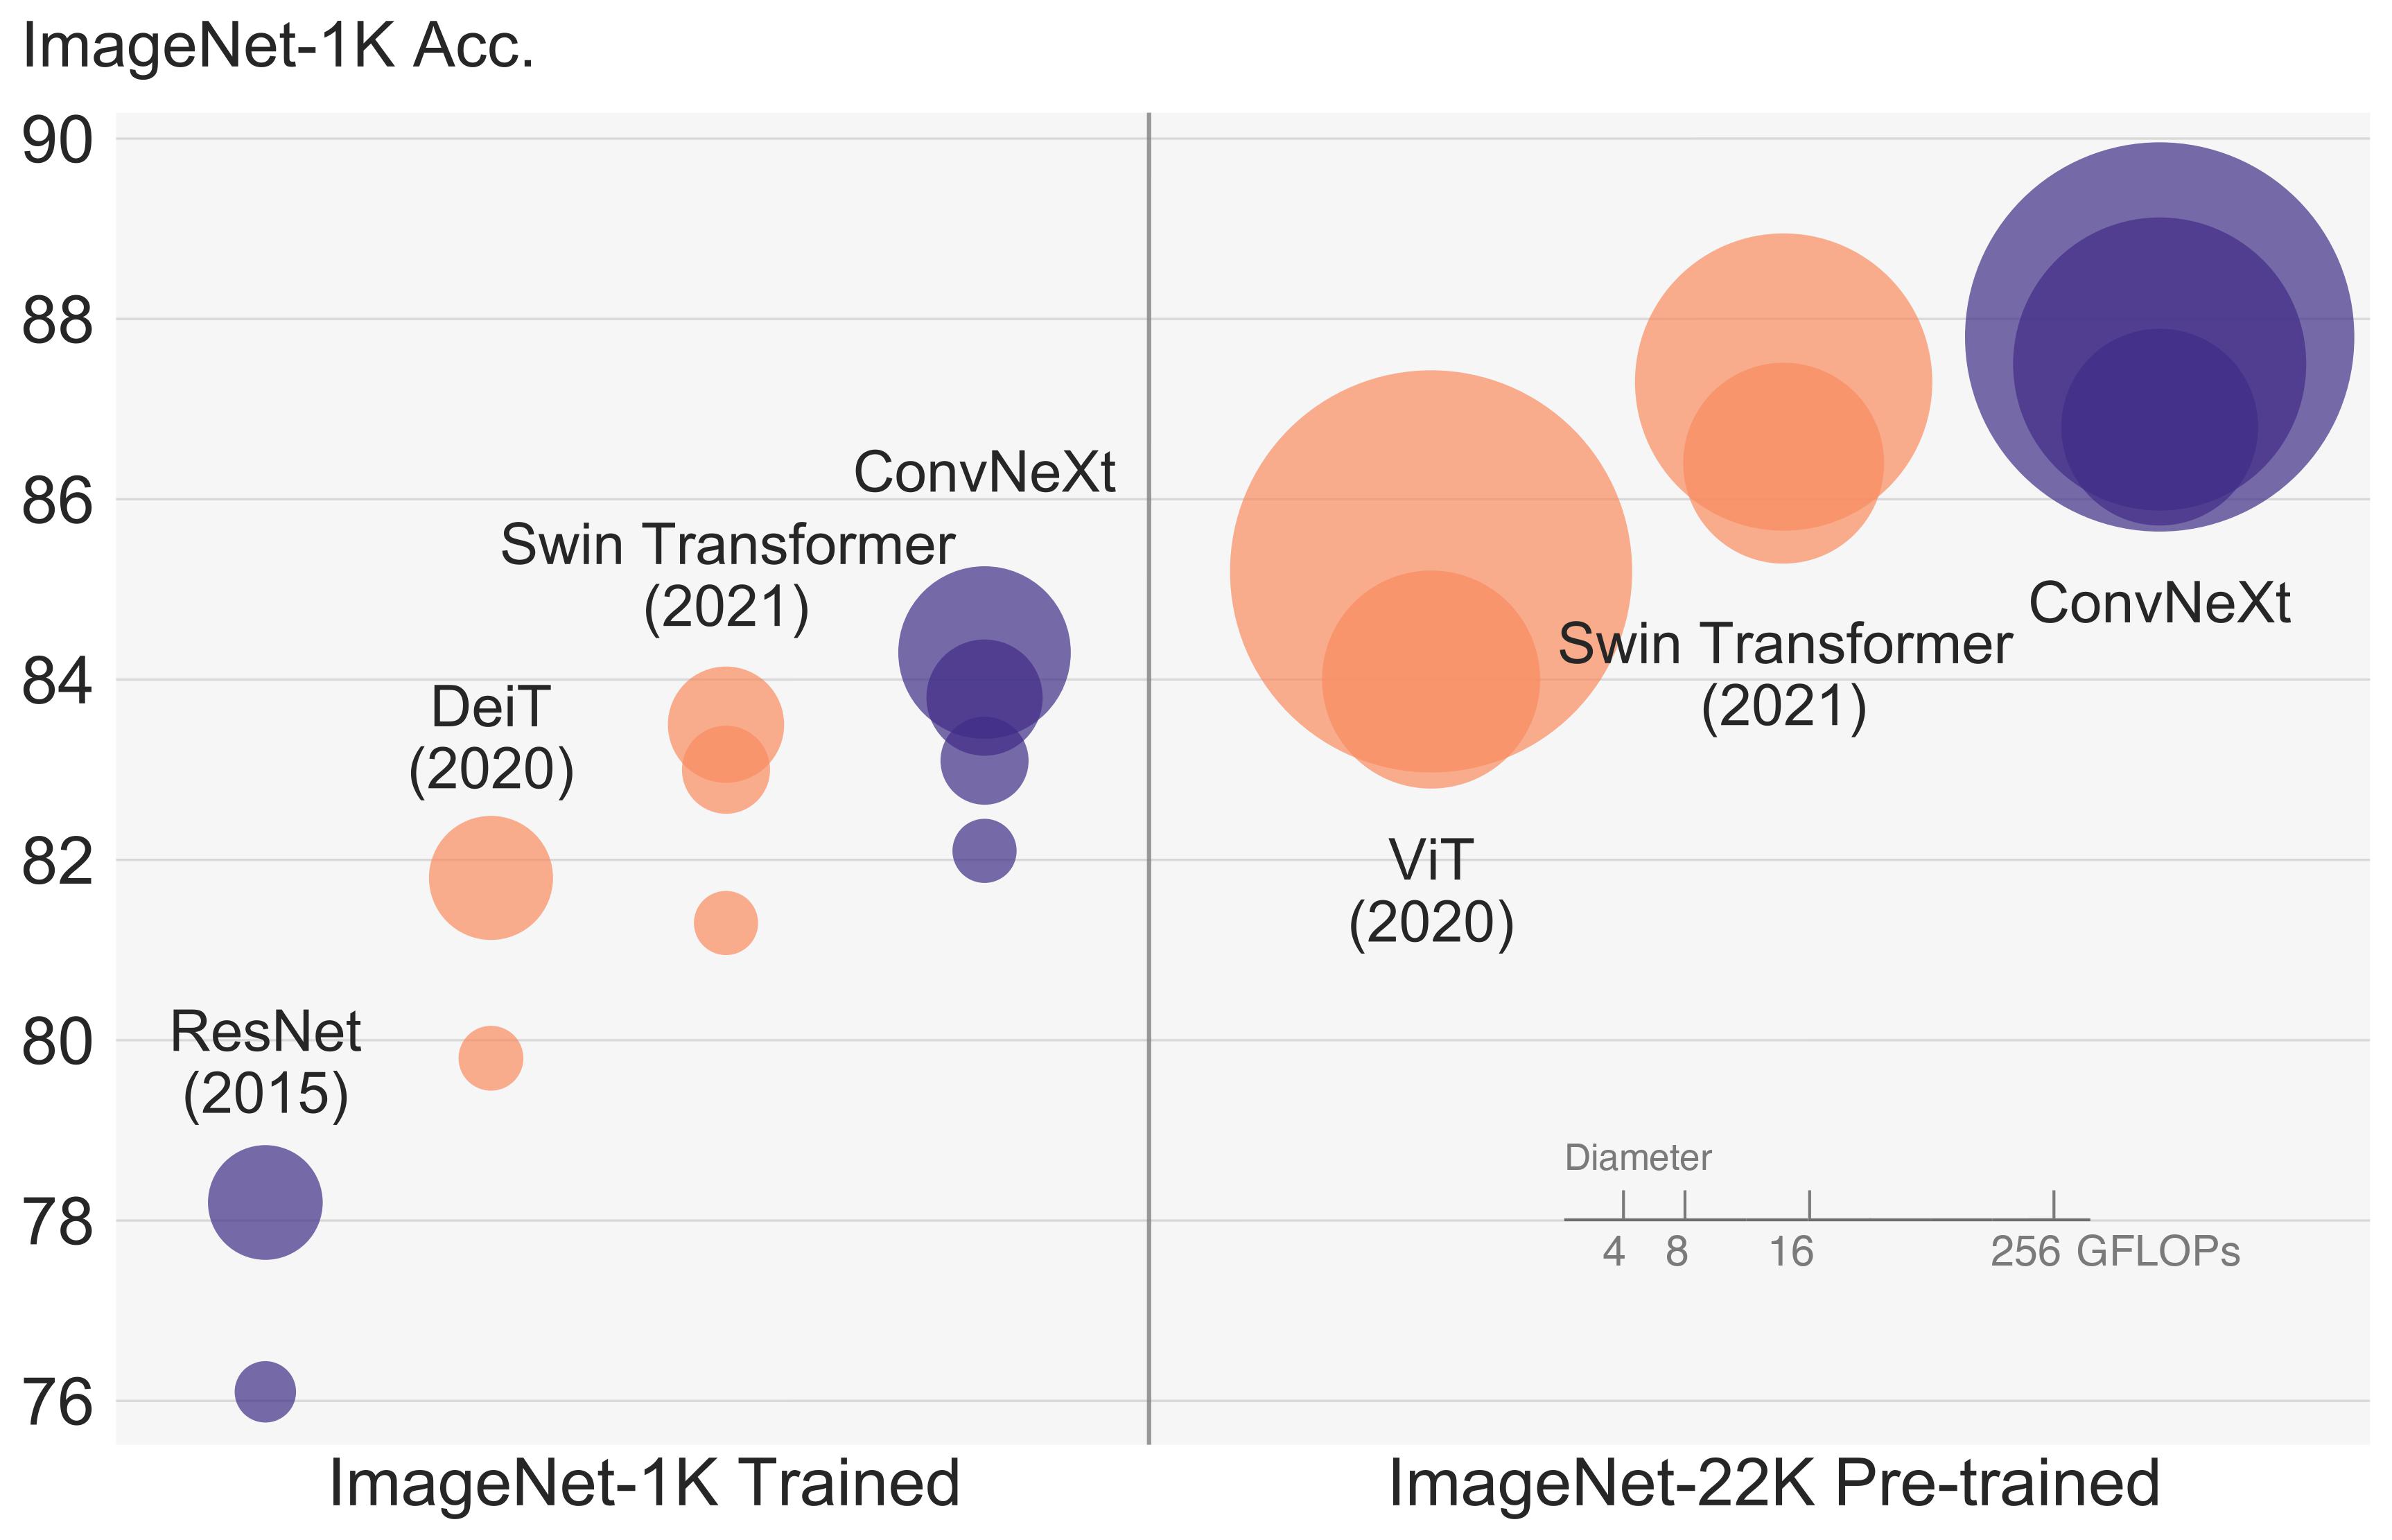 Architecture ConvNeXT. Issue de l’article original.
Ce modèle a été contribué par [nielsr](https://huggingface.co/nielsr). Le code d'origine peut être trouvé [ici](https://github.com/facebookresearch/ConvNeXt).
## Ressources
Une liste de ressources officielles Hugging Face et de la communauté (indiquées par 🌎) pour vous aider à démarrer avec ConvNeXT.
- [ConvNextForImageClassification](/docs/transformers/v5.23.0/fr/model_doc/convnext#transformers.ConvNextForImageClassification) est pris en charge par ce [notebook](https://colab.research.google.com/github/huggingface/notebooks/blob/main/examples/image_classification.ipynb).
- Voir aussi : [Guide de la tâche de classification d'images](../tasks/image_classification)
Si vous souhaitez soumettre une ressource pour qu'elle soit incluse ici, n'hésitez pas à ouvrir une Pull Request et nous la examinerons ! La ressource devrait idéalement démontrer quelque chose de nouveau plutôt que de dupliquer une ressource existante.
## ConvNextConfig[[transformers.ConvNextConfig]]
#### transformers.ConvNextConfig[[transformers.ConvNextConfig]]
```python
transformers.ConvNextConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, num_channels: int = 3, patch_size: int | list[int] | tuple[int, int] = 4, num_stages: int = 4, hidden_sizes: list[int] | tuple[int, ...] | None = (96, 192, 384, 768), depths: list[int] | tuple[int, ...] | None = (3, 3, 9, 3), hidden_act: str = 'gelu', initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, layer_scale_init_value: float = 1e-06, drop_path_rate: float | int = 0.0, image_size: int | list[int] | tuple[int, int] = 224, _out_features: list[str] | None = None, _out_indices: list[int] | None = None)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/convnext/configuration_convnext.py#L25)
**Paramètres :**
num_channels (`int`, *facultatif*, par défaut `3`) : Le nombre de canaux d'entrée.
patch_size (`Union[int, list[int], tuple[int, int]]`, *facultatif*, valeur par défaut `4`) : La taille (résolution) de chaque patch.
num_stages (`int`, *facultatif*, valeur par défaut : 4) : Le nombre de stades du modèle.
hidden_sizes (`Union[list[int], tuple[int, ...]]`, *facultatif*, valeur par défaut `(96, 192, 384, 768)`) : Dimensionnalité (taille cachée) à chaque étape du modèle.
depths (`Union[list[int], tuple[int, ...]]`, *facultatif*, valeur par défaut `(3, 3, 9, 3)`) : Profondeur de chaque couche du Transformer.
hidden_act (`str`, *facultatif*, par défaut `gelu`) : La fonction d'activation non linéaire (fonction ou chaîne de caractères) dans le décodeur. Par exemple, `"gelu"`, `"relu"`, `"silu"`, etc.
initializer_range (`float`, *facultatif*, valeur par défaut `0.02`) : L'écart-type de la truncated_normal_initializer utilisé pour l'initialisation de toutes les matrices de poids.
layer_norm_eps (`float`, *facultatif*, par défaut `1e-12`) : L'épsilon utilisé par les couches de normalisation par couche.
layer_scale_init_value (`float`, *facultatif*, valeur par défaut `1e-06`) : Échelle à utiliser dans les couches d'auto-attention. 0,1 pour les modèles de base, 1e-6 pour les grands modèles. Définir 0 pour désactiver l'échelle de couche.
drop_path_rate (`Union[float, int]`, *facultatif*, valeur par défaut `0.0`) : Taux de drop path pour la fusion des patches.
image_size (`Union[int, list[int], tuple[int, int]]`, *facultatif*, valeur par défaut `224`) : La taille (résolution) de chaque image.
Ceci est la classe de configuration destinée à stocker la configuration d'un ConvNextModel. Elle est utilisée pour instancier un modèle Convnext en fonction des arguments spécifiés, définissant ainsi l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de [facebook/convnext-tiny-224](https://huggingface.co/facebook/convnext-tiny-224)
Les objets de configuration héritent de [PreTrainedConfig](/docs/transformers/v5.23.0/fr/main_classes/configuration#transformers.PreTrainedConfig) et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de [PreTrainedConfig](/docs/transformers/v5.23.0/fr/main_classes/configuration#transformers.PreTrainedConfig) pour plus d’informations.
Exemple :
```python
>>> from transformers import ConvNextConfig, ConvNextModel
>>> # Initializing a ConvNext convnext-tiny-224 style configuration
>>> configuration = ConvNextConfig()
>>> # Initializing a model (with random weights) from the convnext-tiny-224 style configuration
>>> model = ConvNextModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## ConvNextImageProcessor[[transformers.ConvNextImageProcessor]]
#### transformers.ConvNextImageProcessor[[transformers.ConvNextImageProcessor]]
```python
transformers.ConvNextImageProcessor(**kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/convnext/image_processing_convnext.py#L43)
**Paramètres :**
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'shortest_edge' : 384}`) : Décris les dimensions d'entrée maximales pour le modèle.
default_to_square (`bool`, *kwargs*, *facultatif*, valeur par défaut `False`) : Indique s'il faut par défaut redimensionner l'image en un carré si la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, par défaut `3`) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir de l'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*, valeur par défaut `0.00392156862745098`) : Facteur de remise à l'échelle appliqué à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.5, 0.5, 0.5]`) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.5, 0.5, 0.5]`) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
crop_pct (`float`, *kwargs*, *facultatif*, valeur par défaut `self.crop_pct`) : Pourcentage de l'image à recadrer. N'a un effet que si size < 384.
Construit un processeur d’images ConvNextImageProcessor.
#### prétraiter[[transformers.ConvNextImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**Paramètres :**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Image à prétraiter. Attend une image unique ou un lot d'images dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *facultatif*) : Drapeau de développement pour des entrées supplémentaires de type image qui seront également prétraitées. N'utilisez ce paramètre que si le passage des entrées en tant qu'argument nommé ne fonctionne pas. Par exemple, `preprocess(images, masks=masks)` est l'option recommandée, mais cela peut entraîner des problèmes de priorité des arguments pour certains modèles. Dans ces cas, vous pouvez utiliser à la place `preprocess(images, image_like_inputs={"masks": masks})`.
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*) : Indique s'il faut par défaut redimensionner l'image en un carré lorsque la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*) : Facteur de redimensionnement à appliquer à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
**Retourne :** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionnaire de listes/tableaux/tenseurs renvoyé par la méthode __call__ (« pixel_values », etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *facultatif*) -- Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation.
Prétraitez une image ou un lot d'images.
## ConvNextImageProcessorPil[[transformers.ConvNextImageProcessorPil]]
#### transformers.ConvNextImageProcessorPil[[transformers.ConvNextImageProcessorPil]]
```python
transformers.ConvNextImageProcessorPil(**kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/convnext/image_processing_pil_convnext.py#L43)
**Paramètres :**
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'shortest_edge' : 384}`) : Décris les dimensions d'entrée maximales pour le modèle.
default_to_square (`bool`, *kwargs*, *facultatif*, valeur par défaut `False`) : Indique s'il faut par défaut redimensionner l'image en un carré si la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, par défaut `3`) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir de l'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*, valeur par défaut `0.00392156862745098`) : Facteur de remise à l'échelle appliqué à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.5, 0.5, 0.5]`) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.5, 0.5, 0.5]`) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
crop_pct (`float`, *kwargs*, *facultatif*, valeur par défaut `self.crop_pct`) : Pourcentage de l'image à recadrer. N'a un effet que si size < 384.
Construit un processeur d’images ConvNextImageProcessor.
#### prétraiter[[transformers.ConvNextImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**Paramètres :**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Image à prétraiter. Attend une image unique ou un lot d'images dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *facultatif*) : Drapeau de développement pour des entrées supplémentaires de type image qui seront également prétraitées. N'utilisez ce paramètre que si le passage des entrées en tant qu'argument nommé ne fonctionne pas. Par exemple, `preprocess(images, masks=masks)` est l'option recommandée, mais cela peut entraîner des problèmes de priorité des arguments pour certains modèles. Dans ces cas, vous pouvez utiliser à la place `preprocess(images, image_like_inputs={"masks": masks})`.
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*) : Indique s'il faut par défaut redimensionner l'image en un carré lorsque la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*) : Facteur de redimensionnement à appliquer à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
**Retourne :** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionnaire de listes/tableaux/tenseurs renvoyé par la méthode __call__ (« pixel_values », etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *facultatif*) -- Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation.
Prétraitez une image ou un lot d'images.
## ConvNextModel[[transformers.ConvNextModel]]
#### transformers.ConvNextModel[[transformers.ConvNextModel]]
```python
transformers.ConvNextModel(config: ConvNextConfig)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/convnext/modeling_convnext.py#L251)
**Paramètres :**
config ([ConvNextConfig](/docs/transformers/v5.23.0/fr/model_doc/convnext#transformers.ConvNextConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L’initialisation à partir d’un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/v5.23.0/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Le modèle Convnext brut, qui produit des états cachés bruts sans aucune tête spécifique au sommet.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/v5.23.0/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.ConvNextModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/convnext/modeling_convnext.py#L265)
**Paramètres :**
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`, *facultatif*) : Les tenseurs correspondant aux images d'entrée. Les valeurs de pixels peuvent être obtenues à l'aide de [ConvNextImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/convnext#transformers.ConvNextImageProcessor). Voir [ConvNextImageProcessor.__call__()](/docs/transformers/v5.23.0/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails (`processor_class` utilise [ConvNextImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/convnext#transformers.ConvNextImageProcessor) pour le traitement des images).
**Retourne :** `BaseModelOutputWithPoolingAndNoAttention` ou `tuple(torch.Tensor)`
Un `BaseModelOutputWithPoolingAndNoAttention` ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments en fonction de la configuration ([ConvNextConfig](/docs/transformers/v5.23.0/fr/model_doc/convnext#transformers.ConvNextConfig)) et des entrées.
La méthode forward du modèle [ConvNextModel](/docs/transformers/v5.23.0/fr/model_doc/convnext#transformers.ConvNextModel) surcharge la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **last_hidden_state** (`torch.Tensor` de forme `(batch_size, num_channels, height, width)`) -- Séquence d'états cachés à la sortie de la dernière couche du modèle.
- **pooler_output** (`torch.Tensor` de forme `(batch_size, hidden_size)`) -- État caché de la dernière couche après une opération de pooling sur les dimensions spatiales.
- **hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d'embedding, + un pour la sortie de chaque couche) de forme `(batch_size, num_channels, height, width)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
Exemple :
```python
```
## ConvNextForImageClassification[[transformers.ConvNextForImageClassification]]
#### transformers.ConvNextForImageClassification[[transformers.ConvNextForImageClassification]]
```python
transformers.ConvNextForImageClassification(config: ConvNextConfig)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/convnext/modeling_convnext.py#L293)
**Paramètres :**
config ([ConvNextConfig](/docs/transformers/v5.23.0/fr/model_doc/convnext#transformers.ConvNextConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L’initialisation à partir d’un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/v5.23.0/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Modèle ConvNext avec une tête de classification d'images au sommet (une couche linéaire au-dessus des fonctionnalités agrégées), par exemple pour ImageNet.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/v5.23.0/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.ConvNextForImageClassification.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, **kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/convnext/modeling_convnext.py#L311)
**Paramètres :**
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`, *facultatif*) : Les tenseurs correspondant aux images d'entrée. Les valeurs de pixels peuvent être obtenues à l'aide de [ConvNextImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/convnext#transformers.ConvNextImageProcessor). Voir [ConvNextImageProcessor.__call__()](/docs/transformers/v5.23.0/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails (`processor_class` utilise [ConvNextImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/convnext#transformers.ConvNextImageProcessor) pour le traitement des images).
labels (`torch.LongTensor` de forme `(batch_size,)`, *facultatif*) : Étiquettes pour le calcul de la perte de classification/régression d'image. Les indices doivent être dans `[0, ..., config.num_labels - 1]`. Si `config.num_labels == 1`, une perte de régression est calculée (perte du carré moyen). Si `config.num_labels > 1`, une perte de classification est calculée (entropie croisée).
**Retourne :** [ImageClassifierOutputWithNoAttention](/docs/transformers/v5.23.0/fr/main_classes/output#transformers.modeling_outputs.ImageClassifierOutputWithNoAttention) ou `tuple(torch.Tensor)`
Un [ImageClassifierOutputWithNoAttention](/docs/transformers/v5.23.0/fr/main_classes/output#transformers.modeling_outputs.ImageClassifierOutputWithNoAttention) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([ConvNextConfig](/docs/transformers/v5.23.0/fr/model_doc/convnext#transformers.ConvNextConfig)) et les entrées.
La méthode forward de [ConvNextForImageClassification](/docs/transformers/v5.23.0/fr/model_doc/convnext#transformers.ConvNextForImageClassification) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **loss** (`torch.Tensor` de forme `(1,)`, *facultatif*, renvoyé lorsque `labels` est fourni) -- Perte de classification (ou de régression si config.num_labels==1).
- **logits** (`torch.Tensor` de forme `(batch_size, config.num_labels)`) -- Scores de classification (ou de régression si config.num_labels==1) (avant SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque étape) de forme `(batch_size, num_channels, height, width)`. États cachés (également appelés cartes de caractéristiques) du modèle à la sortie de chaque étape.
Exemple :
```python
>>> from transformers import AutoImageProcessor, ConvNextForImageClassification
>>> import torch
>>> from datasets import load_dataset
>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/convnext-tiny-224")
>>> model = ConvNextForImageClassification.from_pretrained("facebook/convnext-tiny-224")
>>> inputs = image_processor(image, return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...
```