# MarkupLM
## Genel Bakış
MarkupLM modeli, Junlong Li, Yiheng Xu, Lei Cui ve Furu Wei tarafından [MarkupLM: Pre-training of Text and Markup Language for Visually-rich Document Understanding](https://huggingface.co/papers/2110.08518) makalesinde önerilmiştir. MarkupLM, ham metin belgeleri yerine HTML sayfalarına uygulanan bir BERT'tir. [LayoutLM](layoutlm)'de olduğu gibi, performansı iyileştirmek için modele ek gömme katmanları eklenmiştir.
Model, web sayfalarında soru cevaplama veya web sayfalarından bilgi çıkarma gibi görevler için kullanılabilir. 2 önemli ölçekte en iyi sonuçları elde eder:
- Web tabanlı yapısal okuma anlama için bir veri seti olan [WebSRC](https://x-lance.github.io/WebSRC/) (biraz SQuAD gibi ama web sayfaları için)
- [SWDE](https://www.researchgate.net/publication/221299838_From_one_tree_to_a_forest_a_unified_solution_for_structured_web_data_extraction), bir veri seti
web sayfalarından bilgi çıkarımı için (temelde web sayfalarında adlandırılmış varlık tanıma)
Makalenin özeti aşağıdaki gibidir:
*Metin, yerleşim ve görüntü ile çok modlu ön eğitim, Görsel Zengin Belge Anlama (VrDU) için önemli ilerlemeler kaydetmiştir, özellikle de taranmış belge görüntüleri gibi sabit yerleşimli belgeler için. Öte yandan, yerleşim bilgisi sabit olmayan ve görselleştirme için etkileşimli ve dinamik olarak render edilmesi gereken çok sayıda dijital belge hâlâ mevcuttur; bu durum, mevcut yerleşim tabanlı ön eğitim yaklaşımlarının uygulanmasını kolay kılmamaktadır. Bu makalede, HTML/XML tabanlı belgeler gibi işaret dili (markup language) iskeletine sahip belge anlama görevleri için MarkupLM öneriyoruz; bu modelde metin ve işaret bilgisi birlikte ön eğitilir. Deneysel sonuçlar, ön eğitilmiş MarkupLM'nin çeşitli belge anlama görevlerinde mevcut güçlü taban modellerini önemli ölçüde geride bıraktığını göstermektedir. Ön eğitilmiş model ve kod herkese açık olarak sunulacaktır.*
Bu model [nielsr](https://huggingface.co/nielsr) tarafından katkıda bulunmuştur. Orijinal kod [burada](https://github.com/microsoft/unilm/tree/master/markuplm) bulunabilir.
## Kullanım ipuçları
- `input_ids`'nin yanı sıra [forward()](/docs/transformers/v5.23.0/tr/model_doc/markuplm#transformers.MarkupLMModel.forward), `xpath_tags_seq` ve `xpath_subs_seq` olmak üzere 2 ek girdi bekler.
Bunlar, sırasıyla giriş dizisindeki her token için XPATH etiketleri ve alt indislerdir.
- Model için tüm verileri hazırlamak üzere [MarkupLMProcessor](/docs/transformers/v5.23.0/tr/model_doc/markuplm#transformers.MarkupLMProcessor) kullanılabilir. Daha fazla bilgi için [kullanım kılavuzuna](#usage-markuplmprocessor) bakın.
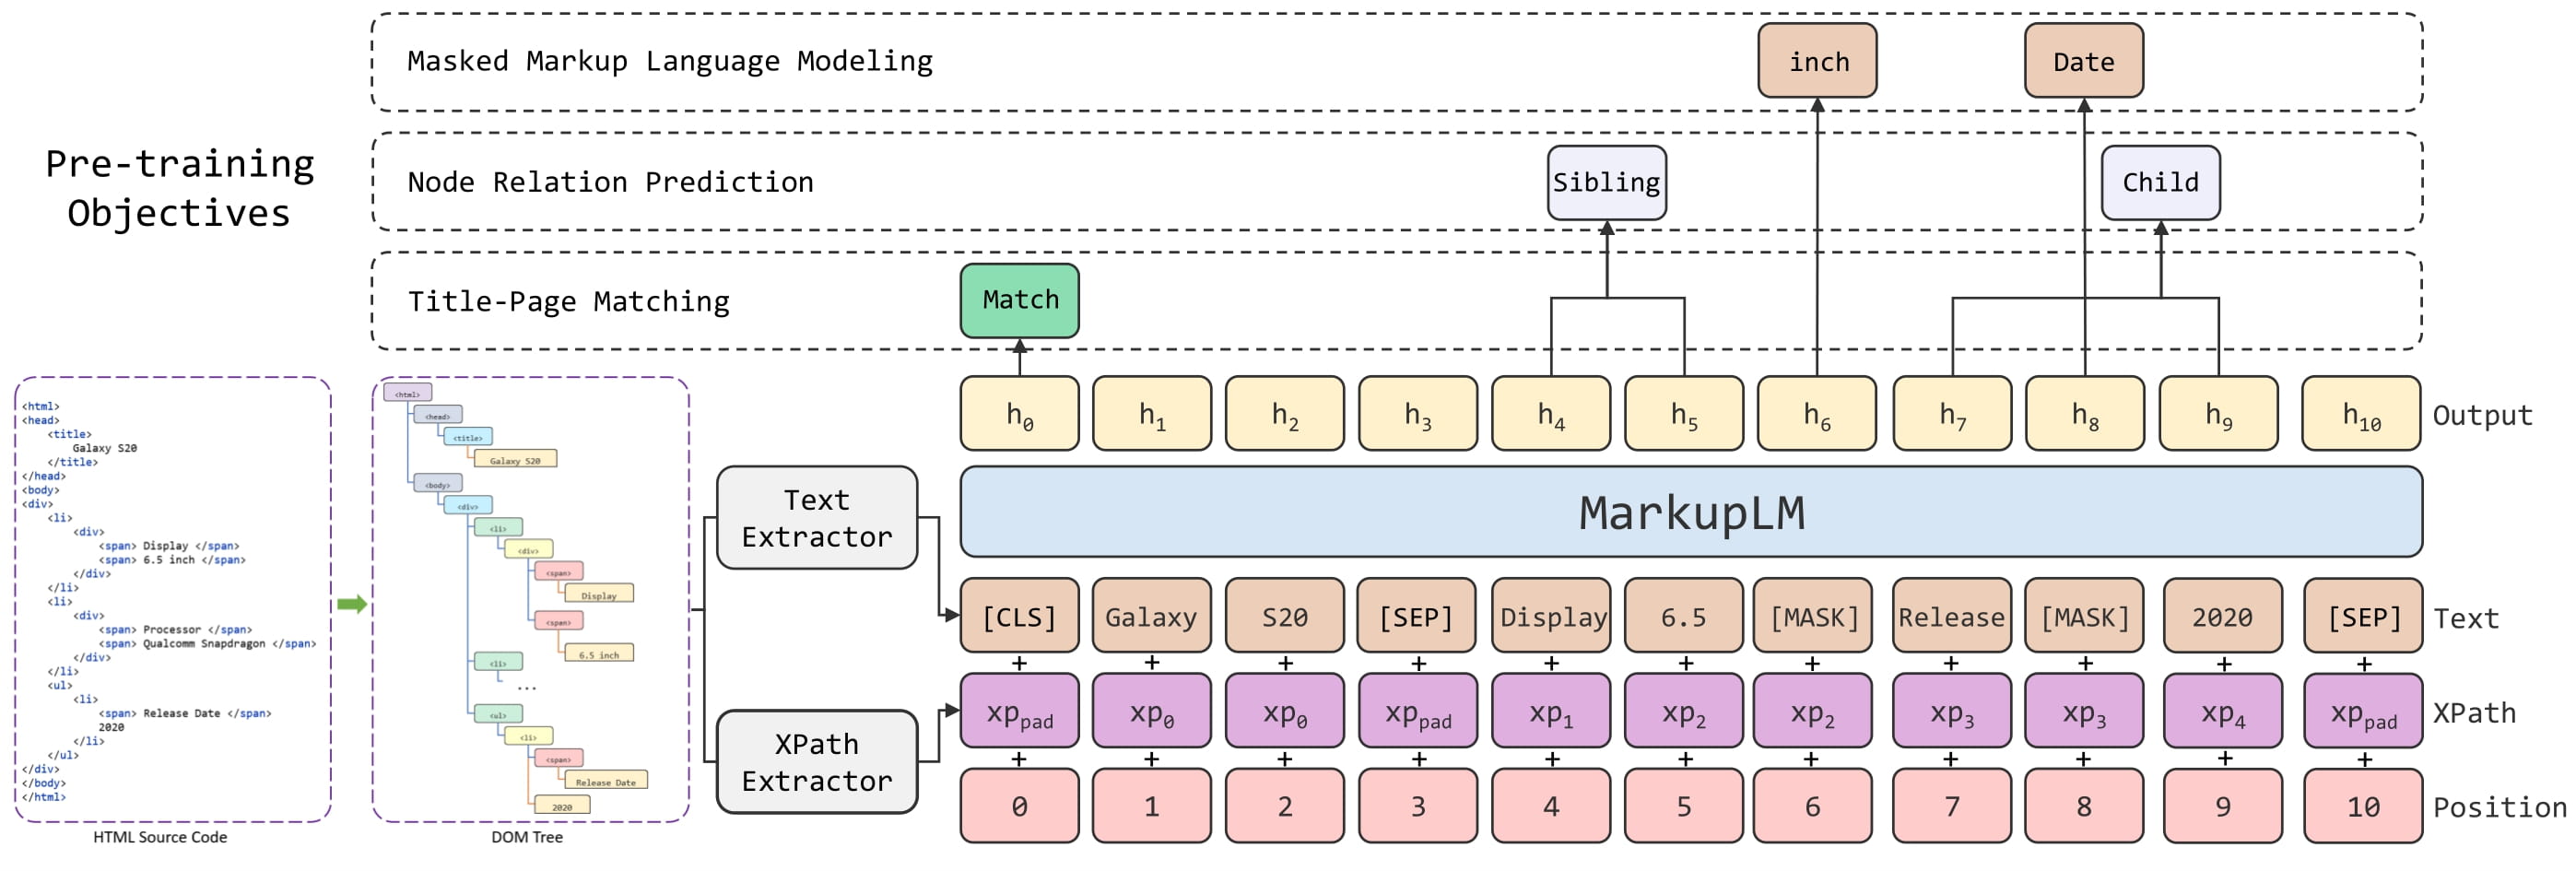 MarkupLM mimarisi. Orijinal makaleden alınmıştır.
## Kullanım: MarkupLMProcessor
Model için veri hazırlamanın en kolay yolu, içsel olarak bir özellik çıkarıcıyı ([MarkupLMFeatureExtractor](/docs/transformers/v5.23.0/tr/model_doc/markuplm#transformers.MarkupLMFeatureExtractor)) ve bir belirteçleyiciyi ([MarkupLMTokenizer](/docs/transformers/v5.23.0/tr/model_doc/markuplm#transformers.MarkupLMTokenizer) veya [MarkupLMTokenizerFast](/docs/transformers/v5.23.0/tr/model_doc/markuplm#transformers.MarkupLMTokenizer)) birleştiren [MarkupLMProcessor](/docs/transformers/v5.23.0/tr/model_doc/markuplm#transformers.MarkupLMProcessor)'ı kullanmaktır. Özellik çıkarıcı, HTML dizgilerindeki tüm düğümleri ve xpath'leri çıkarmak için kullanılır; bunlar daha sonra, onları modelin belirteç düzeyi girdilerine (`input_ids` vb.) dönüştüren belirteçleyiciye sağlanır. Sadece bu iki görevden birini işlemek istiyorsanız, özellik çıkarıcıyı ve belirteçleyiciyi ayrı ayrı kullanmaya devam edebilirsiniz.
```python
from transformers import MarkupLMFeatureExtractor, MarkupLMProcessor, MarkupLMTokenizerFast
feature_extractor = MarkupLMFeatureExtractor()
tokenizer = MarkupLMTokenizerFast.from_pretrained("microsoft/markuplm-base")
processor = MarkupLMProcessor(feature_extractor, tokenizer)
```
Kısaca, [MarkupLMProcessor](/docs/transformers/v5.23.0/tr/model_doc/markuplm#transformers.MarkupLMProcessor)’a HTML dizgileri (ve olası ek veriler) sağlanabilir ve bu işlemci, modelin beklediği girdileri oluşturur. İşlemci, içsel olarak önce [MarkupLMFeatureExtractor](/docs/transformers/v5.23.0/tr/model_doc/markuplm#transformers.MarkupLMFeatureExtractor)’ı kullanarak bir düğüm listesi ve karşılık gelen xpath’leri alır. Ardından düğümler ve xpath’ler, bunları token düzeyinde `input_ids`, `attention_mask`, `token_type_ids`, `xpath_subs_seq`, `xpath_tags_seq` olarak dönüştüren [MarkupLMTokenizer](/docs/transformers/v5.23.0/tr/model_doc/markuplm#transformers.MarkupLMTokenizer) veya [MarkupLMTokenizerFast](/docs/transformers/v5.23.0/tr/model_doc/markuplm#transformers.MarkupLMTokenizer)’e iletilir. İsteğe bağlı olarak, işlemciye düğüm etiketleri sağlanabilir ve bunlar token düzeyinde `labels` olarak dönüştürülür.
[MarkupLMFeatureExtractor](/docs/transformers/v5.23.0/tr/model_doc/markuplm#transformers.MarkupLMFeatureExtractor), HTML ve XML dosyalarından veri çekmek için kullanılan Python kütüphanesi olan [Beautiful Soup](https://www.crummy.com/software/BeautifulSoup/bs4/doc/)'ı kullanır. Dilerseniz kendi ayrıştırma çözümünüzü kullanmaya devam edebilir ve düğümleri ile xpath'leri [MarkupLMTokenizer](/docs/transformers/v5.23.0/tr/model_doc/markuplm#transformers.MarkupLMTokenizer) veya [MarkupLMTokenizerFast](/docs/transformers/v5.23.0/tr/model_doc/markuplm#transformers.MarkupLMTokenizer) için kendiniz sağlayabilirsiniz.
Toplamda, işlemci tarafından desteklenen 5 kullanım senaryosu vardır. Aşağıda bunların tümünü listeliyoruz. Bu kullanım senaryolarının her birinin hem toplu (batched) hem de toplu olmayan (non-batched) girdilerle çalıştığını not edelim (bunları toplu olmayan girdiler için gösteriyoruz).
**Kullanım durumu 1: web sayfası sınıflandırma (eğitim, çıkarım) + token sınıflandırma (çıkarım), parse_html = True**
Bu, en basit durumdur; işlemci, HTML'den tüm düğümleri ve xpath'leri almak için özellik çıkarıcısını kullanır.
```python
from transformers import MarkupLMProcessor
processor = MarkupLMProcessor.from_pretrained("microsoft/markuplm-base")
html_string = """
Hello world
Welcome
Here is my website.
"""
# note that you can also add provide all tokenizer parameters here such as padding, truncation
encoding = processor(html_string, return_tensors="pt").to(model.device)
print(encoding.keys())
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'xpath_tags_seq', 'xpath_subs_seq'])
```
**Kullanım durumu 2: web sayfası sınıflandırma (eğitim, çıkarım) + token sınıflandırma (çıkarım), parse_html=False**
Eğer tüm düğümler ve xpath'ler zaten elde edilmişse, özellik çıkarıcıya (feature extractor) gerek yoktur. Bu durumda, düğümleri ve ilgili xpath'leri işlemciye (processor) kendiniz sağlamalı ve `parse_html`'in `False` olarak ayarlandığından emin olmalısınız.
```python
from transformers import MarkupLMProcessor
processor = MarkupLMProcessor.from_pretrained("microsoft/markuplm-base")
processor.parse_html = False
nodes = ["hello", "world", "how", "are"]
xpaths = ["/html/body/div/li[1]/div/span", "/html/body/div/li[1]/div/span", "html/body", "html/body/div"]
encoding = processor(nodes=nodes, xpaths=xpaths, return_tensors="pt").to(model.device)
print(encoding.keys())
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'xpath_tags_seq', 'xpath_subs_seq'])
```
**Kullanım durumu 3: token sınıflandırma (eğitim), parse_html=False**
Token sınıflandırma görevleri (örneğin [SWDE](https://paperswithcode.com/dataset/swde)) için, bir model eğitmek amacıyla ilgili düğüm etiketleri de sağlanabilir. İşleyici (processor) bu etiketleri token düzeyinde `labels` olarak dönüştürür. Varsayılan olarak, bir kelimenin yalnızca ilk wordpiece'i etiketlenir ve kalan wordpiece'ler, PyTorch'un CrossEntropyLoss sınıfındaki `ignore_index` değeri olan -100 ile etiketlenir. Bir kelimenin tüm wordpiece'lerinin etiketlenmesini istiyorsanız, tokenizer'ı `only_label_first_subword` parametresi `False` olarak ayarlanarak başlatabilirsiniz.
```python
from transformers import MarkupLMProcessor
processor = MarkupLMProcessor.from_pretrained("microsoft/markuplm-base")
processor.parse_html = False
nodes = ["hello", "world", "how", "are"]
xpaths = ["/html/body/div/li[1]/div/span", "/html/body/div/li[1]/div/span", "html/body", "html/body/div"]
node_labels = [1, 2, 2, 1]
encoding = processor(nodes=nodes, xpaths=xpaths, node_labels=node_labels, return_tensors="pt").to(model.device)
print(encoding.keys())
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'xpath_tags_seq', 'xpath_subs_seq', 'labels'])
```
**Kullanım durumu 4: web sayfası soru-cevap (çıkarsama), parse_html=True**
Web sayfalarındaki soru cevaplandırma görevleri için işlemciye bir soru sağlayabilirsiniz. Varsayılan olarak, işlemci tüm düğümleri ve xpath'leri almak için özellik çıkarıcıyı kullanır ve [CLS] soru belirteçleri [SEP] kelime belirteçleri [SEP] oluşturur.
```python
from transformers import MarkupLMProcessor
processor = MarkupLMProcessor.from_pretrained("microsoft/markuplm-base")
html_string = """
Hello world
Welcome
My name is Niels.
"""
question = "What's his name?"
encoding = processor(html_string, questions=question, return_tensors="pt").to(model.device)
print(encoding.keys())
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'xpath_tags_seq', 'xpath_subs_seq'])
```
**Kullanım durumu 5: web sayfası soru-cevap (çıkarsama), parse_html=False**
Soru yanıtlama görevleri (WebSRC gibi) için işlemciye bir soru sağlayabilirsiniz. Tüm düğümleri ve xpath'leri kendiniz çıkardıysanız, bunları doğrudan işlemciye verebilirsiniz. `parse_html`'in `False` olarak ayarlandığından emin olun.
```python
from transformers import MarkupLMProcessor
processor = MarkupLMProcessor.from_pretrained("microsoft/markuplm-base")
processor.parse_html = False
nodes = ["hello", "world", "how", "are"]
xpaths = ["/html/body/div/li[1]/div/span", "/html/body/div/li[1]/div/span", "html/body", "html/body/div"]
question = "What's his name?"
encoding = processor(nodes=nodes, xpaths=xpaths, questions=question, return_tensors="pt").to(model.device)
print(encoding.keys())
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'xpath_tags_seq', 'xpath_subs_seq'])
```
## Kaynaklar
- [Demo defterleri](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/MarkupLM)
- [Metin sınıflandırma görevi kılavuzu](../tasks/sequence_classification)
- [Token sınıflandırma görevi kılavuzu](../tasks/token_classification)
- [Soru yanıtlama görevi kılavuzu](../tasks/question_answering)
## MarkupLMConfig[[transformers.MarkupLMConfig]]
#### transformers.MarkupLMConfig[[transformers.MarkupLMConfig]]
```python
transformers.MarkupLMConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 30522, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.1, attention_probs_dropout_prob: float | int = 0.1, max_position_embeddings: int = 512, type_vocab_size: int = 2, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, pad_token_id: int | None = 0, bos_token_id: int | None = 0, eos_token_id: int | list[int] | None = 2, max_xpath_tag_unit_embeddings: int = 256, max_xpath_subs_unit_embeddings: int = 1024, tag_pad_id: int = 216, subs_pad_id: int = 1001, xpath_unit_hidden_size: int = 32, max_depth: int = 50, use_cache: bool = True, classifier_dropout: float | int | None = None)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/configuration_markuplm.py#L24)
**Parametreler:**
vocab_size (`int`, *isteğe bağlı*, varsayılan `30522`) : Modelin sözlük boyutu. `input_ids` tarafından temsil edilebilecek farklı token sayısını tanımlar.
hidden_size (`int`, *isteğe bağlı*, varsayılan `768`) : Gizli temsillerin boyutu.
num_hidden_layers (`int`, *isteğe bağlı*, varsayılan `12`) : Transformer decoder'ındaki gizli katman sayısı.
num_attention_heads (`int`, *isteğe bağlı*, varsayılan `12`) : Transformer decoder'ındaki her dikkat katmanı için dikkat başı sayısı.
intermediate_size (`int`, *isteğe bağlı*, varsayılan `3072`) : MLP temsil boyutu.
hidden_act (`str`, *isteğe bağlı*, varsayılan `gelu`) : Çözücüdeki doğrusal olmayan aktivasyon fonksiyonu (fonksiyon veya dize). Örneğin, `"gelu"`, `"relu"`, `"silu"` vb.
hidden_dropout_prob (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.1`) : Gömme, kodlayıcı ve havuzlayıcıdaki tüm tam bağlı katmanlar için dropout olasılığı.
attention_probs_dropout_prob (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.1`) : Dikkat olasılıkları için dropout oranı.
max_position_embeddings (`int`, *isteğe bağlı*, varsayılan `512`) : Bu modelin kullanılabileceği maksimum dizi uzunluğu.
type_vocab_size (`int`, *isteğe bağlı*, varsayılan `2`) : `token_type_ids` için sözlük boyutu.
initializer_range (`float`, *opsiyonel*, varsayılan `0.02`) : Tüm ağırlık matrislerini başlatmak için kullanılan truncated_normal_initializer'ın standart sapması.
layer_norm_eps (`float`, *opsiyonel*, varsayılan `1e-12`) : Katman normalizasyonu katmanları tarafından kullanılan epsilon.
pad_token_id (`int`, *isteğe bağlı*, varsayılan `0`) : Sözlükte dolgu için kullanılan token kimliği.
bos_token_id (`int`, *isteğe bağlı*, varsayılan `0`) : Sözlükte akış başlangıcı için kullanılan token kimliği.
eos_token_id (`Union[int, list[int]]`, *isteğe bağlı*, varsayılan `2`) : Sözlükte akış sonu için kullanılan token kimliği.
max_xpath_tag_unit_embeddings (`int`, *isteğe bağlı*, varsayılan 256) : xpath etiket birimi gömme (embedding) tarafından kullanılabilecek en yüksek değer. Genellikle, olası durumlara karşı bu değeri büyük bir sayı olarak ayarlayın (ör. 256).
max_xpath_subs_unit_embeddings (`int`, *isteğe bağlı*, varsayılan 1024) : xpath alt dizin birimi gömme (embedding) tarafından kullanılabilecek en yüksek değer. Genellikle, olası durumlara karşı bu değeri büyük bir sayı olarak ayarlayın (ör. 1024).
tag_pad_id (`int`, *isteğe bağlı*, varsayılan 216) : xpath etiketlerindeki dolgu belirtecinin kimliği.
subs_pad_id (`int`, *isteğe bağlı*, varsayılan 1001) : xpath alt dizinlerinde dolgu belirtecinin kimliği.
xpath_unit_hidden_size (`int`, *isteğe bağlı*, varsayılan 32) : xpath'teki her birim için gizli boyut.
max_depth (`int`, *isteğe bağlı*, varsayılan 50) : xpath'teki maksimum derinlik.
use_cache (`bool`, *isteğe bağlı*, varsayılan `True`) : Modelin son anahtar/değer dikkatlerini döndürüp döndürmeyeceğini belirtir (tüm modellerde kullanılmaz). Yalnızca `config.is_decoder=True` olduğunda veya model yalnızca çözücü tabanlı üretken bir model olduğunda geçerlidir.
classifier_dropout (`Union[float, int]`, *isteğe bağlı*) : Sınıflandırıcı için dropout oranı.
Bu, bir MarkupLMModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Markuplm modelini örneklemek ve model mimarisini tanımlamak için kullanılır. Varsayılanlarla bir yapılandırma örneği oluşturmak, [microsoft/markuplm-base](https://huggingface.co/microsoft/markuplm-base) yapılandırmasına benzer bir yapılandırma üretir.
Yapılandırma nesneleri [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) sınıfından türetilir ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) belgesini okuyun.
Örnekler:
```python
>>> from transformers import MarkupLMModel, MarkupLMConfig
>>> # Initializing a MarkupLM microsoft/markuplm-base style configuration
>>> configuration = MarkupLMConfig()
>>> # Initializing a model from the microsoft/markuplm-base style configuration
>>> model = MarkupLMModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## MarkupLMFeatureExtractor[[transformers.MarkupLMFeatureExtractor]]
#### transformers.MarkupLMFeatureExtractor[[transformers.MarkupLMFeatureExtractor]]
```python
transformers.MarkupLMFeatureExtractor(**kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/feature_extraction_markuplm.py#L32)
Bir MarkupLM özellik çıkarıcısı oluşturur. Bu, HTML dizgelerinden düğümlerin ve karşılık gelen xpath'lerin listesini almak için kullanılabilir.
Bu özellik çıkarıcı, ana yöntemlerin çoğunu içeren `PreTrainedFeatureExtractor()` sınıfından devralır. Kullanıcıların bu yöntemler hakkında daha fazla bilgi için bu üst sınıfa başvurması gerekir.
#### __call__[[transformers.MarkupLMFeatureExtractor.__call__]]
```python
__call__(html_strings)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/feature_extraction_markuplm.py#L98)
**Parametreler:**
html_strings (`str`, `list[str]`) : Düğümlerin ve karşılık gelen xpath'lerin çıkarılacağı HTML dizgesi veya HTML dizgileri grubu.
**Dönüş:** [BatchFeature](/docs/transformers/v5.23.0/tr/main_classes/feature_extractor#transformers.BatchFeature)
Aşağıdaki alanlara sahip bir [BatchFeature](/docs/transformers/v5.23.0/tr/main_classes/feature_extractor#transformers.BatchFeature):
- **nodes** -- Düğümler.
- **xpaths** -- İlgili xpaths.
Model için bir veya birkaç HTML dizesini hazırlamak için ana yöntem.
Örnekler:
```python
>>> from transformers import MarkupLMFeatureExtractor
>>> page_name_1 = "page1.html"
>>> page_name_2 = "page2.html"
>>> page_name_3 = "page3.html"
>>> with open(page_name_1) as f:
... single_html_string = f.read()
>>> feature_extractor = MarkupLMFeatureExtractor()
>>> # single example
>>> encoding = feature_extractor(single_html_string)
>>> print(encoding.keys())
>>> # dict_keys(['nodes', 'xpaths'])
>>> # batched example
>>> multi_html_strings = []
>>> with open(page_name_2) as f:
... multi_html_strings.append(f.read())
>>> with open(page_name_3) as f:
... multi_html_strings.append(f.read())
>>> encoding = feature_extractor(multi_html_strings)
>>> print(encoding.keys())
>>> # dict_keys(['nodes', 'xpaths'])
```
## MarkupLMTokenizer[[transformers.MarkupLMTokenizer]]
#### transformers.MarkupLMTokenizer[[transformers.MarkupLMTokenizer]]
```python
transformers.MarkupLMTokenizer(tags_dict, vocab: str | dict[str, int] | list[tuple[str, float]] | None = None, merges: str | list[str] | None = None, errors = 'replace', bos_token = '', eos_token = '', sep_token = '', cls_token = '', unk_token = '', pad_token = '', mask_token = '', add_prefix_space = False, max_depth = 50, max_width = 1000, pad_width = 1001, pad_token_label = -100, only_label_first_subword = True, trim_offsets = False, **kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/tokenization_markuplm.py#L91)
**Parametreler:**
vocab (`str` veya `dict[str, int]`, *isteğe bağlı*) : Özel sözlük. Sağlanmazsa, sözlük `vocab_file` içinden yüklenir.
merges (`str` veya `list[str]`, *isteğe bağlı*) : Özel birleştirme listesi. Sağlanmazsa, birleştirmeler `merges_file` içinden yüklenir.
errors (`str`, *isteğe bağlı*, varsayılan `"replace"`) : Baytların UTF-8'e çözümlenirken izlenecek paradigma. Daha fazla bilgi için [bytes.decode](https://docs.python.org/3/library/stdtypes.html#bytes.decode)'e bakın.
bos_token (`str`, *isteğe bağlı*, varsayılan `""`) : Ön eğitim sırasında kullanılan dizinin başlangıç jetonu. Bir dizi sınıflandırıcı jetonu olarak kullanılabilir. Özel jetonlar kullanılarak bir dizi oluşturulduğunda, dizinin başlangıcı için kullanılan jeton bu değildir. Kullanılan jeton `cls_token`'dur.
eos_token (`str`, *isteğe bağlı*, varsayılan `""`) : Sıra sonu belirteci. Özel belirteçler kullanılarak bir sıra oluşturulduğunda, sıra sonu için kullanılan belirteç bu değildir. Kullanılan belirteç `sep_token`'tur.
sep_token (`str`, *isteğe bağlı*, varsayılan `""`) : Birden fazla diziden bir dizi oluşturulurken kullanılan ayraç belirteci, örneğin dizi sınıflandırması için iki dizi veya soru cevaplamada bir metin ve bir soru için. Özel belirteçlerle oluşturulan bir dizinin son belirteci olarak da kullanılır.
cls_token (`str`, *isteğe bağlı*, varsayılan `""`) : Sıralı sınıflandırma (token başına sınıflandırma yerine tüm sıranın sınıflandırılması) yapılırken kullanılan sınıflandırıcı jetonu. Özel jetonlarla oluşturulduğunda sıranın ilk jetonudur.
unk_token (`str`, *isteğe bağlı*, varsayılan `""`) : Bilinmeyen token. Sözlükte yer almayan bir token, bir kimliğe dönüştürülemez ve bunun yerine bu token olarak ayarlanır.
pad_token (`str`, *isteğe bağlı*, varsayılan `""`) : Dolgu için kullanılan jeton, örneğin farklı uzunluklardaki dizileri toplu işleme (batching) sırasında.
mask_token (`str`, *isteğe bağlı*, varsayılan `""`) : Değerleri maskelemek için kullanılan belirteç. Bu, modelin maskeli dil modelleme ile eğitildiğinde kullanılan belirteçtir. Modelin tahmin etmeye çalışacağı belirteç budur.
add_prefix_space (`bool`, *isteğe bağlı*, varsayılan `False`) : Girdinin başına bir boşluk eklenip eklenmeyeceğini belirtir. Bu, baştaki kelimenin diğer kelimelerle aynı şekilde ele alınmasını sağlar. (RoBERTa tokenizer, kelimelerin başlangıcını önceki boşlukla tespit eder).
MarkupLM tokenizer'ı oluşturun. Baytabazlı Byte-Pair-Encoding (BPE) üzerine kuruludur.
[MarkupLMTokenizer](/docs/transformers/v5.23.0/tr/model_doc/markuplm#transformers.MarkupLMTokenizer), HTML dizgilerini token düzeyinde `input_ids`, `attention_mask`, `token_type_ids`, `xpath_tags_seq` ve `xpath_tags_seq` değerlerine dönüştürmek için kullanılabilir. Bu tokenizer, ana yöntemlerin çoğunu içeren ve `tokenizers` arka ucunun her zaman örneklenmesini sağlayan [TokenizersBackend](/docs/transformers/v5.23.0/tr/main_classes/tokenizer#transformers.TokenizersBackend) sınıfından devralır.
Kullanıcıların bu yöntemler hakkında daha fazla bilgi için bu üst sınıfa başvurması gerekir.
#### build_inputs_with_special_tokens[[transformers.MarkupLMTokenizer.build_inputs_with_special_tokens]]
```python
build_inputs_with_special_tokens(token_ids_0: list[int], token_ids_1: list[int] | None = None)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/tokenization_markuplm.py#L952)
**Parametreler:**
token_ids_0 (`list[int]`) : Özel jetonların ekleneceği kimliklerin listesi.
token_ids_1 (`list[int]`, *isteğe bağlı*) : Sıralı çiftler için isteğe bağlı ikinci kimlik listesi.
**Dönüş:** `list[int]`
Uygun özel jetonlarla [girdi kimlikleri](../glossary#input-ids) listesi.
Sınıflandırma görevleri için bir dizi veya dizi çiftinden model girdilerini birleştirerek ve özel jetonlar ekleyerek oluşturun. RoBERTa dizisi aşağıdaki biçime sahiptir:
- tek dizi: ` X `
- dizi çifti: ` A B `
#### get_special_tokens_mask[[transformers.MarkupLMTokenizer.get_special_tokens_mask]]
```python
get_special_tokens_mask(token_ids_0: list[int], token_ids_1: list[int] | None = None, already_has_special_tokens: bool = False)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/tokenization_utils_base.py#L1337)
**Parametreler:**
token_ids_0 : (muhtemelen biçimlendirilmiş) dizinin kimlik listesi.
token_ids_1 `already_has_special_tokens=True` olduğunda kullanılmaz. Bu durumda None olmalıdır.
already_has_special_tokens : Dizi, özel jetonlarla zaten biçimlendirilmiş mi?
**Dönüş:** [0, 1] aralığında tamsayılar listesi
özel bir jeton için 1, bir dizi jetonu için 0.
Özel tokenlar eklenmemiş bir token listesinden dizi kimliklerini (sequence ids) alın.
Hızlı tokenizörler için veri toplayıcılar, biçimlendirilmiş bir dizinin üzerine bir maske oluşturmak üzere bunu `already_has_special_tokens=True` ile çağırır. Bu durumda, maskenin hesaplanması `all_special_ids` içinde üyelik kontrolü yapılarak gerçekleştirilir.
#### create_token_type_ids_from_sequences[[transformers.MarkupLMTokenizer.create_token_type_ids_from_sequences]]
```python
create_token_type_ids_from_sequences(token_ids_0: list[int], token_ids_1: list[int] | None = None)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/tokenization_markuplm.py#L975)
**Parametreler:**
token_ids_0 (`list[int]`) : Kimlik listesi.
token_ids_1 (`list[int]`, *isteğe bağlı*) : Sıralı çiftler için isteğe bağlı ikinci kimlik listesi.
**Dönüş:** `list[int]`
Sıfırlar listesi.
Sıralama çifti sınıflandırma görevinde kullanılacak şekilde, iletilen iki diziden bir maske oluşturun. RoBERTa, belirteç türü kimliklerini kullanmadığından, sıfırlardan oluşan bir liste döndürülür.
#### save_vocabulary[[transformers.MarkupLMTokenizer.save_vocabulary]]
```python
save_vocabulary(save_directory: str, filename_prefix: str | None = None)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/tokenization_markuplm.py#L997)
## MarkupLMTokenizerFast[[transformers.MarkupLMTokenizer]]
#### transformers.MarkupLMTokenizer[[transformers.MarkupLMTokenizer]]
```python
transformers.MarkupLMTokenizer(tags_dict, vocab: str | dict[str, int] | list[tuple[str, float]] | None = None, merges: str | list[str] | None = None, errors = 'replace', bos_token = '', eos_token = '', sep_token = '', cls_token = '', unk_token = '', pad_token = '', mask_token = '', add_prefix_space = False, max_depth = 50, max_width = 1000, pad_width = 1001, pad_token_label = -100, only_label_first_subword = True, trim_offsets = False, **kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/tokenization_markuplm.py#L91)
**Parametreler:**
vocab (`str` veya `dict[str, int]`, *isteğe bağlı*) : Özel sözlük. Sağlanmazsa, sözlük `vocab_file` içinden yüklenir.
merges (`str` veya `list[str]`, *isteğe bağlı*) : Özel birleştirme listesi. Sağlanmazsa, birleştirmeler `merges_file` içinden yüklenir.
errors (`str`, *isteğe bağlı*, varsayılan `"replace"`) : Baytların UTF-8'e çözümlenirken izlenecek paradigma. Daha fazla bilgi için [bytes.decode](https://docs.python.org/3/library/stdtypes.html#bytes.decode)'e bakın.
bos_token (`str`, *isteğe bağlı*, varsayılan `""`) : Ön eğitim sırasında kullanılan dizinin başlangıç jetonu. Bir dizi sınıflandırıcı jetonu olarak kullanılabilir. Özel jetonlar kullanılarak bir dizi oluşturulduğunda, dizinin başlangıcı için kullanılan jeton bu değildir. Kullanılan jeton `cls_token`'dur.
eos_token (`str`, *isteğe bağlı*, varsayılan `""`) : Sıra sonu belirteci. Özel belirteçler kullanılarak bir sıra oluşturulduğunda, sıra sonu için kullanılan belirteç bu değildir. Kullanılan belirteç `sep_token`'tur.
sep_token (`str`, *isteğe bağlı*, varsayılan `""`) : Birden fazla diziden bir dizi oluşturulurken kullanılan ayraç belirteci, örneğin dizi sınıflandırması için iki dizi veya soru cevaplamada bir metin ve bir soru için. Özel belirteçlerle oluşturulan bir dizinin son belirteci olarak da kullanılır.
cls_token (`str`, *isteğe bağlı*, varsayılan `""`) : Sıralı sınıflandırma (token başına sınıflandırma yerine tüm sıranın sınıflandırılması) yapılırken kullanılan sınıflandırıcı jetonu. Özel jetonlarla oluşturulduğunda sıranın ilk jetonudur.
unk_token (`str`, *isteğe bağlı*, varsayılan `""`) : Bilinmeyen token. Sözlükte yer almayan bir token, bir kimliğe dönüştürülemez ve bunun yerine bu token olarak ayarlanır.
pad_token (`str`, *isteğe bağlı*, varsayılan `""`) : Dolgu için kullanılan jeton, örneğin farklı uzunluklardaki dizileri toplu işleme (batching) sırasında.
mask_token (`str`, *isteğe bağlı*, varsayılan `""`) : Değerleri maskelemek için kullanılan belirteç. Bu, modelin maskeli dil modelleme ile eğitildiğinde kullanılan belirteçtir. Modelin tahmin etmeye çalışacağı belirteç budur.
add_prefix_space (`bool`, *isteğe bağlı*, varsayılan `False`) : Girdinin başına bir boşluk eklenip eklenmeyeceğini belirtir. Bu, baştaki kelimenin diğer kelimelerle aynı şekilde ele alınmasını sağlar. (RoBERTa tokenizer, kelimelerin başlangıcını önceki boşlukla tespit eder).
MarkupLM tokenizer'ı oluşturun. Baytabazlı Byte-Pair-Encoding (BPE) üzerine kuruludur.
[MarkupLMTokenizer](/docs/transformers/v5.23.0/tr/model_doc/markuplm#transformers.MarkupLMTokenizer), HTML dizgilerini token düzeyinde `input_ids`, `attention_mask`, `token_type_ids`, `xpath_tags_seq` ve `xpath_tags_seq` değerlerine dönüştürmek için kullanılabilir. Bu tokenizer, ana yöntemlerin çoğunu içeren ve `tokenizers` arka ucunun her zaman örneklenmesini sağlayan [TokenizersBackend](/docs/transformers/v5.23.0/tr/main_classes/tokenizer#transformers.TokenizersBackend) sınıfından devralır.
Kullanıcıların bu yöntemler hakkında daha fazla bilgi için bu üst sınıfa başvurması gerekir.
#### batch_encode_plus[[transformers.MarkupLMTokenizer.batch_encode_plus]]
```python
batch_encode_plus(batch_text_or_text_pairs: list[str] | list[tuple[str, str]] | list[list[str]], is_pair: bool | None = None, xpaths: list[list[list[int]]] | None = None, node_labels: list[int] | list[list[int]] | None = None, add_special_tokens: bool = True, padding: bool | str | transformers.utils.generic.PaddingStrategy = False, truncation: bool | str | transformers.tokenization_utils_base.TruncationStrategy | None = None, max_length: int | None = None, stride: int = 0, pad_to_multiple_of: int | None = None, padding_side: str | None = None, return_tensors: str | transformers.utils.generic.TensorType | None = None, return_token_type_ids: bool | None = None, return_attention_mask: bool | None = None, return_overflowing_tokens: bool = False, return_special_tokens_mask: bool = False, return_offsets_mapping: bool = False, return_length: bool = False, verbose: bool = True, **kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/tokenization_markuplm.py#L453)
add_special_tokens (`bool`, *isteğe bağlı*, varsayılan `True`): Dizileri kodlarken özel jetonların eklenip eklenmeyeceğini belirtir. Bu, girdi kimliklerine otomatik olarak hangi jetonların ekleneceğini tanımlayan alttaki `PretrainedTokenizerBase.build_inputs_with_special_tokens` işlevini kullanır. `bos` veya `eos` jetonlarını otomatik olarak eklemek istiyorsanız bu işe yarar. padding (`bool`, `str` veya [PaddingStrategy](/docs/transformers/v5.23.0/tr/internal/file_utils#transformers.utils.PaddingStrategy), *isteğe bağlı*, varsayılan `False`): Dolguyu etkinleştirir ve kontrol eder. Aşağıdaki değerleri kabul eder:
- `True` veya `'longest'`: Toplu işlemdeki en uzun dizinin uzunluğuna kadar dolgu yapılır (yalnızca tek bir dizi sağlanıyorsa dolgu yapılmaz).
- `'max_length'`: `max_length` argümanı ile belirtilen maksimum uzunluğa veya bu argüman sağlanmadıysa modelin kabul edebileceği maksimum giriş uzunluğuna kadar doldurur.
- `False` veya `'do_not_pad'` (varsayılan): Dolgu yok (yani, farklı uzunluklarda diziler içeren bir parti çıktı olarak üretilebilir).
truncation (`bool`, `str` veya [TruncationStrategy](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy), *opsiyonel*, varsayılan `False`): Kesme işlemini etkinleştirir ve kontrol eder. Aşağıdaki değerleri kabul eder:
- `True` veya `'longest_first'`: `max_length` argümanı ile belirtilen maksimum uzunluğa veya bu argüman sağlanmadıysa modelin kabul edebileceği maksimum giriş uzunluğuna kısaltılır. Bu işlem, token bazında gerçekleşir; bir çift dizi (veya çift dizilerden oluşan bir batch) sağlandığında, çiftteki en uzun diziden bir token kaldırılır.
- `'only_first'`: `max_length` argümanı ile belirtilen maksimum uzunluğa veya bu argüman sağlanmadıysa modelin kabul edebileceği maksimum giriş uzunluğuna kısaltır. Bir çift dizi (veya çiftlerin bir partisi) sağlandığında, yalnızca çiftin ilk dizisini kısaltır.
- `'only_second'`: `max_length` argümanı ile belirtilen maksimum uzunluğa veya bu argüman sağlanmadıysa modelin kabul edebileceği maksimum giriş uzunluğuna kısaltır. Bu, yalnızca bir çift dizi (veya çiftlerin bir partisi) sağlandığında çiftin ikinci dizisini kısaltır.
- `False` veya `'do_not_truncate'` (varsayılan): Kesme yapılmaz (yani, modelin kabul edebileceği maksimum giriş boyutundan daha uzun dizi uzunluklarına sahip bir çıktı partisi üretilebilir).
max_length (`int`, *isteğe bağlı*): Kesme/doldurma parametrelerinden biri tarafından kullanılacak maksimum uzunluğu kontrol eder.
Eğer ayarlanmazsa veya `None` olarak ayarlanırsa, kırpma/dolgu parametrelerinden biri maksimum uzunluk gerektiriyorsa, önceden tanımlanmış model maksimum uzunluğu kullanılacaktır. Modelin belirli bir maksimum giriş uzunluğu yoksa (ör. XLNet), maksimum uzunluğa kırpma/dolgu devre dışı bırakılacaktır. stride (`int`, *isteğe bağlı*, varsayılan 0): `max_length` ile birlikte bir sayı olarak ayarlanırsa, `return_overflowing_tokens=True` olduğunda döndürülen taşan jetonlar, kırpılmış ve taşan diziler arasında bazı örtüşme sağlamak için kırpılmış dizinin sonundan döndürülen bazı jetonları içerecektir. Bu argümanın değeri, örtüşen jeton sayısını tanımlar. is_split_into_words (`bool`, *isteğe bağlı*, varsayılan `False`): Girdinin zaten önceden jetonlaştırılmış olup olmadığını belirtir (ör. kelimelere ayrılmış). `True` olarak ayarlanırsa, tokenizer girdinin zaten kelimelere ayrılmış olduğunu (örneğin boşluklara göre bölünerek) ve bunları jetonlaştıracak varsayar. Bu, NER veya jeton sınıflandırması için kullanışlıdır. pad_to_multiple_of (`int`, *isteğe bağlı*): Ayarlanırsa, diziyi sağlanan değerin katına doldurur. Bunun için `padding` etkinleştirilmelidir. Bu, hesaplama yeteneği `>= 7.5` (Volta) olan NVIDIA donanımlarında Tensor Cores kullanımını etkinleştirmek için özellikle kullanışlıdır. padding_side (`str`, *isteğe bağlı*): Modelde dolgunun uygulanması gereken taraf. ['right', 'left'] arasından seçilmelidir. Varsayılan değer, aynı ada sahip sınıf özelliğinden seçilir. return_tensors (`str` veya [TensorType](/docs/transformers/v5.23.0/tr/internal/file_utils#transformers.TensorType), *isteğe bağlı*): Ayarlanırsa, python tamsayı listesi yerine tensörler döndürülür. Kabul edilebilir değerler:
- `'pt'`: PyTorch `torch.Tensor` nesnelerini döndürür.
- `'np'`: Numpy `np.ndarray` nesnelerini döndürür.
add_special_tokens (`bool`, *isteğe bağlı*, varsayılan `True`): Modellerine göre özel jetonlarla dizileri kodlayıp kodlamayacağı. padding (`bool`, `str` veya [PaddingStrategy](/docs/transformers/v5.23.0/tr/internal/file_utils#transformers.utils.PaddingStrategy), *isteğe bağlı*, varsayılan `False`): Dolguyu etkinleştirir ve kontrol eder. Aşağıdaki değerleri kabul eder:
- `True` veya `'longest'`: Toplu işlemdeki en uzun dizinin uzunluğuna kadar dolgu yapılır (yalnızca tek bir dizi sağlandıysa dolgu yapılmaz).
- `'max_length'`: `max_length` argümanı ile belirtilen maksimum uzunluğa veya bu argüman sağlanmadıysa modelin kabul edebileceği maksimum giriş uzunluğuna kadar doldurur.
- `False` veya `'do_not_pad'` (varsayılan): Dolgu yok (yani, farklı uzunluklarda diziler içeren bir parti çıktı olarak üretilebilir).
truncation (`bool`, `str` veya [TruncationStrategy](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy), *opsiyonel*, varsayılan `False`): Kesme işlemini etkinleştirir ve kontrol eder. Aşağıdaki değerleri kabul eder:
- `True` veya `'longest_first'`: `max_length` argümanı ile belirtilen maksimum uzunluğa veya bu argüman sağlanmadıysa modelin kabul edebileceği maksimum giriş uzunluğuna kısaltılır. Bu işlem, token bazında gerçekleşir; bir çift dizi (veya çift dizilerden oluşan bir batch) sağlandığında, çiftteki en uzun diziden bir token kaldırılır.
- `'only_first'`: `max_length` argümanı ile belirtilen maksimum uzunluğa veya bu argüman sağlanmadıysa modelin kabul edebileceği maksimum giriş uzunluğuna kısaltır. Bir çift dizi (veya çiftlerin bir partisi) sağlandığında, yalnızca çiftin ilk dizisini kısaltır.
- `'only_second'`: `max_length` argümanı ile belirtilen maksimum uzunluğa veya bu argüman sağlanmadıysa modelin kabul edebileceği maksimum giriş uzunluğuna kısaltır. Bu, yalnızca bir çift dizi (veya çiftlerin bir partisi) sağlandığında çiftin ikinci dizisini kısaltır.
- `False` veya `'do_not_truncate'` (varsayılan): Kesme yapılmaz (yani, modelin kabul edebileceği maksimum giriş boyutundan daha uzun dizi uzunluklarına sahip bir çıktı partisi üretilebilir).
max_length (`int`, *isteğe bağlı*): Kesme/doldurma parametrelerinden biri tarafından kullanılacak maksimum uzunluğu kontrol eder. Ayarlanmaz veya `None` olarak ayarlanırsa, kesme/doldurma parametrelerinden biri maksimum uzunluk gerektiriyorsa, önceden tanımlanmış modelin maksimum uzunluğu kullanılır. Modelin belirli bir maksimum giriş uzunluğu yoksa (XLNet gibi) maksimum uzunluğa kesme/doldurma devre dışı bırakılır. stride (`int`, *isteğe bağlı*, varsayılan 0): `max_length` ile birlikte bir sayı olarak ayarlanırsa, `return_overflowing_tokens=True` olduğunda döndürülen taşan jetonlar, kesilmiş ve taşan diziler arasında bazı örtüşmeler sağlamak için kesilmiş dizinin sonundan bazı jetonları içerir. Bu argümanın değeri, örtüşen jeton sayısını tanımlar. is_split_into_words (`bool`, *isteğe bağlı*, varsayılan `False`): Girdinin zaten önceden jetonlaştırılmış olup olmadığını belirtir (ör. kelimelere ayrılmış). Ek jetonlaştırmayı önlemek için önceden jetonlaştırılmış girdiler geçiriyorsanız bunu `True` olarak ayarlayın. pad_to_multiple_of (`int`, *isteğe bağlı*): Ayarlanırsa, diziyi sağlanan değerin katına doldurur. Bu, hesaplama yeteneği `>= 7.5` (Volta) olan NVIDIA donanımlarında Tensor Cores kullanımını etkinleştirmek için özellikle faydalıdır. return_tensors (`str` veya [TensorType](/docs/transformers/v5.23.0/tr/internal/file_utils#transformers.TensorType), *isteğe bağlı*): Ayarlanırsa, python tamsayı listesi yerine tensörler döndürülür. Kabul edilebilir değerler şunlardır:
- `'pt'`: PyTorch `torch.Tensor` nesnelerini döndürür.
- `'np'`: Numpy `np.ndarray` nesnelerini döndürür.
#### build_inputs_with_special_tokens[[transformers.MarkupLMTokenizer.build_inputs_with_special_tokens]]
```python
build_inputs_with_special_tokens(token_ids_0: list[int], token_ids_1: list[int] | None = None)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/tokenization_markuplm.py#L952)
**Parametreler:**
token_ids_0 (`list[int]`) : Özel jetonların ekleneceği kimliklerin listesi.
token_ids_1 (`list[int]`, *isteğe bağlı*) : Sıralı çiftler için isteğe bağlı ikinci kimlik listesi.
**Dönüş:** `list[int]`
Uygun özel jetonlarla [girdi kimlikleri](../glossary#input-ids) listesi.
Sınıflandırma görevleri için bir dizi veya dizi çiftinden model girdilerini birleştirerek ve özel jetonlar ekleyerek oluşturun. RoBERTa dizisi aşağıdaki biçime sahiptir:
- tek dizi: ` X `
- dizi çifti: ` A B `
#### create_token_type_ids_from_sequences[[transformers.MarkupLMTokenizer.create_token_type_ids_from_sequences]]
```python
create_token_type_ids_from_sequences(token_ids_0: list[int], token_ids_1: list[int] | None = None)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/tokenization_markuplm.py#L975)
**Parametreler:**
token_ids_0 (`list[int]`) : Kimlik listesi.
token_ids_1 (`list[int]`, *isteğe bağlı*) : Sıralı çiftler için isteğe bağlı ikinci kimlik listesi.
**Dönüş:** `list[int]`
Sıfırlar listesi.
Sıralama çifti sınıflandırma görevinde kullanılacak şekilde, iletilen iki diziden bir maske oluşturun. RoBERTa, belirteç türü kimliklerini kullanmadığından, sıfırlardan oluşan bir liste döndürülür.
#### encode_plus[[transformers.MarkupLMTokenizer.encode_plus]]
```python
encode_plus(text: str | list[str], text_pair: list[str] | None = None, xpaths: list[list[int]] | None = None, node_labels: list[int] | None = None, add_special_tokens: bool = True, padding: bool | str | transformers.utils.generic.PaddingStrategy = False, truncation: bool | str | transformers.tokenization_utils_base.TruncationStrategy | None = None, max_length: int | None = None, stride: int = 0, pad_to_multiple_of: int | None = None, padding_side: str | None = None, return_tensors: str | transformers.utils.generic.TensorType | None = None, return_token_type_ids: bool | None = None, return_attention_mask: bool | None = None, return_overflowing_tokens: bool = False, return_special_tokens_mask: bool = False, return_offsets_mapping: bool = False, return_length: bool = False, verbose: bool = True, **kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/tokenization_markuplm.py#L518)
**Parametreler:**
text (`str`, `list[str]`, `list[list[str]]`) : Kodlanacak ilk dizi. Bu, bir dize, dize listesi veya dize listesi listesi olabilir.
text_pair (`list[str]` veya `list[int]`, *isteğe bağlı*) : Kodlanacak isteğe bağlı ikinci dizi. Bu, bir dizi metin (tek bir örneğin kelimeleri) veya metin dizileri listesi (bir örnek grubunun kelimeleri) olabilir.
add_special_tokens (`bool`, *isteğe bağlı*, varsayılan `True`) : Dizileri kodlarken özel jetonların eklenip eklenmeyeceğini belirtir. Bu, girdi kimliklerine otomatik olarak eklenen jetonları tanımlayan alttaki `PretrainedTokenizerBase.build_inputs_with_special_tokens` işlevini kullanır. `bos` veya `eos` jetonlarını otomatik olarak eklemek istiyorsanız bu işe yarar.
padding (`bool`, `str` veya [PaddingStrategy](/docs/transformers/v5.23.0/tr/internal/file_utils#transformers.utils.PaddingStrategy), *isteğe bağlı*, varsayılan `False`) : Dolguyu (padding) etkinleştirir ve kontrol eder. Aşağıdaki değerleri kabul eder: - `True` veya `'longest'`: Batch'teki en uzun diziye kadar doldurur (yalnızca tek bir dizi sağlanırsa dolgu yapılmaz). - `'max_length'`: `max_length` argümanı ile belirtilen maksimum uzunluğa kadar veya bu argüman sağlanmadıysa modelin kabul edebileceği maksimum girdi uzunluğuna kadar doldurur. - `False` veya `'do_not_pad'` (varsayılan): Dolgu yapılmaz (yani, farklı uzunluklarda diziler içeren bir batch çıktısı alınabilir).
truncation (`bool`, `str` veya [TruncationStrategy](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy), *opsiyonel*, varsayılan `False`) : Kısaltmayı etkinleştirir ve kontrol eder. Aşağıdaki değerleri kabul eder: - `True` veya `'longest_first'`: `max_length` argümanı ile belirtilen maksimum uzunluğa veya bu argüman sağlanmadıysa modelin kabul edebileceği maksimum giriş uzunluğuna kısaltır. Bir dizi çifti (veya çiftlerin bir partisi) sağlanırsa, çiftteki en uzun diziden token token kısaltma yapar. - `'only_first'`: `max_length` argümanı ile belirtilen maksimum uzunluğa veya bu argüman sağlanmadıysa modelin kabul edebileceği maksimum giriş uzunluğuna kısaltır. Bir dizi çifti (veya çiftlerin bir partisi) sağlanırsa, yalnızca çiftin ilk dizisini kısaltır. - `'only_second'`: `max_length` argümanı ile belirtilen maksimum uzunluğa veya bu argüman sağlanmadıysa modelin kabul edebileceği maksimum giriş uzunluğuna kısaltır. Bir dizi çifti (veya çiftlerin bir partisi) sağlanırsa, yalnızca çiftin ikinci dizisini kısaltır. - `False` veya `'do_not_truncate'` (varsayılan): Kısaltma yapılmaz (yani, modelin kabul edebileceği maksimum giriş boyutundan daha uzun dizi uzunluklarına sahip partiler üretebilir).
max_length (`int`, *opsiyonel*) : Kırpma/doldurma parametrelerinden biri tarafından kullanılacak olan maksimum uzunluğu kontrol eder. Ayarlanmaz veya `None` olarak ayarlanırsa, kırpma/doldurma parametrelerinden biri maksimum uzunluk gerektiriyorsa, önceden tanımlanmış modelin maksimum uzunluğu kullanılır. Modelin belirli bir maksimum giriş uzunluğu yoksa (XLNet gibi) maksimum uzunluğa kırpma/doldurma devre dışı bırakılır.
stride (`int`, *opsiyonel*, varsayılan 0) : `max_length` ile birlikte bir sayıya ayarlanırsa, `return_overflowing_tokens=True` olduğunda döndürülen taşan jetonlar, kısaltılmış ve taşan diziler arasında bir örtüşme sağlamak amacıyla kısaltılmış dizinin sonundan döndürülen bazı jetonları içerir. Bu argümanın değeri, örtüşen jetonların sayısını belirler.
is_split_into_words (`bool`, *isteğe bağlı*, varsayılan `False`) : Girdinin önceden tokenize edilip edilmediğini (örneğin, kelimelere ayrılmış olup olmadığını) belirtir. `True` olarak ayarlanırsa, tokenizer girdinin zaten kelimelere ayrılmış olduğunu (örneğin, boşluklara göre bölünmüş) varsayar ve bunları tokenize eder. Bu, NER veya token sınıflandırma için faydalıdır.
pad_to_multiple_of (`int`, *isteğe bağlı*) : Ayarlanırsa, diziyi verilen değerin katına kadar doldurur. Bunun için `padding` etkinleştirilmelidir. Bu, hesaplama yeteneği `>= 7.5` (Volta) olan NVIDIA donanımlarında Tensor Cores kullanımını etkinleştirmek için özellikle faydalıdır.
padding_side (`str`, *isteğe bağlı*) : Modelin padding uygulanması gereken tarafı. ['right', 'left'] arasından seçilmelidir. Varsayılan değer, aynı ada sahip sınıf özelliğinden alınır.
return_tensors (`str` veya [TensorType](/docs/transformers/v5.23.0/tr/internal/file_utils#transformers.TensorType), *opsiyonel*) : Ayarlanırsa, Python tamsayı listesi yerine tensörler döndürülür. Kabul edilen değerler: - `'pt'`: PyTorch `torch.Tensor` nesnelerini döndürür. - `'np'`: Numpy `np.ndarray` nesnelerini döndürür.
add_special_tokens (`bool`, *isteğe bağlı*, varsayılan `True`) : Sıraların, modellerine göre özel jetonlarla kodlanıp kodlanmayacağını belirtir.
padding (`bool`, `str` veya [PaddingStrategy](/docs/transformers/v5.23.0/tr/internal/file_utils#transformers.utils.PaddingStrategy), *opsiyonel*, varsayılan `False`) : Dolguyu (padding) etkinleştirir ve kontrol eder. Aşağıdaki değerleri kabul eder: - `True` veya `'longest'`: Batch'teki en uzun diziye kadar doldurur (yalnızca tek bir dizi sağlandıysa dolgu yapılmaz). - `'max_length'`: `max_length` argümanı ile belirtilen maksimum uzunluğa kadar veya bu argüman sağlanmadıysa modelin kabul edebileceği maksimum giriş uzunluğuna kadar doldurur. - `False` veya `'do_not_pad'` (varsayılan): Dolgu yapılmaz (yani, farklı uzunluklarda dizilere sahip bir batch çıktısı verilebilir).
truncation (`bool`, `str` veya [TruncationStrategy](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy), *opsiyonel*, varsayılan `False`) : Kısaltmayı etkinleştirir ve kontrol eder. Aşağıdaki değerleri kabul eder: - `True` veya `'longest_first'`: `max_length` argümanı ile belirtilen maksimum uzunluğa veya bu argüman sağlanmadıysa modelin kabul edebileceği maksimum giriş uzunluğuna kısaltır. Bir dizi çifti (veya çiftlerin bir partisi) sağlanırsa, çiftteki en uzun diziden token token kısaltma yapar. - `'only_first'`: `max_length` argümanı ile belirtilen maksimum uzunluğa veya bu argüman sağlanmadıysa modelin kabul edebileceği maksimum giriş uzunluğuna kısaltır. Bir dizi çifti (veya çiftlerin bir partisi) sağlanırsa, yalnızca çiftin ilk dizisini kısaltır. - `'only_second'`: `max_length` argümanı ile belirtilen maksimum uzunluğa veya bu argüman sağlanmadıysa modelin kabul edebileceği maksimum giriş uzunluğuna kısaltır. Bir dizi çifti (veya çiftlerin bir partisi) sağlanırsa, yalnızca çiftin ikinci dizisini kısaltır. - `False` veya `'do_not_truncate'` (varsayılan): Kısaltma yapılmaz (yani, modelin kabul edebileceği maksimum giriş boyutundan daha uzun dizi uzunluklarına sahip partiler üretebilir).
max_length (`int`, *isteğe bağlı*) : Kesme/doldurma parametrelerinden biri tarafından kullanılacak maksimum uzunluğu kontrol eder. Ayarlanmaz veya `None` olarak ayarlanırsa, kesme/doldurma parametrelerinden biri maksimum uzunluk gerektiriyorsa, önceden tanımlanmış model maksimum uzunluğu kullanılır. Modelin belirli bir maksimum giriş uzunluğu yoksa (XLNet gibi) maksimum uzunluğa kesme/doldurma devre dışı bırakılır.
stride (`int`, *opsiyonel*, varsayılan 0) : `max_length` ile birlikte bir sayıya ayarlanırsa, `return_overflowing_tokens=True` olduğunda döndürülen taşan jetonlar, kısaltılmış ve taşan diziler arasında bir örtüşme sağlamak amacıyla kısaltılmış dizinin sonundan döndürülen bazı jetonları içerir. Bu argümanın değeri, örtüşen jetonların sayısını belirler.
is_split_into_words (`bool`, *isteğe bağlı*, varsayılan `False`) : Girdinin zaten ön tokenize edilip edilmediğini belirtir (ör. kelimelere ayrılmış). Ek tokenizasyondan kaçınmak için ön tokenize edilmiş girdiler geçiriyorsanız bunu `True` olarak ayarlayın.
pad_to_multiple_of (`int`, *isteğe bağlı*) : Ayarlanırsa, diziyi verilen değerin katına kadar doldurur. Bu, hesaplama yeteneği `>= 7.5` (Volta) olan NVIDIA donanımlarında Tensor Core'lerin kullanılmasını sağlamak için özellikle faydalıdır.
return_tensors (`str` veya [TensorType](/docs/transformers/v5.23.0/tr/internal/file_utils#transformers.TensorType), *opsiyonel*) : Ayarlanırsa, Python tamsayı listesi yerine tensörler döndürülür. Kabul edilen değerler: - `'pt'`: PyTorch `torch.Tensor` nesnelerini döndürür. - `'np'`: Numpy `np.ndarray` nesnelerini döndürür.
Bir dizi veya dizi çiftini belirleyin ve modele hazırlamak için tokenize edin. .. warning:: Bu yöntem kullanımdan kaldırılmıştır, bunun yerine `__call__` kullanılmalıdır.
#### get_xpath_seq[[transformers.MarkupLMTokenizer.get_xpath_seq]]
```python
get_xpath_seq(xpath)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/tokenization_markuplm.py#L253)
Belirli bir düğümün xpath ifadesi (örneğin "/html/body/div/li[1]/div/span[2]") verildiğinde, maksimum derinliği göz önünde bulundurarak etiket kimlikleri ve ilgili alt indislerin listesini döndürür.
## MarkupLMProcessor[[transformers.MarkupLMProcessor]]
#### transformers.MarkupLMProcessor[[transformers.MarkupLMProcessor]]
```python
transformers.MarkupLMProcessor(feature_extractor, tokenizer)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/processing_markuplm.py#L25)
**Parametreler:**
feature_extractor (`feature_extractor_class`) : Özellik çıkarıcı zorunlu bir girdidir.
tokenizer (`MarkupLMTokenizer`) : Tokenizer zorunlu bir girdidir.
Bir özellik çıkarıcıyı ve bir sınıflandırıcıyı tek bir işleyicide birleştiren bir MarkupLMProcessor oluşturur.
[MarkupLMProcessor](/docs/transformers/v5.23.0/tr/model_doc/markuplm#transformers.MarkupLMProcessor), `feature_extractor_class` ve [MarkupLMTokenizer](/docs/transformers/v5.23.0/tr/model_doc/markuplm#transformers.MarkupLMTokenizer) sınıflarının tüm işlevlerini sunar. Daha fazla bilgi için `~feature_extractor_class` ve [~MarkupLMTokenizer](/docs/transformers/v5.23.0/tr/model_doc/markuplm#transformers.MarkupLMTokenizer) belgelerine bakın.
#### __call__[[transformers.MarkupLMProcessor.__call__]]
```python
__call__(html_strings = None, nodes = None, xpaths = None, node_labels = None, questions = None, add_special_tokens: bool = True, padding: bool | str | transformers.utils.generic.PaddingStrategy = False, truncation: bool | str | transformers.tokenization_utils_base.TruncationStrategy = None, max_length: int | None = None, stride: int = 0, pad_to_multiple_of: int | None = None, return_token_type_ids: bool | None = None, return_attention_mask: bool | None = None, return_overflowing_tokens: bool = False, return_special_tokens_mask: bool = False, return_offsets_mapping: bool = False, return_length: bool = False, verbose: bool = True, return_tensors: str | transformers.utils.generic.TensorType | None = None, **kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/processing_markuplm.py#L31)
**Parametreler:**
html_strings (`str` veya `list[str]`, *isteğe bağlı*) : İşlenecek ve ayrıştırılacak ham HTML dizgileri. `parse_html=True` (varsayılan) olduğunda, bu dizgiler düğümleri ve xpath'leri otomatik olarak çıkarmak için ayrıştırılır. Sağlanırsa, `nodes`, `xpaths` ve `node_labels` sağlanmamalıdır. `parse_html=True` olduğunda zorunludur.
nodes (`list[list[str]]`, *isteğe bağlı*) : Her iç listenin tek bir belgedeki düğümlerin metin içeriğini içerdiği, düğümlerin listesi olarak önceden çıkarılmış HTML düğümleri. `parse_html=False` olduğunda gereklidir. `parse_html=True` olduğunda sağlanmamalıdır.
xpaths (`list[list[str]]`, *isteğe bağlı*) : Düğümlere karşılık gelen önceden çıkarılmış XPath ifadeleri. `nodes` ile aynı yapıya sahip, her bir XPath'in HTML ağacında ilgili düğümün konumunu belirlediği iç içe listeler olmalıdır. `parse_html=False` olduğunda zorunludur. `parse_html=True` olduğunda sağlanmamalıdır.
node_labels (`list[list[int]]`, *isteğe bağlı*) : Düğümler için etiketler, genellikle eğitim veya ince ayar görevlerinde kullanılır. `nodes` ile aynı yapıya sahip, her etiketin bir düğüme karşılık geldiği iç içe listeler olmalıdır. İsteğe bağlıdır ve yalnızca `parse_html=False` olduğunda kullanılır.
questions (`str` veya `list[str]`, *isteğe bağlı*) : Soru-cevap görevleri için soru dizgileri. Sağlandığında, tokenizer soruları ilk dizi olarak, düğümleri ise ikinci dizi (text_pair) olarak işler. Tek bir dizi sağlanırsa, ayrıştırılan HTML'nin parti boyutuyla eşleşmesi için bir listeye dönüştürülür.
add_special_tokens (`bool`, *isteğe bağlı*, varsayılan `True`) : Dizileri kodlarken özel jetonların eklenip eklenmeyeceğini belirtir. Bu, girdi kimliklerine otomatik olarak eklenen jetonları tanımlayan alttaki `PretrainedTokenizerBase.build_inputs_with_special_tokens` işlevini kullanır. `bos` veya `eos` jetonlarını otomatik olarak eklemek istiyorsanız bu işe yarar.
padding (bool, str or [PaddingStrategy](/docs/transformers/v5.23.0/tr/internal/file_utils#transformers.utils.PaddingStrategy), *opsiyonel*, varsayılan `False`) : Dolguyu (padding) etkinleştirir ve kontrol eder. Aşağıdaki değerleri kabul eder: - `True` veya `'longest'`: Batch'teki en uzun diziye kadar doldurur (yalnızca tek bir dizi sağlanırsa dolgu yapılmaz). - `'max_length'`: `max_length` argümanı ile belirtilen maksimum uzunluğa kadar veya bu argüman sağlanmadıysa modelin kabul edebileceği maksimum girdi uzunluğuna kadar doldurur. - `False` veya `'do_not_pad'` (varsayılan): Dolgu yapılmaz (yani, farklı uzunluklarda dizilere sahip bir batch çıktısı verilebilir).
truncation (bool, str or [TruncationStrategy](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy), *optional*) : Kırpma işlemini etkinleştirir ve kontrol eder. Aşağıdaki değerleri kabul eder: - `True` veya `'longest_first'`: `max_length` argümanı ile belirtilen maksimum uzunluğa veya bu argüman sağlanmadıysa modelin kabul edebileceği maksimum giriş uzunluğuna kırpılır. Bu, token bazında kırpma yapar; bir dizi çifti (veya çiftler grubu) sağlanırsa, çiftteki en uzun diziden bir token kaldırılır. - `'only_first'`: `max_length` argümanı ile belirtilen maksimum uzunluğa veya bu argüman sağlanmadıysa modelin kabul edebileceği maksimum giriş uzunluğuna kırpılır. Bir dizi çifti (veya çiftler grubu) sağlanırsa, yalnızca çiftin ilk dizisi kırpılır. - `'only_second'`: `max_length` argümanı ile belirtilen maksimum uzunluğa veya bu argüman sağlanmadıysa modelin kabul edebileceği maksimum giriş uzunluğuna kırpılır. Bir dizi çifti (veya çiftler grubu) sağlanırsa, yalnızca çiftin ikinci dizisi kırpılır. - `False` veya `'do_not_truncate'` (varsayılan): Kırpma yapılmaz (yani, modelin kabul edebileceği maksimum giriş boyutundan daha uzun dizi uzunluklarına sahip bir grup çıktı üretilebilir).
max_length (`int`, *opsiyonel*) : Kırpma/doldurma parametrelerinden biri tarafından kullanılacak olan maksimum uzunluğu kontrol eder. Ayarlanmaz veya `None` olarak ayarlanırsa, kırpma/doldurma parametrelerinden biri maksimum uzunluk gerektiriyorsa, önceden tanımlanmış modelin maksimum uzunluğu kullanılır. Modelin belirli bir maksimum giriş uzunluğu yoksa (XLNet gibi) maksimum uzunluğa kırpma/doldurma devre dışı bırakılır.
stride (`int`, *opsiyonel*, varsayılan `0`) : `max_length` ile birlikte bir sayıya ayarlanırsa, `return_overflowing_tokens=True` olduğunda döndürülen taşan jetonlar, kısaltılmış ve taşan diziler arasında bazı örtüşmeler sağlamak için kısaltılmış dizinin sonundan döndürülen bazı jetonları içerir. Bu argümanın değeri, örtüşen jeton sayısını tanımlar.
pad_to_multiple_of (`int`, *isteğe bağlı*) : Ayarlanırsa, diziyi verilen değerin katına kadar doldurur. Bunun için `padding` etkinleştirilmelidir. Bu, hesaplama yeteneği `>= 7.5` (Volta) olan NVIDIA donanımlarında Tensor Çekirdeklerinin kullanılmasını sağlamak için özellikle faydalıdır.
return_token_type_ids (`bool`, *isteğe bağlı*) : Token türü kimliklerinin döndürülüp döndürülmeyeceğini belirtir. Varsayılan bırakılırsa, `return_outputs` özniteliği tarafından tanımlanan, ilgili tokenizer'ın varsayılanına göre token türü kimlikleri döndürülür. [Token türü kimlikleri nelerdir?](../glossary#token-type-ids)
return_attention_mask (`bool`, *isteğe bağlı*) : Dikkat maskesinin (attention mask) döndürülüp döndürülmeyeceğini belirtir. Varsayılan bırakılırsa, `return_outputs` özniteliğiyle tanımlanan, ilgili tokenizer'ın varsayılanına göre dikkat maskesi döndürülür. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
return_overflowing_tokens (`bool`, *isteğe bağlı*, varsayılan `False`) : Taşan token dizilerinin döndürülüp döndürülmeyeceğini belirtir. Girdi kimlikleri için bir dizi çifti (veya bir çiftler partisi) `truncation_strategy = longest_first` veya `True` ile sağlanırsa, taşan tokenlar döndürülmek yerine bir hata oluşturulur.
return_special_tokens_mask (`bool`, *isteğe bağlı*, varsayılan `False`) : Özel jeton maskesi bilgisinin döndürülüp döndürülmeyeceği.
return_offsets_mapping (`bool`, *isteğe bağlı*, varsayılan `False`) : Her token için `(char_start, char_end)` döndürülecek mi. Bu yalnızca [PreTrainedTokenizerFast](/docs/transformers/v5.23.0/tr/main_classes/tokenizer#transformers.TokenizersBackend)'ten türeyen hızlı tokenizer'lar için kullanılabilir; Python tokenizer'ı kullanılıyorsa bu yöntem `NotImplementedError` fırlatır.
return_length (`bool`, *isteğe bağlı*, varsayılan `False`) : Kodlanmış girdilerin uzunluklarının döndürülüp döndürülmeyeceği.
verbose (`bool`, *isteğe bağlı*, varsayılan `True`) : Daha fazla bilgi ve uyarı basılıp basılmayacağı.
return_tensors (`Union[str, ~utils.generic.TensorType]`, *isteğe bağlı*) : Ayarlanırsa, belirli bir çerçeveye ait tensörleri döndürür. Kabul edilen değerler: - `'pt'`: PyTorch `torch.Tensor` nesnelerini döndürür. - `'np'`: NumPy `np.ndarray` nesnelerini döndürür.
**Dönüş:** `~tokenization_utils_base.BatchEncoding`
- **data** (`dict`, *isteğe bağlı*) -- `__call__`/`encode_plus`/`batch_encode_plus` yöntemleri tarafından döndürülen listeler/diziler/tensörler sözlüğü ('input_ids', 'attention_mask' vb.).
- **encoding** (`tokenizers.Encoding` veya `Sequence[tokenizers.Encoding]`, *isteğe bağlı*) -- Tokenizer, kelime/karakter uzayından token uzayına eşleme gibi ek bilgiler üreten hızlı bir tokenizer ise, `tokenizers.Encoding` örneği veya örnekler listesi (toplu işlemler için) bu bilgileri barındırır.
- **tensor_type** (`Union[None, str, TensorType]`, *isteğe bağlı*) -- Başlatma sırasında PyTorch/Numpy Tensörlerindeki tamsayı listelerini dönüştürmek için burada bir tensor_type verebilirsiniz.
- **prepend_batch_axis** (`bool`, *isteğe bağlı*, varsayılan `False`) -- Tensörlere dönüştürülürken bir batch ekseni eklenip eklenmeyeceğini belirtir (bkz. yukarıdaki `tensor_type`). `tensor_type` parametresi ayarlanmışsa bu parametrenin bir etkisi vardır, *aksi halde hiçbir etkisi yoktur*.
- **n_sequences** (`int`, *isteğe bağlı*) -- Her kodlamanın temsil ettiği girdi dizilerinin sayısı (`None` bilinmeyen, `1` tek bir dizi ve `2` dizi çifti için).
## MarkupLMModel[[transformers.MarkupLMModel]]
#### transformers.MarkupLMModel[[transformers.MarkupLMModel]]
```python
transformers.MarkupLMModel(config: MarkupLMConfig, add_pooling_layer = True)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/modeling_markuplm.py#L497)
**Parametreler:**
config ([MarkupLMConfig](/docs/transformers/v5.23.0/tr/model_doc/markuplm#transformers.MarkupLMConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine bakın.
add_pooling_layer (`bool`, *isteğe bağlı*, varsayılan `True`) : Bir havuzlama katmanı eklenip eklenmeyeceği
Üzerinde herhangi bir özel head olmadan ham hidden-state çıktısı üreten çıplak Markuplm Model.
Bu model [PreTrainedModel](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.MarkupLMModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, xpath_tags_seq: typing.Optional[torch.LongTensor] = None, xpath_subs_seq: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/modeling_markuplm.py#L521)
**Parametreler:**
input_ids (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Sözlükteki girdi dizisi belirteçlerinin (token) indeksleri. Varsayılan olarak dolgu (padding) yoksayılır. İndeksler [AutoTokenizer](/docs/transformers/v5.23.0/tr/model_doc/auto#transformers.AutoTokenizer) kullanılarak elde edilebilir. Ayrıntılar için [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) ve [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) yöntemlerine bakın. [Girdi kimlikları (input IDs) nedir?](../glossary#input-ids)
xpath_tags_seq (`torch.LongTensor`, şekli `(batch_size, sequence_length, config.max_depth)`, *isteğe bağlı*) : Girdi dizisindeki her token için etiket kimlikleri, config.max_depth değerine kadar dolgu yapılmış.
xpath_subs_seq (`torch.LongTensor`, şekli `(batch_size, sequence_length, config.max_depth)`, *isteğe bağlı*) : Girdi dizisindeki her token için alt indeks kimlikleri, config.max_depth değerine kadar dolgu yapılmış.
attention_mask (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Girdilerin ilk ve ikinci bölümlerini belirtmek için segment token dizinleri. Dizinler `[0, 1]` aralığından seçilir: - 0, *sentence A* token'ına karşılık gelir, - 1, *sentence B* token'ına karşılık gelir. [Token type ID'leri nelerdir?](../glossary#token-type-ids)
position_ids (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Girdi dizisi token'larının konum gömme (position embeddings) içindeki konum indeksleri. `[0, config.n_positions - 1]` aralığında seçilir. [Konum kimlikleri (position IDs) nedir?](../glossary#position-ids)
inputs_embeds (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`, *isteğe bağlı*) : `input_ids` parametresini iletmek yerine, gömülü bir temsil doğrudan iletmeyi tercih edebilirsiniz. Bu, `input_ids` indekslerini ilgili vektörlere dönüştürme biçimi üzerinde modelin dahili gömme arama matrisine kıyasla daha fazla kontrol sahibi olmak istiyorsanız faydalıdır.
**Dönüş:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) veya `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırma ([MarkupLMConfig](/docs/transformers/v5.23.0/tr/model_doc/markuplm#transformers.MarkupLMConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[MarkupLMModel](/docs/transformers/v5.23.0/tr/model_doc/markuplm#transformers.MarkupLMModel) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **last_hidden_state** (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`) -- Modelin son katmanının çıktısındaki gizli durumlar dizisi.
- **pooler_output** (`torch.Tensor`, şekli `(batch_size, hidden_size)`) -- Sıralamanın ilk token'ının (sınıflandırma token'ı) son katman gizli durumu, yardımcı ön eğitim görevi için kullanılan katmanlardan geçirildikten sonraki hali. Örneğin BERT ailesi modelleri için, bu, sınıflandırma token'ının doğrusal bir katman ve tanh aktivasyon fonksiyonundan geçirildikten sonraki halini döndürür. Doğrusal katman ağırlıkları, ön eğitim sırasında bir sonraki cümle tahmini (sınıflandırma) hedefinden eğitilir.
- **hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren, `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
Örnekler:
```python
>>> from transformers import AutoProcessor, MarkupLMModel
>>> processor = AutoProcessor.from_pretrained("microsoft/markuplm-base")
>>> model = MarkupLMModel.from_pretrained("microsoft/markuplm-base")
>>> html_string = " Page Title "
>>> encoding = processor(html_string, return_tensors="pt")
>>> outputs = model(**encoding)
>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 4, 768]
```
## MarkupLMForSequenceClassification[[transformers.MarkupLMForSequenceClassification]]
#### transformers.MarkupLMForSequenceClassification[[transformers.MarkupLMForSequenceClassification]]
```python
transformers.MarkupLMForSequenceClassification(config: MarkupLMConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/modeling_markuplm.py#L802)
**Parametreler:**
config ([MarkupLMConfig](/docs/transformers/v5.23.0/tr/model_doc/markuplm#transformers.MarkupLMConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine bakın.
MarkupLM Model, üstünde bir dizi sınıflandırma/geri dönüşüm kafası (toplanmış çıktının üzerinde doğrusal bir katman) bulunan bir transformer, örneğin GLUE görevleri için.
Bu model [PreTrainedModel](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.MarkupLMForSequenceClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, xpath_tags_seq: typing.Optional[torch.Tensor] = None, xpath_subs_seq: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/modeling_markuplm.py#L819)
**Parametreler:**
input_ids (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Sözlükteki girdi dizisi token'larının indeksleri. Dolgu (padding) varsayılan olarak yok sayılır. İndeksler [AutoTokenizer](/docs/transformers/v5.23.0/tr/model_doc/auto#transformers.AutoTokenizer) kullanılarak elde edilebilir. Ayrıntılar için [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) ve [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) yöntemlerine bakın. [Girdi ID'leri nelerdir?](../glossary#input-ids)
xpath_tags_seq (`torch.LongTensor`, şekli `(batch_size, sequence_length, config.max_depth)`, *isteğe bağlı*) : Girdi dizisindeki her token için etiket kimlikleri, config.max_depth değerine kadar dolgu yapılmış.
xpath_subs_seq (`torch.LongTensor`, şekli `(batch_size, sequence_length, config.max_depth)`, *isteğe bağlı*) : Girdi dizisindeki her token için alt indeks kimlikleri, config.max_depth değerine kadar dolgu yapılmış.
attention_mask (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
token_type_ids (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Girdilerin ilk ve ikinci bölümlerini belirtmek için segment token dizinleri. Dizinler `[0, 1]` aralığından seçilir: - 0, *sentence A* token'ına karşılık gelir, - 1, *sentence B* token'ına karşılık gelir. [Token type ID'leri nelerdir?](../glossary#token-type-ids)
position_ids (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Girdi dizileri token'larının konum gömme (position embeddings) içindeki konum indeksleri. `[0, config.n_positions - 1]` aralığında seçilir. [Konum kimlikleri (position IDs) nedir?](../glossary#position-ids)
inputs_embeds (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`, *isteğe bağlı*) : `input_ids` parametresini iletmek yerine, gömülü bir temsil doğrudan iletmeyi tercih edebilirsiniz. Bu, `input_ids` indekslerini ilgili vektörlere dönüştürme biçimi üzerinde modelin dahili gömme arama matrisine kıyasla daha fazla kontrol sahibi olmak istiyorsanız faydalıdır.
labels (`torch.LongTensor`, şekli `(batch_size,)`, *isteğe bağlı*) : Sınıflandırma/geri dönüş kaybını hesaplamak için etiketler. Endeksler `[0, ..., config.num_labels - 1]` aralığında olmalıdır. `config.num_labels == 1` ise bir geri dönüş kaybı (Ortalama Kare kaybı) hesaplanır, `config.num_labels > 1` ise bir sınıflandırma kaybı (Çapraz Entropi) hesaplanır.
**Dönüş:** [SequenceClassifierOutput](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) veya `tuple(torch.Tensor)`
[SequenceClassifierOutput](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırmaya ([MarkupLMConfig](/docs/transformers/v5.23.0/tr/model_doc/markuplm#transformers.MarkupLMConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[MarkupLMForSequenceClassification](/docs/transformers/v5.23.0/tr/model_doc/markuplm#transformers.MarkupLMForSequenceClassification) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **loss** (`torch.Tensor`, şekli `(1,)`, *isteğe bağlı*, `labels` sağlandığında döndürülür) -- Sınıflandırma (config.num_labels==1 ise regresyon) kaybı.
- **logits** (`torch.Tensor`, şekli `(batch_size, config.num_labels)`) -- Sınıflandırma (veya config.num_labels==1 ise regresyon) puanları (SoftMax öncesi).
- **hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren, `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
Örnekler:
```python
>>> from transformers import AutoProcessor, AutoModelForSequenceClassification
>>> import torch
>>> processor = AutoProcessor.from_pretrained("microsoft/markuplm-base")
>>> model = AutoModelForSequenceClassification.from_pretrained("microsoft/markuplm-base", num_labels=7)
>>> html_string = " Page Title "
>>> encoding = processor(html_string, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model(**encoding)
>>> loss = outputs.loss
>>> logits = outputs.logits
```
## MarkupLMForTokenClassification[[transformers.MarkupLMForTokenClassification]]
#### transformers.MarkupLMForTokenClassification[[transformers.MarkupLMForTokenClassification]]
```python
transformers.MarkupLMForTokenClassification(config: MarkupLMConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/modeling_markuplm.py#L709)
**Parametreler:**
config ([MarkupLMConfig](/docs/transformers/v5.23.0/tr/model_doc/markuplm#transformers.MarkupLMConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine bakın.
Üstünde `token_classification` başlığı bulunan MarkupLM Modeli.
Bu model [PreTrainedModel](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.MarkupLMForTokenClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, xpath_tags_seq: typing.Optional[torch.Tensor] = None, xpath_subs_seq: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/modeling_markuplm.py#L725)
**Parametreler:**
input_ids (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Sözlükteki girdi dizisi token'larının indeksleri. Dolgu (padding) varsayılan olarak yok sayılır. İndeksler [AutoTokenizer](/docs/transformers/v5.23.0/tr/model_doc/auto#transformers.AutoTokenizer) kullanılarak elde edilebilir. Ayrıntılar için [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) ve [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) yöntemlerine bakın. [Girdi ID'leri nelerdir?](../glossary#input-ids)
xpath_tags_seq (`torch.LongTensor`, şekli `(batch_size, sequence_length, config.max_depth)`, *isteğe bağlı*) : Girdi dizisindeki her token için etiket kimlikleri, config.max_depth değerine kadar dolgu yapılmış.
xpath_subs_seq (`torch.LongTensor`, şekli `(batch_size, sequence_length, config.max_depth)`, *isteğe bağlı*) : Girdi dizisindeki her token için alt indeks kimlikleri, config.max_depth değerine kadar dolgu yapılmış.
attention_mask (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
token_type_ids (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Girdilerin ilk ve ikinci bölümlerini belirtmek için segment token dizinleri. Dizinler `[0, 1]` aralığından seçilir: - 0, *sentence A* token'ına karşılık gelir, - 1, *sentence B* token'ına karşılık gelir. [Token type ID'leri nelerdir?](../glossary#token-type-ids)
position_ids (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Girdi dizileri token'larının konum gömme (position embeddings) içindeki konum indeksleri. `[0, config.n_positions - 1]` aralığında seçilir. [Konum kimlikleri (position IDs) nedir?](../glossary#position-ids)
inputs_embeds (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`, *isteğe bağlı*) : `input_ids` parametresini iletmek yerine, gömülü bir temsil doğrudan iletmeyi tercih edebilirsiniz. Bu, `input_ids` indekslerini ilgili vektörlere dönüştürme biçimi üzerinde modelin dahili gömme arama matrisine kıyasla daha fazla kontrol sahibi olmak istiyorsanız faydalıdır.
labels (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Token sınıflandırma kaybını hesaplamak için etiketler. İndisler `[0, ..., config.num_labels - 1]` aralığında olmalıdır.
**Dönüş:** [MaskedLMOutput](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) veya `tuple(torch.Tensor)`
[MaskedLMOutput](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırmaya ([MarkupLMConfig](/docs/transformers/v5.23.0/tr/model_doc/markuplm#transformers.MarkupLMConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[MarkupLMForTokenClassification](/docs/transformers/v5.23.0/tr/model_doc/markuplm#transformers.MarkupLMForTokenClassification) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **loss** (`torch.Tensor`, şekli `(1,)`, *isteğe bağlı*, `labels` sağlandığında döndürülür) -- Maskeli dil modelleme (MLM) kaybı.
- **logits** (`torch.Tensor`, şekli `(batch_size, sequence_length, config.vocab_size)`) -- Dil modelleme başlığının tahmin puanları (SoftMax öncesi her sözlük jetonu için puanlar).
- **hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren, `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
Örnekler:
```python
>>> from transformers import AutoProcessor, AutoModelForTokenClassification
>>> import torch
>>> processor = AutoProcessor.from_pretrained("microsoft/markuplm-base")
>>> processor.parse_html = False
>>> model = AutoModelForTokenClassification.from_pretrained("microsoft/markuplm-base", num_labels=7)
>>> nodes = ["hello", "world"]
>>> xpaths = ["/html/body/div/li[1]/div/span", "/html/body/div/li[1]/div/span"]
>>> node_labels = [1, 2]
>>> encoding = processor(nodes=nodes, xpaths=xpaths, node_labels=node_labels, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model(**encoding)
>>> loss = outputs.loss
>>> logits = outputs.logits
```
## MarkupLMForQuestionAnswering[[transformers.MarkupLMForQuestionAnswering]]
#### transformers.MarkupLMForQuestionAnswering[[transformers.MarkupLMForQuestionAnswering]]
```python
transformers.MarkupLMForQuestionAnswering(config: MarkupLMConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/modeling_markuplm.py#L603)
**Parametreler:**
config ([MarkupLMConfig](/docs/transformers/v5.23.0/tr/model_doc/markuplm#transformers.MarkupLMConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine bakın.
SQuAD gibi çıkarımsal soru-cevap görevleri için üstünde bir aralık sınıflandırma kafası bulunan Markuplm dönüştürücüsü (gizli durum çıktısının üzerine, `span start logits` ve `span end logits` hesaplamak için bir doğrusal katman).
Bu model [PreTrainedModel](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.MarkupLMForQuestionAnswering.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, xpath_tags_seq: typing.Optional[torch.Tensor] = None, xpath_subs_seq: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, start_positions: typing.Optional[torch.Tensor] = None, end_positions: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/modeling_markuplm.py#L615)
**Parametreler:**
input_ids (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Sözlükteki girdi dizisi token'larının indeksleri. Dolgu (padding) varsayılan olarak yok sayılır. İndeksler [AutoTokenizer](/docs/transformers/v5.23.0/tr/model_doc/auto#transformers.AutoTokenizer) kullanılarak elde edilebilir. Ayrıntılar için [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) ve [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) yöntemlerine bakın. [Girdi ID'leri nelerdir?](../glossary#input-ids)
xpath_tags_seq (`torch.LongTensor`, şekli `(batch_size, sequence_length, config.max_depth)`, *isteğe bağlı*) : Girdi dizisindeki her token için etiket kimlikleri, config.max_depth değerine kadar dolgu yapılmış.
xpath_subs_seq (`torch.LongTensor`, şekli `(batch_size, sequence_length, config.max_depth)`, *isteğe bağlı*) : Girdi dizisindeki her token için alt indeks kimlikleri, config.max_depth değerine kadar dolgu yapılmış.
attention_mask (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
token_type_ids (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Girdilerin ilk ve ikinci bölümlerini belirtmek için segment token dizinleri. Dizinler `[0, 1]` aralığından seçilir: - 0, *sentence A* token'ına karşılık gelir, - 1, *sentence B* token'ına karşılık gelir. [Token type ID'leri nelerdir?](../glossary#token-type-ids)
position_ids (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Girdi dizileri token'larının konum gömme (position embeddings) içindeki konum indeksleri. `[0, config.n_positions - 1]` aralığında seçilir. [Konum kimlikleri (position IDs) nedir?](../glossary#position-ids)
inputs_embeds (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`, *isteğe bağlı*) : `input_ids` parametresini iletmek yerine, gömülü bir temsil doğrudan iletmeyi tercih edebilirsiniz. Bu, `input_ids` indekslerini ilgili vektörlere dönüştürme biçimi üzerinde modelin dahili gömme arama matrisine kıyasla daha fazla kontrol sahibi olmak istiyorsanız faydalıdır.
start_positions (`torch.Tensor`, şekli `(batch_size,)`, *isteğe bağlı*) : Token sınıflandırma kaybını hesaplamak için etiketli aralığın başlangıç konumunun (indeksinin) etiketleri. Konumlar, dizinin uzunluğuna (`sequence_length`) sınırlanır. Dizi dışındaki konumlar, kaybın hesaplanmasında dikkate alınmaz.
end_positions (`torch.Tensor`, şekli `(batch_size,)`, *isteğe bağlı*) : Token sınıflandırma kaybını hesaplamak için etiketli aralığın sonundaki konumun (indeksin) etiketleri. Konumlar, dizinin uzunluğuna (`sequence_length`) göre sınırlandırılır. Dizi dışındaki konumlar, kaybın hesaplanmasında dikkate alınmaz.
**Dönüş:** [QuestionAnsweringModelOutput](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.QuestionAnsweringModelOutput) veya `tuple(torch.Tensor)`
[QuestionAnsweringModelOutput](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.QuestionAnsweringModelOutput) veya bir `torch.Tensor` demeti (`return_dict=False` geçirildiğinde veya `config.return_dict=False` olduğunda); yapılandırma ([MarkupLMConfig](/docs/transformers/v5.23.0/tr/model_doc/markuplm#transformers.MarkupLMConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[MarkupLMForQuestionAnswering](/docs/transformers/v5.23.0/tr/model_doc/markuplm#transformers.MarkupLMForQuestionAnswering) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **loss** (`torch.Tensor`, şekli `(1,)`, *isteğe bağlı*, `labels` sağlandığında döndürülür) -- Toplam span çıkarım kaybı, başlangıç ve bitiş konumları için Çapraz Entropinin (Cross-Entropy) toplamıdır.
- **start_logits** (`torch.Tensor`, şekli `(batch_size, sequence_length)`) -- Span başlangıç puanları (SoftMax öncesi).
- **end_logits** (`torch.Tensor`, şekli `(batch_size, sequence_length)`) -- Span sonu puanları (SoftMax öncesi).
- **hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren, `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
Örnekler:
```python
>>> from transformers import AutoProcessor, MarkupLMForQuestionAnswering
>>> import torch
>>> processor = AutoProcessor.from_pretrained("microsoft/markuplm-base-finetuned-websrc")
>>> model = MarkupLMForQuestionAnswering.from_pretrained("microsoft/markuplm-base-finetuned-websrc")
>>> html_string = " My name is Niels "
>>> question = "What's his name?"
>>> encoding = processor(html_string, questions=question, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model(**encoding)
>>> answer_start_index = outputs.start_logits.argmax()
>>> answer_end_index = outputs.end_logits.argmax()
>>> predict_answer_tokens = encoding.input_ids[0, answer_start_index : answer_end_index + 1]
>>> processor.decode(predict_answer_tokens).strip()
'Niels'
```