# YOSO
## Tổng quan
Mô hình YOSO được đề xuất trong [You Only Sample (Almost) Once: Linear Cost Self-Attention Via Bernoulli Sampling](https://huggingface.co/papers/2111.09714) của Zhanpeng Zeng, Yunyang Xiong, Sathya N. Ravi, Shailesh Acharya, Glenn Fung, Vikas Singh. YOSO xấp xỉ softmax self-attention chuẩn thông qua một phương pháp lấy mẫu Bernoulli dựa trên Locality Sensitive Hashing (LSH). Về nguyên tắc, tất cả các biến ngẫu nhiên Bernoulli đều có thể được lấy mẫu bằng một hash duy nhất.
Tóm tắt từ bài báo như sau:
*Các mô hình dựa trên Transformer được sử dụng rộng rãi trong xử lý ngôn ngữ tự nhiên (NLP). Nền tảng của mô hình Transformer là cơ chế tự chú ý (self-attention), cơ chế này nắm bắt các tương tác giữa các cặp token trong chuỗi đầu vào và phụ thuộc bậc hai vào độ dài chuỗi. Việc huấn luyện các mô hình như vậy trên các chuỗi dài hơn là tốn kém. Trong bài báo này, chúng tôi cho thấy một cơ chế chú ý lấy mẫu Bernoulli dựa trên Locality Sensitive Hashing (LSH) làm giảm độ phức tạp bậc hai của các mô hình này xuống còn tuyến tính. Chúng tôi bỏ qua chi phí bậc hai bằng cách xem xét tự chú ý như một tổng của các token riêng lẻ liên kết với các biến ngẫu nhiên Bernoulli, về nguyên tắc có thể được lấy mẫu cùng lúc bằng một hash duy nhất (mặc dù trên thực tế, con số này có thể là một hằng số nhỏ). Điều này dẫn đến một phương án lấy mẫu hiệu quả để ước lượng tự chú ý, dựa trên các sửa đổi cụ thể của LSH (để cho phép triển khai trên kiến trúc GPU). Chúng tôi đánh giá thuật toán của mình trên bộ chuẩn GLUE với độ dài chuỗi tiêu chuẩn 512, nơi chúng tôi thấy hiệu suất thuận lợi so với một Transformer được huấn luyện trước tiêu chuẩn. Trên bộ chuẩn Long Range Arena (LRA), dùng để đánh giá hiệu suất trên các chuỗi dài, phương pháp của chúng tôi đạt được kết quả nhất quán với tự chú ý softmax nhưng với tốc độ tăng đáng kể và tiết kiệm bộ nhớ, đồng thời thường vượt trội hơn so với các phương pháp tự chú ý hiệu quả khác. Mã nguồn của chúng tôi có sẵn tại this https URL*
Mô hình này được đóng góp bởi [novice03](https://huggingface.co/novice03). Mã gốc có thể được tìm thấy [tại đây](https://github.com/mlpen/YOSO).
## Mẹo sử dụng
- Thuật toán chú ý YOSO được triển khai thông qua các kernel CUDA tùy chỉnh, là các hàm được viết bằng CUDA C++ có thể được thực thi nhiều lần
song song trên GPU.
- Các kernel cung cấp một hàm `fast_hash`, trong đó xấp xỉ các phép chiếu ngẫu nhiên của các truy vấn và khóa bằng cách sử dụng Fast Hadamard Transform. Sử dụng những
các mã băm, hàm `lsh_cumulation` xấp xỉ self-attention thông qua lấy mẫu Bernoulli dựa trên LSH.
- Để sử dụng các kernel tùy chỉnh, người dùng nên đặt `config.use_expectation = False`. Để đảm bảo rằng các kernel được biên dịch thành công,
người dùng phải cài đặt phiên bản PyTorch và cudatoolkit phù hợp. Mặc định, `config.use_expectation = True`, sử dụng YOSO-E và không yêu cầu biên dịch các kernel CUDA.
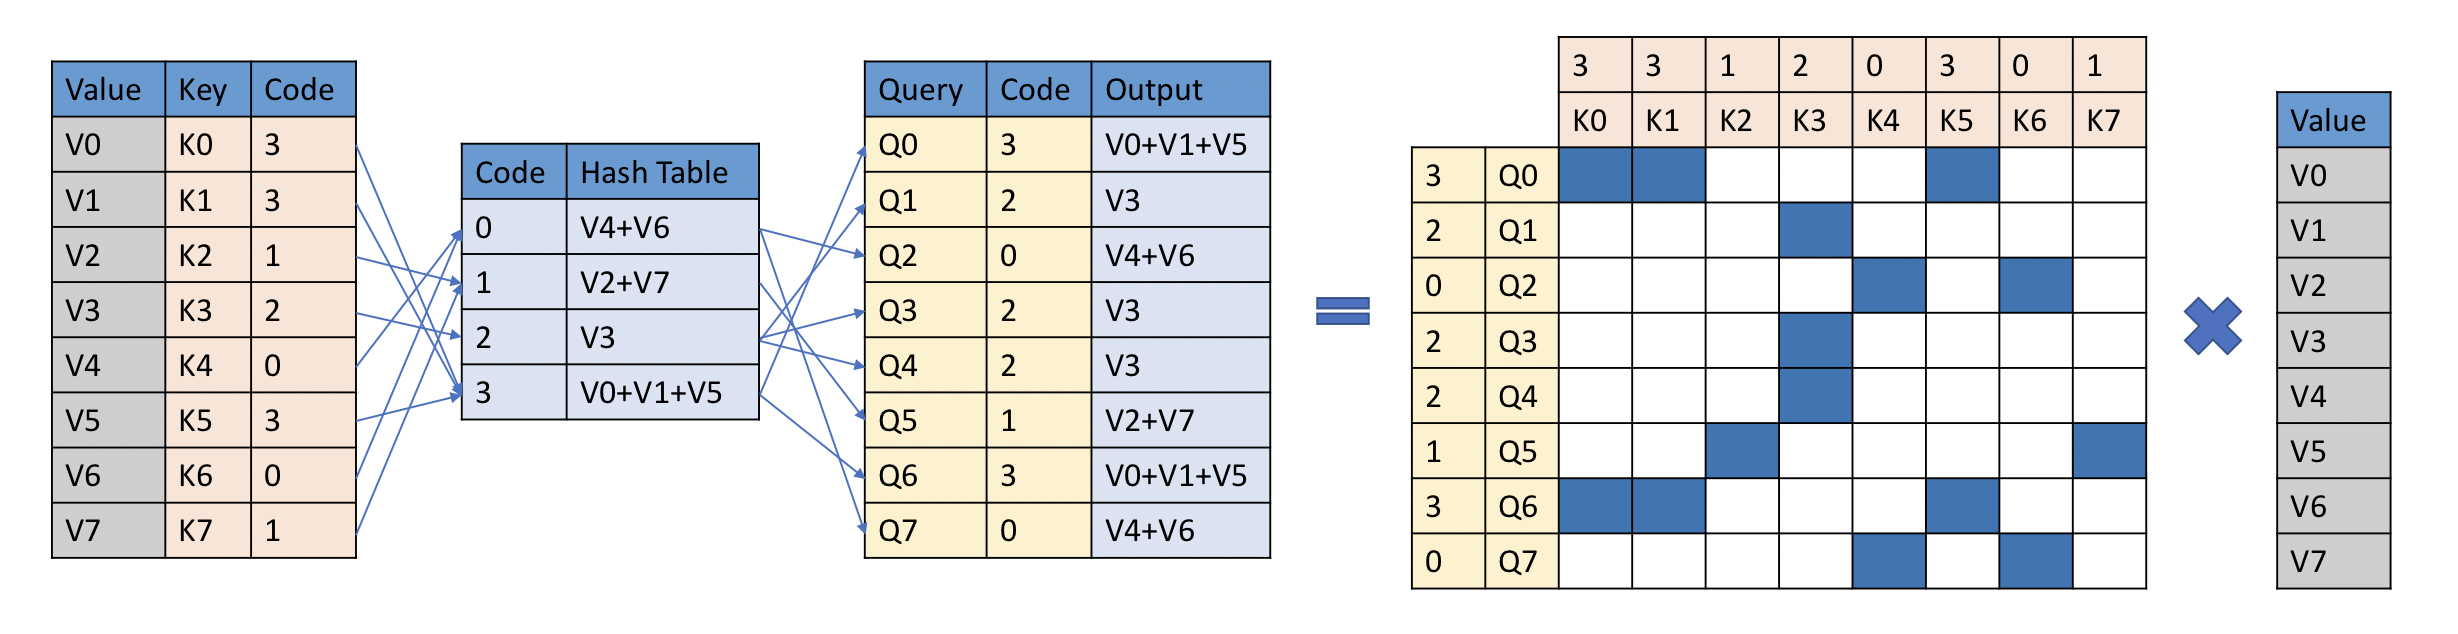 Thuật toán YOSO Attention. Được trích từ bài báo gốc.
## Tài nguyên
- [Hướng dẫn cho tác vụ phân loại văn bản](../tasks/sequence_classification)
- [Hướng dẫn cho tác vụ phân loại token](../tasks/token_classification)
- [Hướng dẫn nhiệm vụ trả lời câu hỏi](../tasks/question_answering)
- [Hướng dẫn cho tác vụ mô hình hóa ngôn ngữ có mặt nạ](../tasks/masked_language_modeling)
- [Hướng dẫn cho tác vụ chọn nhiều đáp án](../tasks/multiple_choice)
## YosoConfig[[transformers.YosoConfig]]
#### transformers.YosoConfig[[transformers.YosoConfig]]
```python
transformers.YosoConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 50265, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.1, attention_probs_dropout_prob: float | int = 0.1, max_position_embeddings: int = 4096, type_vocab_size: int = 1, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, use_expectation: bool = True, hash_code_len: int = 9, num_hash: int = 64, conv_window: int | None = None, use_fast_hash: bool = True, lsh_backward: bool = True, pad_token_id: int | None = 1, bos_token_id: int | None = 0, eos_token_id: int | list[int] | None = 2, add_cross_attention: bool = False, tie_word_embeddings: bool = True)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/yoso/configuration_yoso.py#L24)
**Tham số:**
vocab_size (`int`, *tùy chọn*, mặc định là `50265`) : Kích thước từ vựng của mô hình. Xác định số lượng token khác nhau có thể được biểu diễn bởi `input_ids`.
hidden_size (`int`, *optional*, mặc định là `768`) : Kích thước của các biểu diễn ẩn.
num_hidden_layers (`int`, *tuỳ chọn*, mặc định là `12`) : Số lượng lớp ẩn trong bộ giải mã Transformer.
num_attention_heads (`int`, *tùy chọn*, mặc định là `12`) : Số lượng đầu chú ý cho mỗi lớp chú ý trong bộ giải mã Transformer.
intermediate_size (`int`, *tuỳ chọn*, mặc định là `3072`) : Kích thước của các biểu diễn MLP.
hidden_act (`str`, *tùy chọn*, mặc định là `gelu`) : Hàm kích hoạt phi tuyến (hàm hoặc chuỗi) trong bộ giải mã. Ví dụ, `"gelu"`, `"relu"`, `"silu"`, v.v.
hidden_dropout_prob (`Union[float, int]`, *tùy chọn*, mặc định là `0.1`) : Xác suất dropout cho tất cả các lớp fully connected trong embeddings, encoder và pooler.
attention_probs_dropout_prob (`Union[float, int]`, *tùy chọn*, mặc định là `0.1`) : Tỷ lệ dropout cho các xác suất chú ý.
max_position_embeddings (`int`, *tuỳ chọn*, mặc định là `4096`) : Độ dài chuỗi tối đa mà mô hình này có thể được sử dụng.
type_vocab_size (`int`, *tùy chọn*, mặc định là `1`) : Kích thước từ vựng của `token_type_ids`.
initializer_range (`float`, *optional*, mặc định là `0.02`) : Độ lệch chuẩn của truncated_normal_initializer để khởi tạo tất cả các ma trận trọng số.
layer_norm_eps (`float`, *tuỳ chọn*, mặc định là `1e-12`) : Epsilon được sử dụng bởi các lớp chuẩn hóa lớp (layer normalization).
use_expectation (`bool`, *tuỳ chọn*, mặc định là `True`) : Có sử dụng YOSO Expectation hay không. Ghi đè mọi tác động của num_hash.
hash_code_len (`int`, *tuỳ chọn*, mặc định là 9) : Độ dài của các băm được tạo ra bởi các hàm băm.
num_hash (`int`, *tuỳ chọn*, mặc định là 64) : Số lượng hàm băm được sử dụng trong `YosoSelfAttention`.
conv_window (`int`, *tuỳ chọn*) : Kích thước kernel của phép convolution theo chiều sâu.
use_fast_hash (`bool`, *tùy chọn*, mặc định là `False`) : Có sử dụng các kernel cuda tùy chỉnh thực hiện phép chiếu ngẫu nhiên nhanh thông qua phép biến đổi hadamard hay không.
lsh_backward (`bool`, *tùy chọn*, mặc định là `True`) : Có thực hiện backpropagation sử dụng Locality Sensitive Hashing hay không.
pad_token_id (`int`, *tuỳ chọn*, mặc định là `1`) : Id của token được sử dụng để đệm (padding) trong từ vựng.
bos_token_id (`int`, *tuỳ chọn*, mặc định là `0`) : Id của token được dùng cho đầu luồng (beginning-of-stream) trong từ vựng.
eos_token_id (`Union[int, list[int]]`, *tùy chọn*, mặc định là `2`) : Id của token được sử dụng cho end-of-stream trong bảng từ vựng.
add_cross_attention (`bool`, *tùy chọn*, mặc định là `False`) : Xác định xem có nên thêm các lớp cross-attention vào mô hình hay không.
tie_word_embeddings (`bool`, *tùy chọn*, mặc định là `True`) : Có nên gắn kết các nhúng trọng số theo ánh xạ `tied_weights_keys` của mô hình hay không.
Đây là lớp cấu hình để lưu trữ cấu hình của một YosoModel. Nó được sử dụng để khởi tạo một mô hình Yoso theo các đối số được chỉ định, xác định kiến trúc của mô hình. Khởi tạo một cấu hình với các giá trị mặc định sẽ tạo ra một cấu hình tương tự như cấu hình của [uw-madison/yoso-4096](https://huggingface.co/uw-madison/yoso-4096)
Các đối tượng cấu hình kế thừa từ [PreTrainedConfig](/docs/transformers/main/vi/main_classes/configuration#transformers.PreTrainedConfig) và có thể được sử dụng để kiểm soát đầu ra của mô hình. Đọc tài liệu từ [PreTrainedConfig](/docs/transformers/main/vi/main_classes/configuration#transformers.PreTrainedConfig) để biết thêm thông tin.
Ví dụ:
```python
>>> from transformers import YosoConfig, YosoModel
>>> # Initializing a YOSO uw-madison/yoso-4096 style configuration
>>> configuration = YosoConfig()
>>> # Initializing a model (with random weights) from the uw-madison/yoso-4096 style configuration
>>> model = YosoModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## YosoModel[[transformers.YosoModel]]
#### transformers.YosoModel[[transformers.YosoModel]]
```python
transformers.YosoModel(config: YosoConfig)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/yoso/modeling_yoso.py#L616)
**Tham số:**
config ([YosoConfig](/docs/transformers/main/vi/model_doc/yoso#transformers.YosoConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số của mô hình.
Mô hình Yoso thuần túy, xuất ra các hidden-state thô mà không có bất kỳ head cụ thể nào ở phía trên.
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.YosoModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/yoso/modeling_yoso.py#L633)
**Tham số:**
input_ids (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số của các token trong chuỗi đầu vào theo từ vựng. Mặc định, các token đệm (padding) sẽ bị bỏ qua. Có thể lấy chỉ số bằng cách sử dụng [AutoTokenizer](/docs/transformers/main/vi/model_doc/auto#transformers.AutoTokenizer). Xem [PreTrainedTokenizer.encode()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) và [PreTrainedTokenizer.__call__()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) để biết thêm chi tiết. [ID đầu vào là gì?](../glossary#input-ids)
attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**. [Mặt nạ chú ý là gì?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` có shape `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số token phân đoạn để chỉ định phần đầu và phần thứ hai của các đầu vào. Các chỉ số được chọn trong `[0, 1]`: - 0 tương ứng với token *câu A*, - 1 tương ứng với token *câu B*. [Các ID loại token là gì?](../glossary#token-type-ids)
position_ids (`torch.Tensor` có shape `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số của vị trí các token trong mỗi chuỗi đầu vào trong các position embeddings. Được chọn trong khoảng `[0, config.n_positions - 1]`. [Position IDs là gì?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` có hình dạng `(batch_size, sequence_length, hidden_size)`, *tùy chọn*) : Tùy chọn, thay vì truyền `input_ids`, bạn có thể chọn cách truyền trực tiếp một biểu diễn nhúng. Điều này hữu ích nếu bạn muốn kiểm soát nhiều hơn cách chuyển đổi các chỉ số `input_ids` thành các vector liên quan so với ma trận tra cứu nhúng nội bộ của mô hình.
output_attentions (`bool`, *tùy chọn*) : Có trả về các tensor chú ý của tất cả các lớp chú ý hay không. Xem `attentions` trong phần tensor trả về để biết thêm chi tiết.
output_hidden_states (`bool`, *tuỳ chọn*) : Có trả về trạng thái ẩn của tất cả các lớp hay không. Xem `hidden_states` trong phần tensor trả về để biết thêm chi tiết.
return_dict (`bool`, *tùy chọn*) : Có trả về [ModelOutput](/docs/transformers/main/vi/main_classes/output#transformers.utils.ModelOutput) thay vì một tuple thông thường hay không.
**Trả về:** [BaseModelOutputWithCrossAttentions](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithCrossAttentions) hoặc `tuple(torch.Tensor)`
Một [BaseModelOutputWithCrossAttentions](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithCrossAttentions) hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([YosoConfig](/docs/transformers/main/vi/model_doc/yoso#transformers.YosoConfig)) và đầu vào.
Phương thức forward của [YosoModel](/docs/transformers/main/vi/model_doc/yoso#transformers.YosoModel) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **last_hidden_state** (`torch.Tensor` có hình dạng `(batch_size, sequence_length, hidden_size)`) -- Chuỗi các hidden-state tại đầu ra của lớp cuối cùng của mô hình.
- **hidden_states** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple của `torch.Tensor` (một cho đầu ra của các embedding, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`.
Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
- **attentions** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
- **cross_attentions** (`tuple(torch.Tensor)`, *tùy chọn*, được trả về khi `output_attentions=True` và `config.add_cross_attention=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý của lớp cross-attention của bộ giải mã, sau softmax chú ý, được sử dụng để tính trung bình có trọng số trong các đầu chú ý chéo.
## YosoForMaskedLM[[transformers.YosoForMaskedLM]]
#### transformers.YosoForMaskedLM[[transformers.YosoForMaskedLM]]
```python
transformers.YosoForMaskedLM(config: YosoConfig)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/yoso/modeling_yoso.py#L703)
**Tham số:**
config ([YosoConfig](/docs/transformers/main/vi/model_doc/yoso#transformers.YosoConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số của mô hình.
Mô hình Yoso có đầu `language modeling` ở trên."
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.YosoForMaskedLM.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/yoso/modeling_yoso.py#L725)
**Tham số:**
input_ids (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số của các token trong chuỗi đầu vào theo từ vựng. Mặc định, các token đệm (padding) sẽ bị bỏ qua. Có thể lấy chỉ số bằng cách sử dụng [AutoTokenizer](/docs/transformers/main/vi/model_doc/auto#transformers.AutoTokenizer). Xem [PreTrainedTokenizer.encode()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) và [PreTrainedTokenizer.__call__()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) để biết thêm chi tiết. [ID đầu vào là gì?](../glossary#input-ids)
attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**. [Mặt nạ chú ý là gì?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` có shape `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số token phân đoạn để chỉ định phần đầu và phần thứ hai của các đầu vào. Các chỉ số được chọn trong `[0, 1]`: - 0 tương ứng với token *câu A*, - 1 tương ứng với token *câu B*. [Các ID loại token là gì?](../glossary#token-type-ids)
position_ids (`torch.Tensor` có shape `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số của vị trí các token trong mỗi chuỗi đầu vào trong các position embeddings. Được chọn trong khoảng `[0, config.n_positions - 1]`. [Position IDs là gì?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` có hình dạng `(batch_size, sequence_length, hidden_size)`, *tùy chọn*) : Tùy chọn, thay vì truyền `input_ids`, bạn có thể chọn cách truyền trực tiếp một biểu diễn nhúng. Điều này hữu ích nếu bạn muốn kiểm soát nhiều hơn cách chuyển đổi các chỉ số `input_ids` thành các vector liên quan so với ma trận tra cứu nhúng nội bộ của mô hình.
labels (`torch.LongTensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Nhãn để tính toán tổn thất mô hình hóa ngôn ngữ có che (masked language modeling loss). Chỉ số phải nằm trong `[-100, 0, ..., config.vocab_size]` (xem docstring của `input_ids`). Các token có chỉ số được đặt thành `-100` sẽ bị bỏ qua (che), tổn thất chỉ được tính cho các token có nhãn nằm trong `[0, ..., config.vocab_size]`.
output_attentions (`bool`, *tùy chọn*) : Có trả về các tensor chú ý của tất cả các lớp chú ý hay không. Xem `attentions` trong phần tensor trả về để biết thêm chi tiết.
output_hidden_states (`bool`, *tuỳ chọn*) : Có trả về trạng thái ẩn của tất cả các lớp hay không. Xem `hidden_states` trong phần tensor trả về để biết thêm chi tiết.
return_dict (`bool`, *tùy chọn*) : Có trả về [ModelOutput](/docs/transformers/main/vi/main_classes/output#transformers.utils.ModelOutput) thay vì một tuple thông thường hay không.
**Trả về:** [MaskedLMOutput](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) hoặc `tuple(torch.Tensor)`
Một [MaskedLMOutput](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([YosoConfig](/docs/transformers/main/vi/model_doc/yoso#transformers.YosoConfig)) và đầu vào.
Phương thức forward của [YosoForMaskedLM](/docs/transformers/main/vi/model_doc/yoso#transformers.YosoForMaskedLM) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **loss** (`torch.Tensor` có hình dạng `(1,)`, *tùy chọn*, được trả về khi `labels` được cung cấp) -- Tổn thất mô hình hóa ngôn ngữ có mặt nạ (MLM).
- **logits** (`torch.Tensor` có hình dạng `(batch_size, sequence_length, config.vocab_size)`) -- Điểm dự đoán của đầu mô hình hóa ngôn ngữ (điểm cho mỗi token từ vựng trước SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple của `torch.Tensor` (một cho đầu ra của các embedding, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`.
Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
- **attentions** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ:
```python
>>> from transformers import AutoTokenizer, YosoForMaskedLM
>>> import torch
>>> tokenizer = AutoTokenizer.from_pretrained("uw-madison/yoso-4096")
>>> model = YosoForMaskedLM.from_pretrained("uw-madison/yoso-4096")
>>> inputs = tokenizer("The capital of France is .", return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> # retrieve index of
>>> mask_token_index = (inputs.input_ids == tokenizer.mask_token_id)[0].nonzero(as_tuple=True)[0]
>>> predicted_token_id = logits[0, mask_token_index].argmax(axis=-1)
>>> tokenizer.decode(predicted_token_id)
...
>>> labels = tokenizer("The capital of France is Paris.", return_tensors="pt")["input_ids"]
>>> # mask labels of non- tokens
>>> labels = torch.where(inputs.input_ids == tokenizer.mask_token_id, labels, -100)
>>> outputs = model(**inputs, labels=labels)
>>> round(outputs.loss.item(), 2)
...
```
## YosoForSequenceClassification[[transformers.YosoForSequenceClassification]]
#### transformers.YosoForSequenceClassification[[transformers.YosoForSequenceClassification]]
```python
transformers.YosoForSequenceClassification(config: YosoConfig)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/yoso/modeling_yoso.py#L799)
**Tham số:**
config ([YosoConfig](/docs/transformers/main/vi/model_doc/yoso#transformers.YosoConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số của mô hình.
Model transformer YOSO với đầu phân loại/hồi quy chuỗi phía trên (một lớp tuyến tính phía trên đầu ra đã được pool) ví dụ cho các tác vụ GLUE.
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.YosoForSequenceClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/yoso/modeling_yoso.py#L809)
**Tham số:**
input_ids (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số của các token trong chuỗi đầu vào theo từ vựng. Mặc định, các token đệm (padding) sẽ bị bỏ qua. Có thể lấy chỉ số bằng cách sử dụng [AutoTokenizer](/docs/transformers/main/vi/model_doc/auto#transformers.AutoTokenizer). Xem [PreTrainedTokenizer.encode()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) và [PreTrainedTokenizer.__call__()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) để biết thêm chi tiết. [ID đầu vào là gì?](../glossary#input-ids)
attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**. [Mặt nạ chú ý là gì?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` có shape `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số token phân đoạn để chỉ định phần đầu và phần thứ hai của các đầu vào. Các chỉ số được chọn trong `[0, 1]`: - 0 tương ứng với token *câu A*, - 1 tương ứng với token *câu B*. [Các ID loại token là gì?](../glossary#token-type-ids)
position_ids (`torch.Tensor` có shape `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số của vị trí các token trong mỗi chuỗi đầu vào trong các position embeddings. Được chọn trong khoảng `[0, config.n_positions - 1]`. [Position IDs là gì?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` có hình dạng `(batch_size, sequence_length, hidden_size)`, *tùy chọn*) : Tùy chọn, thay vì truyền `input_ids`, bạn có thể chọn cách truyền trực tiếp một biểu diễn nhúng. Điều này hữu ích nếu bạn muốn kiểm soát nhiều hơn cách chuyển đổi các chỉ số `input_ids` thành các vector liên quan so với ma trận tra cứu nhúng nội bộ của mô hình.
labels (`torch.LongTensor` có hình dạng `(batch_size,)`, *tùy chọn*) : Nhãn để tính toán tổn thất phân loại/hồi quy chuỗi. Chỉ số phải nằm trong `[0, ..., config.num_labels - 1]`. Nếu `config.num_labels == 1`, tổn thất hồi quy sẽ được tính toán (tổn thất Mean-Square). Nếu `config.num_labels > 1`, tổn thất phân loại sẽ được tính toán (Cross-Entropy).
output_attentions (`bool`, *tùy chọn*) : Có trả về các tensor chú ý của tất cả các lớp chú ý hay không. Xem `attentions` trong phần tensor trả về để biết thêm chi tiết.
output_hidden_states (`bool`, *tuỳ chọn*) : Có trả về trạng thái ẩn của tất cả các lớp hay không. Xem `hidden_states` trong phần tensor trả về để biết thêm chi tiết.
return_dict (`bool`, *tùy chọn*) : Có trả về [ModelOutput](/docs/transformers/main/vi/main_classes/output#transformers.utils.ModelOutput) thay vì một tuple thông thường hay không.
**Trả về:** [SequenceClassifierOutput](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) hoặc `tuple(torch.Tensor)`
Một [SequenceClassifierOutput](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([YosoConfig](/docs/transformers/main/vi/model_doc/yoso#transformers.YosoConfig)) và đầu vào.
Phương thức forward của [YosoForSequenceClassification](/docs/transformers/main/vi/model_doc/yoso#transformers.YosoForSequenceClassification) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **loss** (`torch.Tensor` có shape `(1,)`, *optional*, được trả về khi `labels` được cung cấp) -- Loss phân loại (hoặc hồi quy nếu config.num_labels==1).
- **logits** (`torch.Tensor` có hình dạng `(batch_size, config.num_labels)`) -- Điểm phân loại (hoặc hồi quy nếu config.num_labels==1) (trước SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple của `torch.Tensor` (một cho đầu ra của các embedding, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`.
Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
- **attentions** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ về phân loại nhãn đơn:
```python
>>> import torch
>>> from transformers import AutoTokenizer, YosoForSequenceClassification
>>> tokenizer = AutoTokenizer.from_pretrained("uw-madison/yoso-4096")
>>> model = YosoForSequenceClassification.from_pretrained("uw-madison/yoso-4096")
>>> inputs = tokenizer("Hello, my dog is cute", return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> predicted_class_id = logits.argmax().item()
>>> model.config.id2label[predicted_class_id]
...
>>> # To train a model on `num_labels` classes, you can pass `num_labels=num_labels` to `.from_pretrained(...)`
>>> num_labels = len(model.config.id2label)
>>> model = YosoForSequenceClassification.from_pretrained("uw-madison/yoso-4096", num_labels=num_labels)
>>> labels = torch.tensor([1])
>>> loss = model(**inputs, labels=labels).loss
>>> round(loss.item(), 2)
...
```
Ví dụ về phân loại đa nhãn:
```python
>>> import torch
>>> from transformers import AutoTokenizer, YosoForSequenceClassification
>>> tokenizer = AutoTokenizer.from_pretrained("uw-madison/yoso-4096")
>>> model = YosoForSequenceClassification.from_pretrained("uw-madison/yoso-4096", problem_type="multi_label_classification")
>>> inputs = tokenizer("Hello, my dog is cute", return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> predicted_class_ids = torch.arange(0, logits.shape[-1])[torch.sigmoid(logits).squeeze(dim=0) > 0.5]
>>> # To train a model on `num_labels` classes, you can pass `num_labels=num_labels` to `.from_pretrained(...)`
>>> num_labels = len(model.config.id2label)
>>> model = YosoForSequenceClassification.from_pretrained(
... "uw-madison/yoso-4096", num_labels=num_labels, problem_type="multi_label_classification"
... )
>>> labels = torch.sum(
... torch.nn.functional.one_hot(predicted_class_ids[None, :].clone(), num_classes=num_labels), dim=1
... ).to(torch.float)
>>> loss = model(**inputs, labels=labels).loss
```
## YosoForMultipleChoice[[transformers.YosoForMultipleChoice]]
#### transformers.YosoForMultipleChoice[[transformers.YosoForMultipleChoice]]
```python
transformers.YosoForMultipleChoice(config: YosoConfig)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/yoso/modeling_yoso.py#L874)
**Tham số:**
config ([YosoConfig](/docs/transformers/main/vi/model_doc/yoso#transformers.YosoConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số của mô hình.
Mô hình Yoso với đầu phân loại lựa chọn nhiều phương án ở trên (một lớp tuyến tính trên đầu ra đã được pool và một softmax), ví dụ cho các tác vụ RocStories/SWAG.
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.YosoForMultipleChoice.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/yoso/modeling_yoso.py#L885)
**Tham số:**
input_ids (`torch.LongTensor` có shape `(batch_size, num_choices, sequence_length)`) : Chỉ số của các token trong chuỗi đầu vào thuộc từ vựng. Các chỉ số này có thể được lấy bằng cách sử dụng [AutoTokenizer](/docs/transformers/main/vi/model_doc/auto#transformers.AutoTokenizer). Xem [PreTrainedTokenizer.encode()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) và [PreTrainedTokenizer.__call__()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) để biết thêm chi tiết. [Input IDs là gì?](../glossary#input-ids)
attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**. [Mặt nạ chú ý là gì?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` có shape `(batch_size, num_choices, sequence_length)`, *tùy chọn*) : Chỉ số token phân đoạn để chỉ định phần đầu và phần thứ hai của đầu vào. Các chỉ số được chọn trong `[0, 1]`: - 0 tương ứng với token *sentence A*, - 1 tương ứng với token *sentence B*. [Token type IDs là gì?](../glossary#token-type-ids)
position_ids (`torch.LongTensor` có shape `(batch_size, num_choices, sequence_length)`, *tùy chọn*) : Chỉ số của vị trí các token trong mỗi chuỗi đầu vào trong các position embeddings. Được chọn trong khoảng `[0, config.max_position_embeddings - 1]`. [Position IDs là gì?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` có hình dạng `(batch_size, num_choices, sequence_length, hidden_size)`, *tùy chọn*) : Tùy chọn, thay vì truyền `input_ids`, bạn có thể chọn truyền trực tiếp một biểu diễn nhúng. Điều này hữu ích nếu bạn muốn kiểm soát nhiều hơn cách chuyển đổi các chỉ số *input_ids* thành các vector liên quan so với ma trận tra cứu nhúng nội bộ của mô hình.
labels (`torch.LongTensor` có hình dạng `(batch_size,)`, *tùy chọn*) : Nhãn để tính toán tổn thất phân loại lựa chọn nhiều. Chỉ số phải nằm trong `[0, ..., num_choices-1]` trong đó `num_choices` là kích thước của chiều thứ hai của các tensor đầu vào. (Xem `input_ids` ở trên)
output_attentions (`bool`, *tùy chọn*) : Có trả về các tensor chú ý của tất cả các lớp chú ý hay không. Xem `attentions` trong phần tensor trả về để biết thêm chi tiết.
output_hidden_states (`bool`, *tuỳ chọn*) : Có trả về trạng thái ẩn của tất cả các lớp hay không. Xem `hidden_states` trong phần tensor trả về để biết thêm chi tiết.
return_dict (`bool`, *tùy chọn*) : Có trả về [ModelOutput](/docs/transformers/main/vi/main_classes/output#transformers.utils.ModelOutput) thay vì một tuple thông thường hay không.
**Trả về:** [MultipleChoiceModelOutput](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.MultipleChoiceModelOutput) hoặc `tuple(torch.Tensor)`
Một [MultipleChoiceModelOutput](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.MultipleChoiceModelOutput) hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([YosoConfig](/docs/transformers/main/vi/model_doc/yoso#transformers.YosoConfig)) và đầu vào.
Phương thức forward của [YosoForMultipleChoice](/docs/transformers/main/vi/model_doc/yoso#transformers.YosoForMultipleChoice) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **loss** (`torch.Tensor` có hình dạng *(1,)*, *tùy chọn*, được trả về khi `labels` được cung cấp) -- Tổn phân loại.
- **logits** (`torch.Tensor` có shape `(batch_size, num_choices)`) -- *num_choices* là chiều thứ hai của các tensor đầu vào. (xem *input_ids* ở trên).
Điểm phân loại (trước SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple của `torch.Tensor` (một cho đầu ra của các embedding, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`.
Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
- **attentions** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ:
```python
>>> from transformers import AutoTokenizer, YosoForMultipleChoice
>>> import torch
>>> tokenizer = AutoTokenizer.from_pretrained("uw-madison/yoso-4096")
>>> model = YosoForMultipleChoice.from_pretrained("uw-madison/yoso-4096")
>>> prompt = "In Italy, pizza served in formal settings, such as at a restaurant, is presented unsliced."
>>> choice0 = "It is eaten with a fork and a knife."
>>> choice1 = "It is eaten while held in the hand."
>>> labels = torch.tensor(0).unsqueeze(0) # choice0 is correct (according to Wikipedia ;)), batch size 1
>>> encoding = tokenizer([prompt, prompt], [choice0, choice1], return_tensors="pt", padding=True)
>>> outputs = model(**{k: v.unsqueeze(0) for k, v in encoding.items()}, labels=labels) # batch size is 1
>>> # the linear classifier still needs to be trained
>>> loss = outputs.loss
>>> logits = outputs.logits
```
## YosoForTokenClassification[[transformers.YosoForTokenClassification]]
#### transformers.YosoForTokenClassification[[transformers.YosoForTokenClassification]]
```python
transformers.YosoForTokenClassification(config: YosoConfig)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/yoso/modeling_yoso.py#L975)
**Tham số:**
config ([YosoConfig](/docs/transformers/main/vi/model_doc/yoso#transformers.YosoConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số của mô hình.
Biến thể Yoso transformer với một đầu phân loại token phía trên (một lớp tuyến tính đặt trên đầu ra của hidden-states), ví dụ cho các tác vụ Nhận thực thể có tên (NER).
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.YosoForTokenClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/yoso/modeling_yoso.py#L987)
**Tham số:**
input_ids (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số của các token trong chuỗi đầu vào theo từ vựng. Mặc định, các token đệm (padding) sẽ bị bỏ qua. Có thể lấy chỉ số bằng cách sử dụng [AutoTokenizer](/docs/transformers/main/vi/model_doc/auto#transformers.AutoTokenizer). Xem [PreTrainedTokenizer.encode()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) và [PreTrainedTokenizer.__call__()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) để biết thêm chi tiết. [ID đầu vào là gì?](../glossary#input-ids)
attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**. [Mặt nạ chú ý là gì?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` có shape `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số token phân đoạn để chỉ định phần đầu và phần thứ hai của các đầu vào. Các chỉ số được chọn trong `[0, 1]`: - 0 tương ứng với token *câu A*, - 1 tương ứng với token *câu B*. [Các ID loại token là gì?](../glossary#token-type-ids)
position_ids (`torch.Tensor` có shape `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số của vị trí các token trong mỗi chuỗi đầu vào trong các position embeddings. Được chọn trong khoảng `[0, config.n_positions - 1]`. [Position IDs là gì?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` có hình dạng `(batch_size, sequence_length, hidden_size)`, *tùy chọn*) : Tùy chọn, thay vì truyền `input_ids`, bạn có thể chọn cách truyền trực tiếp một biểu diễn nhúng. Điều này hữu ích nếu bạn muốn kiểm soát nhiều hơn cách chuyển đổi các chỉ số `input_ids` thành các vector liên quan so với ma trận tra cứu nhúng nội bộ của mô hình.
labels (`torch.LongTensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Nhãn để tính toán tổn thất phân loại token. Chỉ số phải nằm trong `[0, ..., config.num_labels - 1]`.
output_attentions (`bool`, *tùy chọn*) : Có trả về các tensor chú ý của tất cả các lớp chú ý hay không. Xem `attentions` trong phần tensor trả về để biết thêm chi tiết.
output_hidden_states (`bool`, *tuỳ chọn*) : Có trả về trạng thái ẩn của tất cả các lớp hay không. Xem `hidden_states` trong phần tensor trả về để biết thêm chi tiết.
return_dict (`bool`, *tùy chọn*) : Có trả về [ModelOutput](/docs/transformers/main/vi/main_classes/output#transformers.utils.ModelOutput) thay vì một tuple thông thường hay không.
**Trả về:** [TokenClassifierOutput](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.TokenClassifierOutput) hoặc `tuple(torch.Tensor)`
Một [TokenClassifierOutput](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.TokenClassifierOutput) hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các thành phần khác nhau tùy thuộc vào cấu hình ([YosoConfig](/docs/transformers/main/vi/model_doc/yoso#transformers.YosoConfig)) và đầu vào.
Phương thức forward của [YosoForTokenClassification](/docs/transformers/main/vi/model_doc/yoso#transformers.YosoForTokenClassification) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **loss** (`torch.Tensor` có hình dạng `(1,)`, *tùy chọn*, được trả về khi `labels` được cung cấp) -- Tổn phân loại.
- **logits** (`torch.Tensor` có hình dạng `(batch_size, sequence_length, config.num_labels)`) -- Điểm phân loại (trước SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple của `torch.Tensor` (một cho đầu ra của các embedding, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`.
Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
- **attentions** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ:
```python
>>> from transformers import AutoTokenizer, YosoForTokenClassification
>>> import torch
>>> tokenizer = AutoTokenizer.from_pretrained("uw-madison/yoso-4096")
>>> model = YosoForTokenClassification.from_pretrained("uw-madison/yoso-4096")
>>> inputs = tokenizer(
... "HuggingFace is a company based in Paris and New York", add_special_tokens=False, return_tensors="pt"
... )
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> predicted_token_class_ids = logits.argmax(-1)
>>> # Note that tokens are classified rather then input words which means that
>>> # there might be more predicted token classes than words.
>>> # Multiple token classes might account for the same word
>>> predicted_tokens_classes = [model.config.id2label[t.item()] for t in predicted_token_class_ids[0]]
>>> predicted_tokens_classes
...
>>> labels = predicted_token_class_ids
>>> loss = model(**inputs, labels=labels).loss
>>> round(loss.item(), 2)
...
```
## YosoForQuestionAnswering[[transformers.YosoForQuestionAnswering]]
#### transformers.YosoForQuestionAnswering[[transformers.YosoForQuestionAnswering]]
```python
transformers.YosoForQuestionAnswering(config: YosoConfig)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/yoso/modeling_yoso.py#L1046)
**Tham số:**
config ([YosoConfig](/docs/transformers/main/vi/model_doc/yoso#transformers.YosoConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số của mô hình.
Biến thể Yoso transformer với một đầu phân loại span phía trên cho các tác vụ trả lời câu hỏi trích xuất như SQuAD (một lớp tuyến tính phía trên đầu ra hidden-states để tính toán `span start logits` và `span end logits`).
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.YosoForQuestionAnswering.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, start_positions: typing.Optional[torch.Tensor] = None, end_positions: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/yoso/modeling_yoso.py#L1059)
**Tham số:**
input_ids (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số của các token trong chuỗi đầu vào theo từ vựng. Mặc định, các token đệm (padding) sẽ bị bỏ qua. Có thể lấy chỉ số bằng cách sử dụng [AutoTokenizer](/docs/transformers/main/vi/model_doc/auto#transformers.AutoTokenizer). Xem [PreTrainedTokenizer.encode()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) và [PreTrainedTokenizer.__call__()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) để biết thêm chi tiết. [ID đầu vào là gì?](../glossary#input-ids)
attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**. [Mặt nạ chú ý là gì?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` có shape `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số token phân đoạn để chỉ định phần đầu và phần thứ hai của các đầu vào. Các chỉ số được chọn trong `[0, 1]`: - 0 tương ứng với token *câu A*, - 1 tương ứng với token *câu B*. [Các ID loại token là gì?](../glossary#token-type-ids)
position_ids (`torch.Tensor` có shape `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số của vị trí các token trong mỗi chuỗi đầu vào trong các position embeddings. Được chọn trong khoảng `[0, config.n_positions - 1]`. [Position IDs là gì?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` có hình dạng `(batch_size, sequence_length, hidden_size)`, *tùy chọn*) : Tùy chọn, thay vì truyền `input_ids`, bạn có thể chọn cách truyền trực tiếp một biểu diễn nhúng. Điều này hữu ích nếu bạn muốn kiểm soát nhiều hơn cách chuyển đổi các chỉ số `input_ids` thành các vector liên quan so với ma trận tra cứu nhúng nội bộ của mô hình.
start_positions (`torch.Tensor` có shape `(batch_size,)`, *tùy chọn*) : Nhãn cho vị trí (chỉ số) bắt đầu của span được gắn nhãn để tính toán tổn thất phân loại token. Các vị trí được kẹp (clamp) theo độ dài của chuỗi (`sequence_length`). Các vị trí nằm ngoài chuỗi sẽ không được tính đến khi tính toán tổn thất.
end_positions (`torch.Tensor` có shape `(batch_size,)`, *tùy chọn*) : Nhãn cho vị trí (chỉ số) của điểm kết thúc của span được gắn nhãn để tính toán tổn thất phân loại token. Các vị trí được kẹp (clamp) theo độ dài của chuỗi (`sequence_length`). Các vị trí nằm ngoài chuỗi sẽ không được tính đến khi tính toán tổn thất.
output_attentions (`bool`, *tùy chọn*) : Có trả về các tensor chú ý của tất cả các lớp chú ý hay không. Xem `attentions` trong phần tensor trả về để biết thêm chi tiết.
output_hidden_states (`bool`, *tuỳ chọn*) : Có trả về trạng thái ẩn của tất cả các lớp hay không. Xem `hidden_states` trong phần tensor trả về để biết thêm chi tiết.
return_dict (`bool`, *tùy chọn*) : Có trả về [ModelOutput](/docs/transformers/main/vi/main_classes/output#transformers.utils.ModelOutput) thay vì một tuple thông thường hay không.
**Trả về:** [QuestionAnsweringModelOutput](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.QuestionAnsweringModelOutput) hoặc `tuple(torch.Tensor)`
Một [QuestionAnsweringModelOutput](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.QuestionAnsweringModelOutput) hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([YosoConfig](/docs/transformers/main/vi/model_doc/yoso#transformers.YosoConfig)) và đầu vào.
Phương thức forward của [YosoForQuestionAnswering](/docs/transformers/main/vi/model_doc/yoso#transformers.YosoForQuestionAnswering) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **loss** (`torch.Tensor` có shape `(1,)`, *optional*, được trả về khi `labels` được cung cấp) -- Tổng loss trích xuất span là tổng của Cross-Entropy cho các vị trí bắt đầu và kết thúc.
- **start_logits** (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`) -- Điểm số bắt đầu span (trước SoftMax).
- **end_logits** (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`) -- Điểm số kết thúc span (trước SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple của `torch.Tensor` (một cho đầu ra của các embedding, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`.
Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
- **attentions** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ:
```python
>>> from transformers import AutoTokenizer, YosoForQuestionAnswering
>>> import torch
>>> tokenizer = AutoTokenizer.from_pretrained("uw-madison/yoso-4096")
>>> model = YosoForQuestionAnswering.from_pretrained("uw-madison/yoso-4096")
>>> question, text = "Who was Jim Henson?", "Jim Henson was a nice puppet"
>>> inputs = tokenizer(question, text, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model(**inputs)
>>> answer_start_index = outputs.start_logits.argmax()
>>> answer_end_index = outputs.end_logits.argmax()
>>> predict_answer_tokens = inputs.input_ids[0, answer_start_index : answer_end_index + 1]
>>> tokenizer.decode(predict_answer_tokens, skip_special_tokens=True)
...
>>> # target is "nice puppet"
>>> target_start_index = torch.tensor([14])
>>> target_end_index = torch.tensor([15])
>>> outputs = model(**inputs, start_positions=target_start_index, end_positions=target_end_index)
>>> loss = outputs.loss
>>> round(loss.item(), 2)
...
```