# ViTMatte
## Aperçu
Le modèle ViTMatte a été proposé dans [Boosting Image Matting with Pretrained Plain Vision Transformers](https://huggingface.co/papers/2305.15272) par Jingfeng Yao, Xinggang Wang, Shusheng Yang et Baoyuan Wang. ViTMatte exploite des [Vision Transformers](vit) simples pour la tâche de matting d’images, qui consiste à estimer avec précision l’objet au premier plan dans les images et les vidéos.
L'abstract de l'article est le suivant :
*Récemment, les Transformers de vision simples (ViT) ont démontré des performances impressionnantes sur diverses tâches de vision par ordinateur, grâce à leur forte capacité de modélisation et à leur pré-entraînement à grande échelle. Cependant, ils n'ont pas encore conquis le problème du matting d'image. Nous supposons que le matting d'image pourrait également être amélioré par les ViT et présentons un nouveau système de matting basé sur ViT, efficace et robuste, nommé ViTMatte. Notre méthode utilise (i) un mécanisme d'attention hybride combiné à un cou de convolution pour aider les ViT à atteindre un excellent compromis performance-calcul dans les tâches de matting. (ii) De plus, nous introduisons le module de capture de détails, qui ne consiste qu'en de simples convolutions légères pour compléter les informations détaillées requises par le matting. À notre connaissance, ViTMatte est le premier travail à exploiter le potentiel du ViT sur le matting d'image avec une adaptation concise. Il hérite de nombreuses propriétés supérieures du ViT pour le matting, y compris diverses stratégies de pré-entraînement, une conception d'architecture concise et des stratégies d'inférence flexibles. Nous évaluons ViTMatte sur Composition-1k et Distinctions-646, les benchmarks les plus couramment utilisés pour le matting d'image ; notre méthode atteint des performances de l'état de l'art et surpasse largement les travaux antérieurs de matting.*
Ce modèle a été contribué par [nielsr](https://huggingface.co/nielsr). Le code d'origine peut être trouvé [ici](https://github.com/hustvl/ViTMatte).
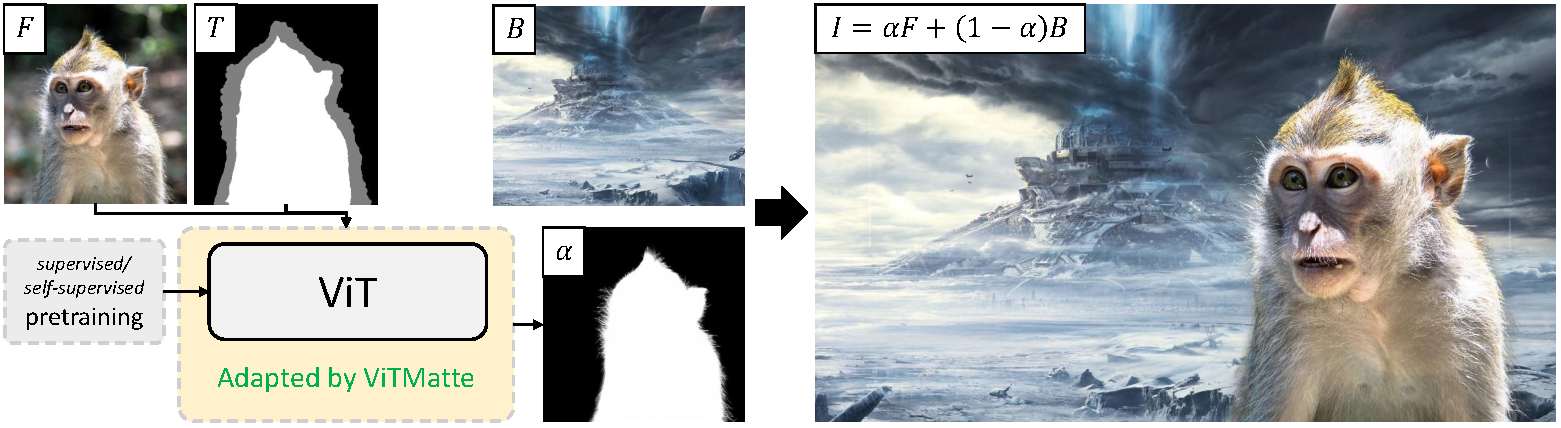 Vue d'ensemble de ViTMatte. Issue de l'article original.
## Ressources
Une liste de ressources officielles Hugging Face et de la communauté (indiquées par 🌎) pour vous aider à démarrer avec ViTMatte.
- Un notebook de démonstration concernant l'inférence avec [VitMatteForImageMatting](/docs/transformers/main/fr/model_doc/vitmatte#transformers.VitMatteForImageMatting), y compris le remplacement d'arrière-plan, est disponible [ici](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/ViTMatte).
Le modèle s'attend à recevoir l'image et le trimap (concaténés) en entrée. Utilisez `ViTMatteImageProcessor` à cet effet.
## VitMatteConfig[[transformers.VitMatteConfig]]
#### transformers.VitMatteConfig[[transformers.VitMatteConfig]]
```python
transformers.VitMatteConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, backbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, hidden_size: int = 384, batch_norm_eps: float = 1e-05, initializer_range: float = 0.02, convstream_hidden_sizes: list[int] | tuple[int, ...] = (48, 96, 192), fusion_hidden_sizes: list[int] | tuple[int, ...] = (256, 128, 64, 32))
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vitmatte/configuration_vitmatte.py#L25)
**Paramètres :**
backbone_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *facultatif*) : La configuration du modèle de base.
hidden_size (`int`, *facultatif*, par défaut `384`) : Dimension des représentations cachées.
batch_norm_eps (`float`, *facultatif*, valeur par défaut 1e-05) : L'épsilon utilisé par les couches de normalisation par lot.
initializer_range (`float`, *facultatif*, valeur par défaut `0.02`) : L'écart-type de la truncated_normal_initializer utilisé pour l'initialisation de toutes les matrices de poids.
convstream_hidden_sizes (`list[int]`, *facultatif*, par défaut `[48, 96, 192]`) : Les canaux de sortie du module ConvStream.
fusion_hidden_sizes (`list[int]`, *facultatif*, par défaut `[256, 128, 64, 32]`) : Les canaux de sortie des blocs Fusion.
Il s'agit de la classe de configuration destinée à stocker la configuration d'un VitmatteModel. Elle est utilisée pour instancier un modèle Vitmatte en fonction des arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de [hustvl/vitmatte-small-composition-1k](https://huggingface.co/hustvl/vitmatte-small-composition-1k)
Les objets de configuration héritent de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) pour plus d’informations.
Exemple :
```python
>>> from transformers import VitMatteConfig, VitMatteForImageMatting
>>> # Initializing a ViTMatte hustvl/vitmatte-small-composition-1k style configuration
>>> configuration = VitMatteConfig()
>>> # Initializing a model (with random weights) from the hustvl/vitmatte-small-composition-1k style configuration
>>> model = VitMatteForImageMatting(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## VitMatteImageProcessor[[transformers.VitMatteImageProcessor]]
#### transformers.VitMatteImageProcessor[[transformers.VitMatteImageProcessor]]
```python
transformers.VitMatteImageProcessor(**kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vitmatte/image_processing_vitmatte.py#L45)
**Paramètres :**
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut par défaut redimensionner l'image en un carré si la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*, valeur par défaut `0.00392156862745098`) : Facteur de remise à l'échelle appliqué à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.5, 0.5, 0.5]`) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.5, 0.5, 0.5]`) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
size_divisor (`int`, *kwargs*, *facultatif*, valeur par défaut `self.size_divisor`) : La largeur et la hauteur de l'image seront rembourrées pour être divisibles par ce nombre.
Construit un processeur d’image VitMatteImageProcessor.
#### prétraiter[[transformers.VitMatteImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], trimaps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vitmatte/image_processing_vitmatte.py#L87)
**Paramètres :**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Image à prétraiter. Attend une image unique ou un lot d'images dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
trimaps (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Les trimaps à prétraiter.
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*) : Indique s'il faut par défaut redimensionner l'image en un carré lorsque la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*) : Facteur de redimensionnement à appliquer à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
size_divisor (`int`, *kwargs*, *facultatif*, valeur par défaut `self.size_divisor`) : La largeur et la hauteur de l'image seront rembourrées pour être divisibles par ce nombre.
**Retourne :** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionnaire de listes/tableaux/tenseurs renvoyé par la méthode __call__ (« pixel_values », etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *facultatif*) -- Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation.
## VitMatteImageProcessorPil[[transformers.VitMatteImageProcessorPil]]
#### transformers.VitMatteImageProcessorPil[[transformers.VitMatteImageProcessorPil]]
```python
transformers.VitMatteImageProcessorPil(**kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vitmatte/image_processing_pil_vitmatte.py#L44)
**Paramètres :**
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut par défaut redimensionner l'image en un carré si la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*, valeur par défaut `0.00392156862745098`) : Facteur de remise à l'échelle appliqué à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.5, 0.5, 0.5]`) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.5, 0.5, 0.5]`) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
size_divisor (`int`, *kwargs*, *facultatif*, valeur par défaut `self.size_divisor`) : La largeur et la hauteur de l'image seront rembourrées pour être divisibles par ce nombre.
Construit un processeur d’image VitMatteImageProcessor.
#### prétraiter[[transformers.VitMatteImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], trimaps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vitmatte/image_processing_pil_vitmatte.py#L89)
**Paramètres :**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Image à prétraiter. Attend une image unique ou un lot d'images dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
trimaps (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Les trimaps à prétraiter.
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*) : Indique s'il faut par défaut redimensionner l'image en un carré lorsque la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*) : Facteur de redimensionnement à appliquer à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
size_divisor (`int`, *kwargs*, *facultatif*, valeur par défaut `self.size_divisor`) : La largeur et la hauteur de l'image seront rembourrées pour être divisibles par ce nombre.
**Retourne :** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionnaire de listes/tableaux/tenseurs renvoyé par la méthode __call__ (« pixel_values », etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *facultatif*) -- Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation.
## VitMatteForImageMatting[[transformers.VitMatteForImageMatting]]
#### transformers.VitMatteForImageMatting[[transformers.VitMatteForImageMatting]]
```python
transformers.VitMatteForImageMatting(config: VitMatteConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vitmatte/modeling_vitmatte.py#L221)
**Paramètres :**
config ([VitMatteConfig](/docs/transformers/main/fr/model_doc/vitmatte#transformers.VitMatteConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L'initialisation à partir d'un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Cadre ViTMatte exploitant n'importe quel backbone de vision, par exemple pour ADE20k, CityScapes.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.VitMatteForImageMatting.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, **kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vitmatte/modeling_vitmatte.py#L232)
**Paramètres :**
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`, *facultatif*) : Les tenseurs correspondant aux images d'entrée. Les valeurs des pixels peuvent être obtenues à l'aide de [VitMatteImageProcessor](/docs/transformers/main/fr/model_doc/vitmatte#transformers.VitMatteImageProcessor). Voir [VitMatteImageProcessor.__call__()](/docs/transformers/main/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails (`processor_class` utilise [VitMatteImageProcessor](/docs/transformers/main/fr/model_doc/vitmatte#transformers.VitMatteImageProcessor) pour le traitement des images).
output_attentions (`bool`, *facultatif*) : Indique s'il faut ou non retourner les tenseurs d'attention de toutes les couches d'attention. Voir `attentions` sous les tenseurs retournés pour plus de détails.
output_hidden_states (`bool`, *facultatif*) : Indique s'il faut retourner les états cachés de toutes les couches. Voir `hidden_states` dans les tenseurs retournés pour plus de détails.
labels (`torch.LongTensor` de forme `(batch_size, height, width)`, *facultatif*) : Image de matting de référence pour le calcul de la perte.
return_dict (`bool`, *facultatif*) : Indique s'il faut retourner un [ModelOutput](/docs/transformers/main/fr/main_classes/output#transformers.utils.ModelOutput) plutôt qu'un simple tuple.
La méthode forward de [VitMatteForImageMatting](/docs/transformers/main/fr/model_doc/vitmatte#transformers.VitMatteForImageMatting) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
Exemples :
```python
>>> from transformers import VitMatteImageProcessor, VitMatteForImageMatting
>>> import torch
>>> from PIL import Image
>>> from huggingface_hub import hf_hub_download
>>> processor = VitMatteImageProcessor.from_pretrained("hustvl/vitmatte-small-composition-1k")
>>> model = VitMatteForImageMatting.from_pretrained("hustvl/vitmatte-small-composition-1k")
>>> filepath = hf_hub_download(
... repo_id="hf-internal-testing/image-matting-fixtures", filename="image.png", repo_type="dataset"
... )
>>> image = Image.open(filepath).convert("RGB")
>>> filepath = hf_hub_download(
... repo_id="hf-internal-testing/image-matting-fixtures", filename="trimap.png", repo_type="dataset"
... )
>>> trimap = Image.open(filepath).convert("L")
>>> # prepare image + trimap for the model
>>> inputs = processor(images=image, trimaps=trimap, return_tensors="pt")
>>> with torch.no_grad():
... alphas = model(**inputs).alphas
>>> print(alphas.shape)
torch.Size([1, 1, 640, 960])
```