# MarkupLM
## Resumen
El modelo MarkupLM se propuso en [MarkupLM: Pre-training of Text and Markup Language for Visually-rich Document Understanding](https://huggingface.co/papers/2110.08518) de Junlong Li, Yiheng Xu, Lei Cui y Furu Wei. MarkupLM es BERT, pero aplicado a páginas HTML en lugar de documentos de texto sin formato. El modelo incorpora capas de embedding adicionales para mejorar el rendimiento, de manera similar a [LayoutLM](layoutlm).
El modelo puede utilizarse para tareas como la respuesta a preguntas en páginas web o la extracción de información de páginas web. Obtiene resultados de estado del arte en 2 benchmarks importantes:
- [WebSRC](https://x-lance.github.io/WebSRC/), un conjunto de datos para la comprensión lectora estructural basada en la web (algo similar a SQuAD pero para páginas web)
- [SWDE](https://www.researchgate.net/publication/221299838_From_one_tree_to_a_forest_a_unified_solution_for_structured_web_data_extraction), un conjunto de datos
para la extracción de información de páginas web (básicamente, reconocimiento de entidades nombradas en páginas web)
El resumen del artículo es el siguiente:
*El preentrenamiento multimodal con texto, diseño e imagen ha logrado avances significativos en la comprensión de documentos visualmente ricos (VrDU), especialmente en documentos de diseño fijo, como las imágenes de documentos escaneados. Sin embargo, aún existe un gran número de documentos digitales en los que la información de diseño no es fija y debe renderizarse de forma interactiva y dinámica para su visualización, lo que dificulta la aplicación de los enfoques de preentrenamiento basados en diseño existentes. En este artículo, proponemos MarkupLM para tareas de comprensión de documentos que utilizan lenguajes de marcado como columna vertebral, como los documentos basados en HTML/XML, donde la información de texto y de marcado se preentrena de forma conjunta. Los resultados experimentales muestran que el MarkupLM preentrenado supera significativamente a los modelos de línea base existentes y de alto rendimiento en varias tareas de comprensión de documentos. El modelo preentrenado y el código estarán disponibles públicamente.*
Este modelo fue aportado por [nielsr](https://huggingface.co/nielsr). El código original se puede encontrar [aquí](https://github.com/microsoft/unilm/tree/master/markuplm).
## Consejos de uso
- Además de `input_ids`, [forward()](/docs/transformers/main/es/model_doc/markuplm#transformers.MarkupLMModel.forward) espera 2 entradas adicionales, a saber, `xpath_tags_seq` y `xpath_subs_seq`.
Estas son las etiquetas XPATH y los subíndices, respectivamente, para cada token en la secuencia de entrada.
- Se puede usar [MarkupLMProcessor](/docs/transformers/main/es/model_doc/markuplm#transformers.MarkupLMProcessor) para preparar todos los datos para el modelo. Consulte la [guía de uso](#usage-markuplmprocessor) para obtener más información.
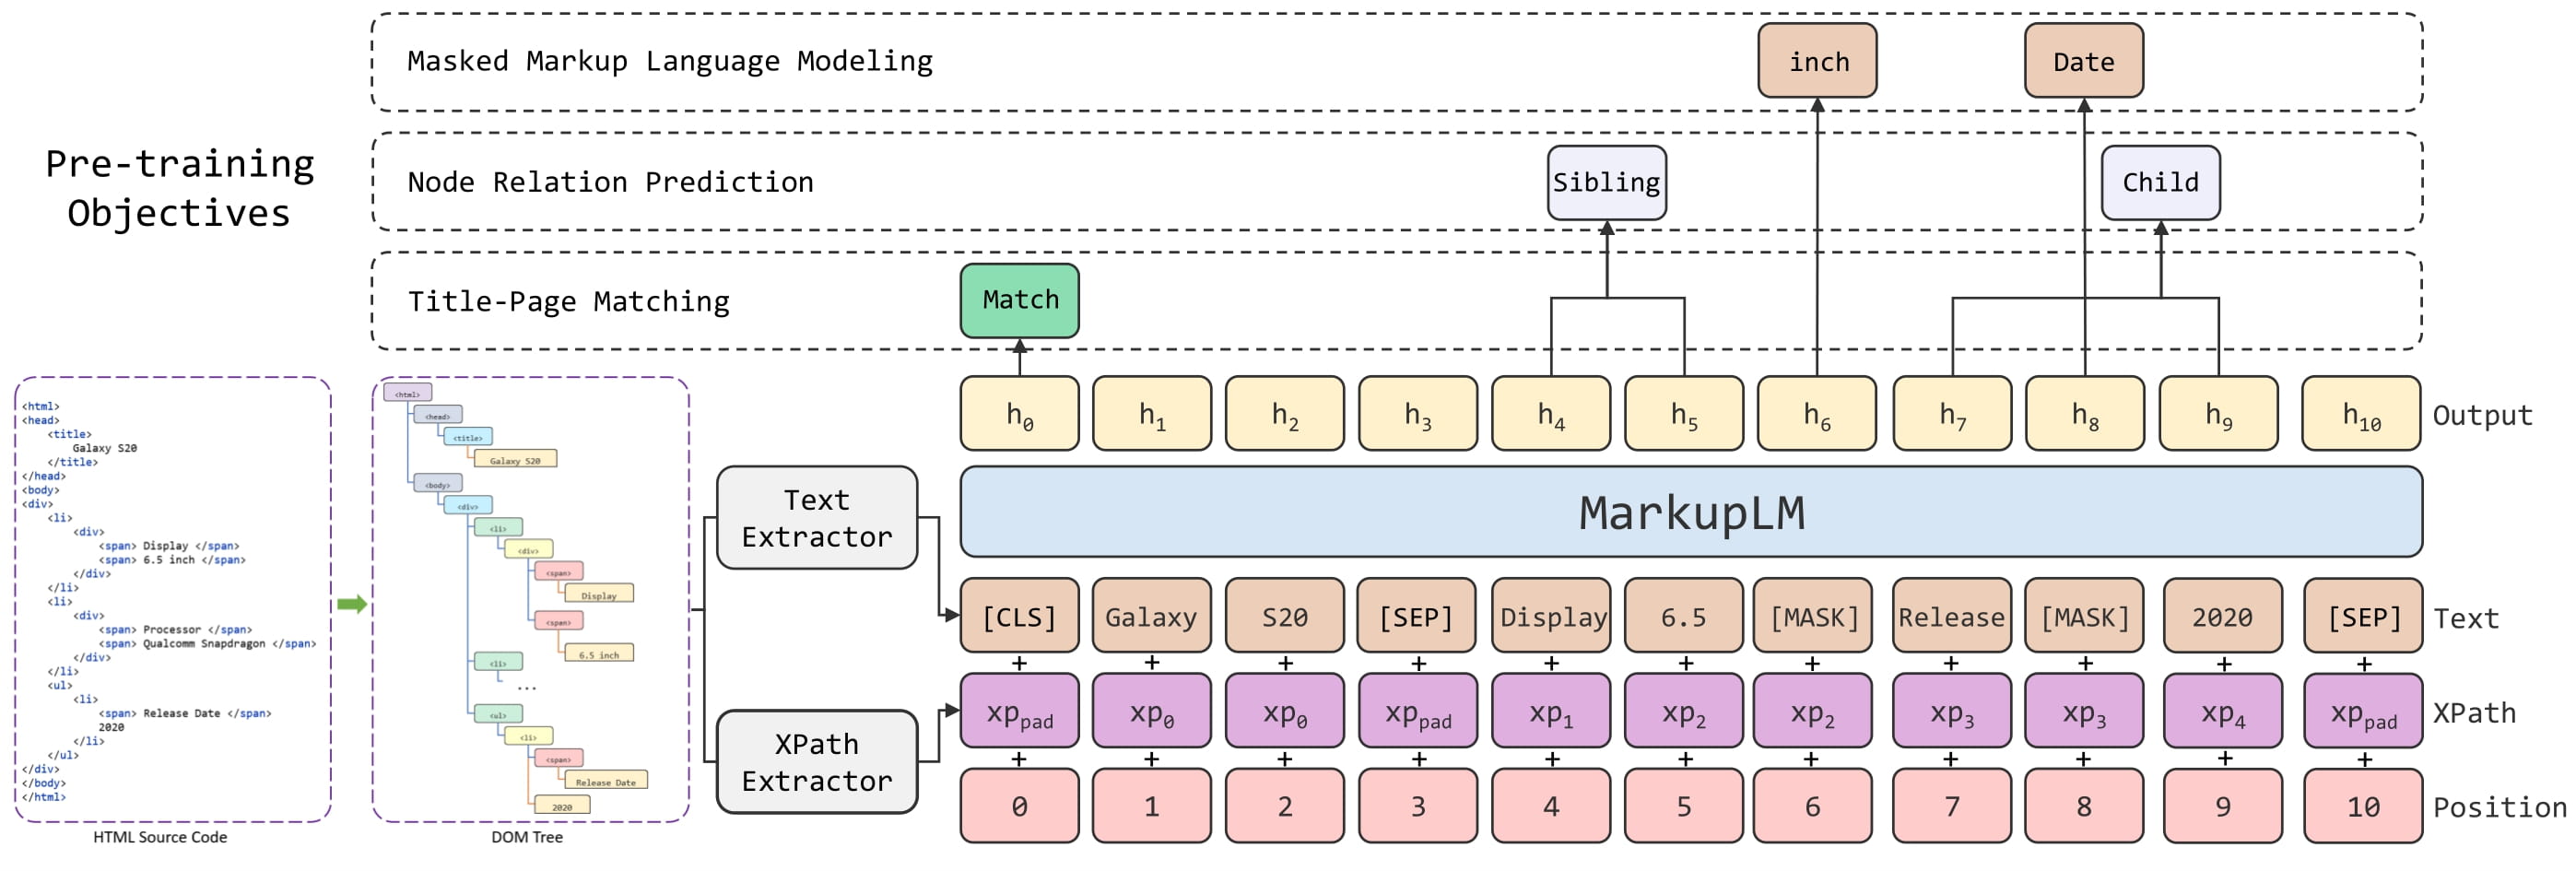 Arquitectura de MarkupLM. Tomada del artículo original.
## Uso: MarkupLMProcessor
La forma más sencilla de preparar los datos para el modelo es utilizar [MarkupLMProcessor](/docs/transformers/main/es/model_doc/markuplm#transformers.MarkupLMProcessor), que internamente combina un extractor de características ([MarkupLMFeatureExtractor](/docs/transformers/main/es/model_doc/markuplm#transformers.MarkupLMFeatureExtractor)) y un tokenizador ([MarkupLMTokenizer](/docs/transformers/main/es/model_doc/markuplm#transformers.MarkupLMTokenizer) o [MarkupLMTokenizerFast](/docs/transformers/main/es/model_doc/markuplm#transformers.MarkupLMTokenizer)). El extractor de características se utiliza para extraer todos los nodos y xpaths de las cadenas HTML, que luego se proporcionan al tokenizador, el cual los convierte en las entradas a nivel de token del modelo (`input_ids`, etc.). Tenga en cuenta que aún puede utilizar el extractor de características y el tokenizador por separado si solo desea realizar una de las dos tareas.
```python
from transformers import MarkupLMFeatureExtractor, MarkupLMProcessor, MarkupLMTokenizerFast
feature_extractor = MarkupLMFeatureExtractor()
tokenizer = MarkupLMTokenizerFast.from_pretrained("microsoft/markuplm-base")
processor = MarkupLMProcessor(feature_extractor, tokenizer)
```
En resumen, se pueden proporcionar cadenas HTML (y posiblemente datos adicionales) a [MarkupLMProcessor](/docs/transformers/main/es/model_doc/markuplm#transformers.MarkupLMProcessor), y este creará las entradas que el modelo espera. Internamente, el procesador primero utiliza [MarkupLMFeatureExtractor](/docs/transformers/main/es/model_doc/markuplm#transformers.MarkupLMFeatureExtractor) para obtener una lista de nodos y los xpaths correspondientes. A continuación, los nodos y los xpaths se proporcionan a [MarkupLMTokenizer](/docs/transformers/main/es/model_doc/markuplm#transformers.MarkupLMTokenizer) o [MarkupLMTokenizerFast](/docs/transformers/main/es/model_doc/markuplm#transformers.MarkupLMTokenizer), que los convierte en `input_ids`, `attention_mask`, `token_type_ids`, `xpath_subs_seq` y `xpath_tags_seq` a nivel de token. Opcionalmente, se pueden proporcionar etiquetas de nodos al procesador, que se convierten en `labels` a nivel de token.
[MarkupLMFeatureExtractor](/docs/transformers/main/es/model_doc/markuplm#transformers.MarkupLMFeatureExtractor) utiliza [Beautiful Soup](https://www.crummy.com/software/BeautifulSoup/bs4/doc/), una biblioteca de Python para extraer datos de archivos HTML y XML, internamente. Ten en cuenta que puedes seguir usando tu propia solución de análisis preferida y proporcionar los nodos y xpaths tú mismo a [MarkupLMTokenizer](/docs/transformers/main/es/model_doc/markuplm#transformers.MarkupLMTokenizer) o [MarkupLMTokenizerFast](/docs/transformers/main/es/model_doc/markuplm#transformers.MarkupLMTokenizer).
En total, hay 5 casos de uso que son compatibles con el procesador. A continuación, los enumeramos todos. Tenga en cuenta que cada uno de estos casos de uso funciona tanto para entradas por lotes como para entradas no por lotes (los ilustramos para entradas no por lotes).
**Caso de uso 1: clasificación de páginas web (entrenamiento, inferencia) + clasificación de tokens (inferencia), parse_html = True**
Este es el caso más simple, en el que el procesador utilizará el extractor de características para obtener todos los nodos y xpaths del HTML.
```python
from transformers import MarkupLMProcessor
processor = MarkupLMProcessor.from_pretrained("microsoft/markuplm-base")
html_string = """
Hello world
Welcome
Here is my website.
"""
# note that you can also add provide all tokenizer parameters here such as padding, truncation
encoding = processor(html_string, return_tensors="pt").to(model.device)
print(encoding.keys())
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'xpath_tags_seq', 'xpath_subs_seq'])
```
**Caso de uso 2: clasificación de páginas web (entrenamiento, inferencia) + clasificación de tokens (inferencia), parse_html=False**
Si ya se han obtenido todos los nodos y xpaths, no se necesita el extractor de características. En ese caso, se deben proporcionar los nodos y los xpaths correspondientes directamente al procesador, y asegurarse de establecer `parse_html` en `False`.
```python
from transformers import MarkupLMProcessor
processor = MarkupLMProcessor.from_pretrained("microsoft/markuplm-base")
processor.parse_html = False
nodes = ["hello", "world", "how", "are"]
xpaths = ["/html/body/div/li[1]/div/span", "/html/body/div/li[1]/div/span", "html/body", "html/body/div"]
encoding = processor(nodes=nodes, xpaths=xpaths, return_tensors="pt").to(model.device)
print(encoding.keys())
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'xpath_tags_seq', 'xpath_subs_seq'])
```
**Caso de uso 3: clasificación de tokens (entrenamiento), parse_html=False**
Para tareas de clasificación de tokens (como [SWDE](https://paperswithcode.com/dataset/swde)), también se pueden proporcionar las etiquetas de nodo correspondientes para entrenar un modelo. El procesador convertirá estas etiquetas en `labels` a nivel de token. De forma predeterminada, solo etiquetará la primera wordpiece de una palabra y etiquetará las wordpieces restantes con -100, que es el `ignore_index` de CrossEntropyLoss de PyTorch. Si desea que todas las wordpieces de una palabra estén etiquetadas, puede inicializar el tokenizador con `only_label_first_subword` establecido en `False`.
```python
from transformers import MarkupLMProcessor
processor = MarkupLMProcessor.from_pretrained("microsoft/markuplm-base")
processor.parse_html = False
nodes = ["hello", "world", "how", "are"]
xpaths = ["/html/body/div/li[1]/div/span", "/html/body/div/li[1]/div/span", "html/body", "html/body/div"]
node_labels = [1, 2, 2, 1]
encoding = processor(nodes=nodes, xpaths=xpaths, node_labels=node_labels, return_tensors="pt").to(model.device)
print(encoding.keys())
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'xpath_tags_seq', 'xpath_subs_seq', 'labels'])
```
**Caso de uso 4: respuesta a preguntas sobre páginas web (inferencia), parse_html=True**
Para tareas de respuesta a preguntas en páginas web, puede proporcionar una pregunta al procesador. De forma predeterminada, el procesador utilizará el extractor de características para obtener todos los nodos y xpaths, y creará [CLS] tokens de la pregunta [SEP] tokens de palabras [SEP].
```python
from transformers import MarkupLMProcessor
processor = MarkupLMProcessor.from_pretrained("microsoft/markuplm-base")
html_string = """
Hello world
Welcome
My name is Niels.
"""
question = "What's his name?"
encoding = processor(html_string, questions=question, return_tensors="pt").to(model.device)
print(encoding.keys())
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'xpath_tags_seq', 'xpath_subs_seq'])
```
**Caso de uso 5: respuesta a preguntas sobre páginas web (inferencia), parse_html=False**
Para tareas de respuesta a preguntas (como WebSRC), puede proporcionar una pregunta al procesador. Si ha extraído todos los nodos y xpaths por su cuenta, puede proporcionarlos directamente al procesador. Asegúrese de establecer `parse_html` en `False`.
```python
from transformers import MarkupLMProcessor
processor = MarkupLMProcessor.from_pretrained("microsoft/markuplm-base")
processor.parse_html = False
nodes = ["hello", "world", "how", "are"]
xpaths = ["/html/body/div/li[1]/div/span", "/html/body/div/li[1]/div/span", "html/body", "html/body/div"]
question = "What's his name?"
encoding = processor(nodes=nodes, xpaths=xpaths, questions=question, return_tensors="pt").to(model.device)
print(encoding.keys())
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'xpath_tags_seq', 'xpath_subs_seq'])
```
## Recursos
- [Cuadernos de demostración](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/MarkupLM)
- [Guía de la tarea de clasificación de texto](../tasks/sequence_classification)
- [Guía de la tarea de clasificación de tokens](../tasks/token_classification)
- [Guía de la tarea de respuesta a preguntas](../tasks/question_answering)
## MarkupLMConfig[[transformers.MarkupLMConfig]]
#### transformers.MarkupLMConfig[[transformers.MarkupLMConfig]]
```python
transformers.MarkupLMConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 30522, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.1, attention_probs_dropout_prob: float | int = 0.1, max_position_embeddings: int = 512, type_vocab_size: int = 2, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, pad_token_id: int | None = 0, bos_token_id: int | None = 0, eos_token_id: int | list[int] | None = 2, max_xpath_tag_unit_embeddings: int = 256, max_xpath_subs_unit_embeddings: int = 1024, tag_pad_id: int = 216, subs_pad_id: int = 1001, xpath_unit_hidden_size: int = 32, max_depth: int = 50, use_cache: bool = True, classifier_dropout: float | int | None = None)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/configuration_markuplm.py#L24)
**Parámetros:**
vocab_size (`int`, *opcional*, valor predeterminado `30522`) : Tamaño del vocabulario del modelo. Define el número de tokens diferentes que pueden representarse mediante `input_ids`.
hidden_size (`int`, *opcional*, valor predeterminado `768`) : Dimensión de las representaciones ocultas.
num_hidden_layers (`int`, *opcional*, valor predeterminado `12`) : Número de capas ocultas en el decodificador del Transformer.
num_attention_heads (`int`, *opcional*, valor predeterminado `12`) : Número de cabezas de atención para cada capa de atención en el decodificador Transformer.
intermediate_size (`int`, *opcional*, valor predeterminado `3072`) : Dimensión de las representaciones MLP.
hidden_act (`str`, *opcional*, valor predeterminado `gelu`) : La función de activación no lineal (función o cadena) en el decodificador. Por ejemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
hidden_dropout_prob (`Union[float, int]`, *opcional*, valor predeterminado `0.1`) : La probabilidad de dropout para todas las capas totalmente conectadas en los embeddings, el codificador y el pooler.
attention_probs_dropout_prob (`Union[float, int]`, *opcional*, valor predeterminado `0.1`) : La proporción de dropout para las probabilidades de atención.
max_position_embeddings (`int`, *opcional*, valor predeterminado `512`) : La longitud máxima de secuencia con la que se podría utilizar este modelo.
type_vocab_size (`int`, *opcional*, valor predeterminado `2`) : El tamaño del vocabulario de `token_type_ids`.
initializer_range (`float`, *opcional*, valor predeterminado `0.02`) : La desviación estándar de truncated_normal_initializer para inicializar todas las matrices de pesos.
layer_norm_eps (`float`, *opcional*, valor predeterminado `1e-12`) : El epsilon utilizado por las capas de normalización de capas.
pad_token_id (`int`, *opcional*, valor predeterminado `0`) : Id de token utilizado para el relleno en el vocabulario.
bos_token_id (`int`, *opcional*, valor predeterminado `0`) : Id de token utilizado para el inicio de la secuencia en el vocabulario.
eos_token_id (`Union[int, list[int]]`, *opcional*, valor predeterminado `2`) : Identificador de token utilizado para el fin de la secuencia en el vocabulario.
max_xpath_tag_unit_embeddings (`int`, *opcional*, valor predeterminado 256) : El valor máximo que podría llegar a usar la incrustación de la unidad de etiqueta xpath. Por lo general, se establece en un valor grande por si acaso (p. ej., 256).
max_xpath_subs_unit_embeddings (`int`, *opcional*, valor predeterminado 1024) : El valor máximo que podría llegar a utilizar la incrustación de la unidad de subíndice xpath. Por lo general, se establece en un valor grande por si acaso (p. ej., 1024).
tag_pad_id (`int`, *opcional*, valor predeterminado 216) : El id del token de relleno en las etiquetas xpath.
subs_pad_id (`int`, *opcional*, valor predeterminado 1001) : El id del token de relleno en los subíndices de xpath.
xpath_unit_hidden_size (`int`, *opcional*, valor predeterminado 32) : El tamaño oculto de cada unidad en xpath.
max_depth (`int`, *opcional*, valor predeterminado 50) : La profundidad máxima en xpath.
use_cache (`bool`, *opcional*, valor predeterminado `True`) : Indica si el modelo debe devolver las últimas atenciones de claves/valores (no se utiliza en todos los modelos). Solo es relevante si `config.is_decoder=True` o cuando el modelo es un modelo generativo solo de decodificador.
classifier_dropout (`Union[float, int]`, *opcional*) : La proporción de dropout para el clasificador.
Esta es la clase de configuración para almacenar la configuración de un MarkupLMModel. Se utiliza para instanciar un modelo Markuplm según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de [microsoft/markuplm-base](https://huggingface.co/microsoft/markuplm-base)
Los objetos de configuración heredan de [PreTrainedConfig](/docs/transformers/main/es/main_classes/configuration#transformers.PreTrainedConfig) y se pueden utilizar para controlar las salidas del modelo. Consulte la documentación de [PreTrainedConfig](/docs/transformers/main/es/main_classes/configuration#transformers.PreTrainedConfig) para obtener más información.
Ejemplos:
```python
>>> from transformers import MarkupLMModel, MarkupLMConfig
>>> # Initializing a MarkupLM microsoft/markuplm-base style configuration
>>> configuration = MarkupLMConfig()
>>> # Initializing a model from the microsoft/markuplm-base style configuration
>>> model = MarkupLMModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## MarkupLMFeatureExtractor[[transformers.MarkupLMFeatureExtractor]]
#### transformers.MarkupLMFeatureExtractor[[transformers.MarkupLMFeatureExtractor]]
```python
transformers.MarkupLMFeatureExtractor(**kwargs)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/feature_extraction_markuplm.py#L32)
Construye un extractor de características de MarkupLM. Se puede utilizar para obtener una lista de nodos y los xpath correspondientes a partir de cadenas HTML.
Este extractor de características hereda de `PreTrainedFeatureExtractor()`, que contiene la mayoría de los métodos principales. Los usuarios deben consultar esta superclase para obtener más información sobre dichos métodos.
#### __llamada__[[transformers.MarkupLMFeatureExtractor.__call__]]
```python
__call__(html_strings)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/feature_extraction_markuplm.py#L98)
**Parámetros:**
html_strings (`str`, `list[str]`) : La cadena HTML o el lote de cadenas HTML de las que se extraerán los nodos y los xpaths correspondientes.
**Devuelve:** [BatchFeature](/docs/transformers/main/es/main_classes/feature_extractor#transformers.BatchFeature)
Un [BatchFeature](/docs/transformers/main/es/main_classes/feature_extractor#transformers.BatchFeature) con los siguientes campos:
- **nodes** -- Nodos.
- **xpaths** -- xpaths correspondientes.
Método principal para preparar una o varias cadenas HTML para el modelo.
Ejemplos:
```python
>>> from transformers import MarkupLMFeatureExtractor
>>> page_name_1 = "page1.html"
>>> page_name_2 = "page2.html"
>>> page_name_3 = "page3.html"
>>> with open(page_name_1) as f:
... single_html_string = f.read()
>>> feature_extractor = MarkupLMFeatureExtractor()
>>> # single example
>>> encoding = feature_extractor(single_html_string)
>>> print(encoding.keys())
>>> # dict_keys(['nodes', 'xpaths'])
>>> # batched example
>>> multi_html_strings = []
>>> with open(page_name_2) as f:
... multi_html_strings.append(f.read())
>>> with open(page_name_3) as f:
... multi_html_strings.append(f.read())
>>> encoding = feature_extractor(multi_html_strings)
>>> print(encoding.keys())
>>> # dict_keys(['nodes', 'xpaths'])
```
## MarkupLMTokenizer[[transformers.MarkupLMTokenizer]]
#### transformers.MarkupLMTokenizer[[transformers.MarkupLMTokenizer]]
```python
transformers.MarkupLMTokenizer(tags_dict, vocab: str | dict[str, int] | list[tuple[str, float]] | None = None, merges: str | list[str] | None = None, errors = 'replace', bos_token = '', eos_token = '', sep_token = '', cls_token = '', unk_token = '', pad_token = '', mask_token = '', add_prefix_space = False, max_depth = 50, max_width = 1000, pad_width = 1001, pad_token_label = -100, only_label_first_subword = True, trim_offsets = False, **kwargs)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L91)
**Parámetros:**
vocab (`str` o `dict[str, int]`, *opcional*) : Diccionario de vocabulario personalizado. Si no se proporciona, el vocabulario se carga desde `vocab_file`.
merges (`str` o `list[str]`, *opcional*) : Lista de fusiones personalizada. Si no se proporciona, las fusiones se cargan desde `merges_file`.
errors (`str`, *opcional*, valor predeterminado `"replace"`) : Paradigma a seguir al decodificar bytes a UTF-8. Consulte [bytes.decode](https://docs.python.org/3/library/stdtypes.html#bytes.decode) para obtener más información.
bos_token (`str`, *opcional*, valor predeterminado `""`) : El token de inicio de secuencia que se utilizó durante el preentrenamiento. Puede usarse como token de clasificador de secuencias. Al construir una secuencia con tokens especiales, este no es el token que se utiliza para el inicio de la secuencia. El token que se utiliza es `cls_token`.
eos_token (`str`, *opcional*, valor predeterminado `""`) : El token de fin de secuencia. Al construir una secuencia con tokens especiales, este no es el token que se utiliza para el fin de secuencia. El token que se utiliza es `sep_token`.
sep_token (`str`, *opcional*, valor predeterminado `""`) : El token separador, que se utiliza al construir una secuencia a partir de varias secuencias, por ejemplo, dos secuencias para la clasificación de secuencias o un texto y una pregunta para la respuesta a preguntas. También se utiliza como el último token de una secuencia construida con tokens especiales.
cls_token (`str`, *opcional*, valor predeterminado `""`) : El token clasificador que se utiliza al realizar clasificación de secuencias (clasificación de la secuencia completa en lugar de clasificación por token). Es el primer token de la secuencia cuando se construye con tokens especiales.
unk_token (`str`, *opcional*, valor predeterminado `""`) : El token desconocido. Un token que no está en el vocabulario no se puede convertir en un ID y se establece como este token en su lugar.
pad_token (`str`, *opcional*, valor predeterminado `""`) : El token utilizado para el relleno, por ejemplo, al agrupar secuencias de diferentes longitudes.
mask_token (`str`, *opcional*, valor predeterminado `""`) : El token utilizado para enmascarar valores. Este es el token que se emplea al entrenar este modelo con modelado de lenguaje enmascarado. Es el token que el modelo intentará predecir.
add_prefix_space (`bool`, *opcional*, valor predeterminado `False`) : Indica si se debe añadir un espacio inicial a la entrada. Esto permite tratar la palabra inicial igual que cualquier otra palabra. (El tokenizador de RoBERTa detecta el inicio de las palabras mediante el espacio que las precede).
Construye un tokenizador de MarkupLM. Basado en Byte-Pair-Encoding (BPE) a nivel de bytes.
[MarkupLMTokenizer](/docs/transformers/main/es/model_doc/markuplm#transformers.MarkupLMTokenizer) se puede utilizar para convertir cadenas HTML en `input_ids`, `attention_mask`, `token_type_ids`, `xpath_tags_seq` y `xpath_tags_seq` a nivel de token. Este tokenizador hereda de [TokenizersBackend](/docs/transformers/main/es/main_classes/tokenizer#transformers.TokenizersBackend), que contiene la mayoría de los métodos principales y garantiza que siempre se instancie un backend de `tokenizers`.
Los usuarios deben consultar esta superclase para obtener más información sobre esos métodos.
#### build_inputs_with_special_tokens[[transformers.MarkupLMTokenizer.build_inputs_with_special_tokens]]
```python
build_inputs_with_special_tokens(token_ids_0: list, token_ids_1: list[int] | None = None)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L952)
**Parámetros:**
token_ids_0 (`list[int]`) : Lista de IDs a los que se les añadirán los tokens especiales.
token_ids_1 (`list[int]`, *opcional*) : Lista opcional de IDs para pares de secuencias.
**Devuelve:** `list[int]`
Lista de [ID de entrada](../glossary#input-ids) con los tokens especiales apropiados.
Construye las entradas del modelo a partir de una secuencia o un par de secuencias para tareas de clasificación de secuencias, concatenándolas y añadiendo tokens especiales. Una secuencia de RoBERTa tiene el siguiente formato:
- secuencia única: ` X `
- par de secuencias: ` A B `
#### get_special_tokens_mask[[transformers.MarkupLMTokenizer.get_special_tokens_mask]]
```python
get_special_tokens_mask(token_ids_0: list[int], token_ids_1: list[int] | None = None, already_has_special_tokens: bool = False)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/tokenization_utils_base.py#L1338)
**Parámetros:**
token_ids_0 : Lista de IDs de la secuencia (posiblemente ya formateada).
token_ids_1 : No se utiliza cuando `already_has_special_tokens=True`. En ese caso, debe ser None.
already_has_special_tokens : Si la secuencia ya está formateada con tokens especiales.
**Devuelve:** Una lista de enteros en el rango [0, 1]
1 para un token especial, 0 para un token de secuencia.
Obtener los ids de secuencia de una lista de tokens a la que no se le han añadido tokens especiales.
Para los tokenizadores rápidos, los collators de datos llaman a esta función con `already_has_special_tokens=True` para construir una máscara sobre una secuencia ya formateada. En ese caso, calculamos la máscara comprobando la pertenencia a `all_special_ids`.
#### create_token_type_ids_from_sequences[[transformers.MarkupLMTokenizer.create_token_type_ids_from_sequences]]
```python
create_token_type_ids_from_sequences(token_ids_0: list, token_ids_1: list[int] | None = None)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L975)
**Parámetros:**
token_ids_0 (`list[int]`) : Lista de IDs.
token_ids_1 (`list[int]`, *opcional*) : Lista opcional de IDs para pares de secuencias.
**Devuelve:** `list[int]`
Lista de ceros.
Crea una máscara a partir de las dos secuencias pasadas para su uso en una tarea de clasificación de pares de secuencias. RoBERTa no utiliza ids de tipo de token, por lo que se devuelve una lista de ceros.
#### save_vocabulary[[transformers.MarkupLMTokenizer.save_vocabulary]]
```python
save_vocabulary(save_directory: str, filename_prefix: str | None = None)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L997)
## MarkupLMTokenizerFast[[transformers.MarkupLMTokenizer]]
#### transformers.MarkupLMTokenizer[[transformers.MarkupLMTokenizer]]
```python
transformers.MarkupLMTokenizer(tags_dict, vocab: str | dict[str, int] | list[tuple[str, float]] | None = None, merges: str | list[str] | None = None, errors = 'replace', bos_token = '', eos_token = '', sep_token = '', cls_token = '', unk_token = '', pad_token = '', mask_token = '', add_prefix_space = False, max_depth = 50, max_width = 1000, pad_width = 1001, pad_token_label = -100, only_label_first_subword = True, trim_offsets = False, **kwargs)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L91)
**Parámetros:**
vocab (`str` o `dict[str, int]`, *opcional*) : Diccionario de vocabulario personalizado. Si no se proporciona, el vocabulario se carga desde `vocab_file`.
merges (`str` o `list[str]`, *opcional*) : Lista de fusiones personalizada. Si no se proporciona, las fusiones se cargan desde `merges_file`.
errors (`str`, *opcional*, valor predeterminado `"replace"`) : Paradigma a seguir al decodificar bytes a UTF-8. Consulte [bytes.decode](https://docs.python.org/3/library/stdtypes.html#bytes.decode) para obtener más información.
bos_token (`str`, *opcional*, valor predeterminado `""`) : El token de inicio de secuencia que se utilizó durante el preentrenamiento. Puede usarse como token de clasificador de secuencias. Al construir una secuencia con tokens especiales, este no es el token que se utiliza para el inicio de la secuencia. El token que se utiliza es `cls_token`.
eos_token (`str`, *opcional*, valor predeterminado `""`) : El token de fin de secuencia. Al construir una secuencia con tokens especiales, este no es el token que se utiliza para el fin de secuencia. El token que se utiliza es `sep_token`.
sep_token (`str`, *opcional*, valor predeterminado `""`) : El token separador, que se utiliza al construir una secuencia a partir de varias secuencias, por ejemplo, dos secuencias para la clasificación de secuencias o un texto y una pregunta para la respuesta a preguntas. También se utiliza como el último token de una secuencia construida con tokens especiales.
cls_token (`str`, *opcional*, valor predeterminado `""`) : El token clasificador que se utiliza al realizar clasificación de secuencias (clasificación de la secuencia completa en lugar de clasificación por token). Es el primer token de la secuencia cuando se construye con tokens especiales.
unk_token (`str`, *opcional*, valor predeterminado `""`) : El token desconocido. Un token que no está en el vocabulario no se puede convertir en un ID y se establece como este token en su lugar.
pad_token (`str`, *opcional*, valor predeterminado `""`) : El token utilizado para el relleno, por ejemplo, al agrupar secuencias de diferentes longitudes.
mask_token (`str`, *opcional*, valor predeterminado `""`) : El token utilizado para enmascarar valores. Este es el token que se emplea al entrenar este modelo con modelado de lenguaje enmascarado. Es el token que el modelo intentará predecir.
add_prefix_space (`bool`, *opcional*, valor predeterminado `False`) : Indica si se debe añadir un espacio inicial a la entrada. Esto permite tratar la palabra inicial igual que cualquier otra palabra. (El tokenizador de RoBERTa detecta el inicio de las palabras mediante el espacio que las precede).
Construye un tokenizador de MarkupLM. Basado en Byte-Pair-Encoding (BPE) a nivel de bytes.
[MarkupLMTokenizer](/docs/transformers/main/es/model_doc/markuplm#transformers.MarkupLMTokenizer) se puede utilizar para convertir cadenas HTML en `input_ids`, `attention_mask`, `token_type_ids`, `xpath_tags_seq` y `xpath_tags_seq` a nivel de token. Este tokenizador hereda de [TokenizersBackend](/docs/transformers/main/es/main_classes/tokenizer#transformers.TokenizersBackend), que contiene la mayoría de los métodos principales y garantiza que siempre se instancie un backend de `tokenizers`.
Los usuarios deben consultar esta superclase para obtener más información sobre esos métodos.
#### batch_encode_plus[[transformers.MarkupLMTokenizer.batch_encode_plus]]
```python
batch_encode_plus(batch_text_or_text_pairs: list[str] | list[tuple[str, str]] | list[list[str]], is_pair: bool | None = None, xpaths: list[list[list[int]]] | None = None, node_labels: list[int] | list[list[int]] | None = None, add_special_tokens: bool = True, padding: bool | str | transformers.utils.generic.PaddingStrategy = False, truncation: bool | str | transformers.tokenization_utils_base.TruncationStrategy | None = None, max_length: int | None = None, stride: int = 0, pad_to_multiple_of: int | None = None, padding_side: str | None = None, return_tensors: str | transformers.utils.generic.TensorType | None = None, return_token_type_ids: bool | None = None, return_attention_mask: bool | None = None, return_overflowing_tokens: bool = False, return_special_tokens_mask: bool = False, return_offsets_mapping: bool = False, return_length: bool = False, verbose: bool = True, **kwargs)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L453)
add_special_tokens (`bool`, *opcional*, valor predeterminado `True`): Indica si se deben o no añadir tokens especiales al codificar las secuencias. Esto utilizará la función subyacente `PretrainedTokenizerBase.build_inputs_with_special_tokens`, que define qué tokens se añaden automáticamente a los ids de entrada. Esto es útil si desea añadir automáticamente tokens `bos` o `eos`. padding (`bool`, `str` o [PaddingStrategy](/docs/transformers/main/es/internal/file_utils#transformers.utils.PaddingStrategy), *opcional*, valor predeterminado `False`): Activa y controla el relleno. Acepta los siguientes valores:
- `True` o `'longest'`: Rellena hasta la secuencia más larga del lote (o no aplica relleno si solo se proporciona una secuencia).
- `'max_length'`: Rellena hasta una longitud máxima especificada con el argumento `max_length` o hasta la longitud de entrada máxima aceptable para el modelo si no se proporciona dicho argumento.
- `False` o `'do_not_pad'` (predeterminado): Sin relleno (es decir, se puede generar un lote con secuencias de longitudes diferentes).
truncation (`bool`, `str` o [TruncationStrategy](/docs/transformers/main/es/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy), *opcional*, valor predeterminado `False`): Activa y controla la truncación. Acepta los siguientes valores:
- `True` o `'longest_first'`: Trunca hasta una longitud máxima especificada con el argumento `max_length` o hasta la longitud de entrada máxima aceptable para el modelo si no se proporciona dicho argumento. Esto truncará token por token, eliminando un token de la secuencia más larga de la pareja si se proporciona una pareja de secuencias (o un lote de parejas).
- `'only_first'`: Trunca hasta una longitud máxima especificada con el argumento `max_length` o hasta la longitud máxima de entrada aceptable para el modelo si no se proporciona dicho argumento. Esto solo truncará la primera secuencia de un par si se proporciona un par de secuencias (o un lote de pares).
- `'only_second'`: Trunca a una longitud máxima especificada con el argumento `max_length` o a la longitud de entrada máxima aceptable para el modelo si no se proporciona dicho argumento. Esto solo truncará la segunda secuencia de un par si se proporciona un par de secuencias (o un lote de pares).
- `False` o `'do_not_truncate'` (predeterminado): sin truncamiento (es decir, se puede generar un lote con longitudes de secuencia mayores que el tamaño máximo de entrada admisible del modelo).
max_length (`int`, *opcional*): Controla la longitud máxima que debe usar uno de los parámetros de truncamiento/relleno.
Si se deja sin establecer o se establece en `None`, se utilizará la longitud máxima predefinida del modelo si uno de los parámetros de truncamiento/relleno requiere una longitud máxima. Si el modelo no tiene una longitud de entrada máxima específica (como XLNet), el truncamiento/relleno a una longitud máxima se desactivará. stride (`int`, *opcional*, valor predeterminado 0): Si se establece en un número junto con `max_length`, los tokens en exceso devueltos cuando `return_overflowing_tokens=True` contendrán algunos tokens del final de la secuencia truncada devuelta para proporcionar cierta superposición entre las secuencias truncadas y las de exceso. El valor de este argumento define el número de tokens superpuestos. is_split_into_words (`bool`, *opcional*, valor predeterminado `False`): Indica si la entrada ya está pre-tokenizada (p. ej., dividida en palabras). Si se establece en `True`, el tokenizador asume que la entrada ya está dividida en palabras (por ejemplo, dividiéndola por espacios en blanco) y la tokenizará. Esto es útil para NER o clasificación de tokens. pad_to_multiple_of (`int`, *opcional*): Si se establece, rellenará la secuencia hasta un múltiplo del valor proporcionado. Requiere que `padding` esté activado. Esto es especialmente útil para habilitar el uso de Tensor Cores en hardware NVIDIA con capacidad de cálculo `>= 7.5` (Volta). padding_side (`str`, *opcional*): El lado en el que el modelo debe tener relleno aplicado. Debe seleccionarse entre ['right', 'left']. El valor predeterminado se elige del atributo de clase con el mismo nombre. return_tensors (`str` o [TensorType](/docs/transformers/main/es/internal/file_utils#transformers.TensorType), *opcional*): Si se establece, devolverá tensores en lugar de una lista de enteros de python. Los valores aceptables son:
- `'pt'`: Devuelve objetos `torch.Tensor` de PyTorch.
- `'np'`: Devuelve objetos Numpy `np.ndarray`.
add_special_tokens (`bool`, *opcional*, valor predeterminado `True`): Indica si se deben codificar las secuencias con los tokens especiales relativos a su modelo. padding (`bool`, `str` o [PaddingStrategy](/docs/transformers/main/es/internal/file_utils#transformers.utils.PaddingStrategy), *opcional*, valor predeterminado `False`): Activa y controla el relleno. Acepta los siguientes valores:
- `True` o `'longest'`: Rellena hasta la secuencia más larga del lote (o no aplica relleno si solo se proporciona una secuencia).
- `'max_length'`: Rellena hasta una longitud máxima especificada con el argumento `max_length` o hasta la longitud de entrada máxima aceptable para el modelo si no se proporciona dicho argumento.
- `False` o `'do_not_pad'` (predeterminado): Sin relleno (es decir, se puede generar un lote con secuencias de longitudes diferentes).
truncation (`bool`, `str` o [TruncationStrategy](/docs/transformers/main/es/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy), *opcional*, valor predeterminado `False`): Activa y controla la truncación. Acepta los siguientes valores:
- `True` o `'longest_first'`: Trunca hasta una longitud máxima especificada con el argumento `max_length` o hasta la longitud de entrada máxima aceptable para el modelo si no se proporciona dicho argumento. Esto truncará token por token, eliminando un token de la secuencia más larga de la pareja si se proporciona una pareja de secuencias (o un lote de parejas).
- `'only_first'`: Trunca hasta una longitud máxima especificada con el argumento `max_length` o hasta la longitud máxima de entrada aceptable para el modelo si no se proporciona dicho argumento. Esto solo truncará la primera secuencia de un par si se proporciona un par de secuencias (o un lote de pares).
- `'only_second'`: Trunca a una longitud máxima especificada con el argumento `max_length` o a la longitud de entrada máxima aceptable para el modelo si no se proporciona dicho argumento. Esto solo truncará la segunda secuencia de un par si se proporciona un par de secuencias (o un lote de pares).
- `False` o `'do_not_truncate'` (predeterminado): sin truncamiento (es decir, se puede generar un lote con longitudes de secuencia mayores que el tamaño máximo de entrada admisible del modelo).
max_length (`int`, *opcional*): Controla la longitud máxima que se utilizará mediante uno de los parámetros de truncamiento/relleno. Si se deja sin establecer o se establece en `None`, se utilizará la longitud máxima predefinida del modelo si uno de los parámetros de truncamiento/relleno requiere una longitud máxima. Si el modelo no tiene una longitud de entrada máxima específica (como XLNet), el truncamiento/relleno a una longitud máxima se desactivará. stride (`int`, *opcional*, valor predeterminado 0): Si se establece en un número junto con `max_length`, los tokens sobrantes devueltos cuando `return_overflowing_tokens=True` contendrán algunos tokens del final de la secuencia truncada devuelta para proporcionar cierta superposición entre las secuencias truncadas y las sobrantes. El valor de este argumento define el número de tokens superpuestos. is_split_into_words (`bool`, *opcional*, valor predeterminado `False`): Indica si la entrada ya está pretokenizada (p. ej., dividida en palabras). Establezca esto en `True` si está pasando entradas pretokenizadas para evitar una tokenización adicional. pad_to_multiple_of (`int`, *opcional*): Si se establece, rellenará la secuencia hasta un múltiplo del valor proporcionado. Esto es especialmente útil para habilitar el uso de Tensor Cores en hardware de NVIDIA con capacidad de cálculo `>= 7.5` (Volta). return_tensors (`str` o [TensorType](/docs/transformers/main/es/internal/file_utils#transformers.TensorType), *opcional*): Si se establece, devolverá tensores en lugar de listas de enteros de python. Los valores aceptables son:
- `'pt'`: Devuelve objetos `torch.Tensor` de PyTorch.
- `'np'`: Devuelve objetos Numpy `np.ndarray`.
#### build_inputs_with_special_tokens[[transformers.MarkupLMTokenizer.build_inputs_with_special_tokens]]
```python
build_inputs_with_special_tokens(token_ids_0: list, token_ids_1: list[int] | None = None)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L952)
**Parámetros:**
token_ids_0 (`list[int]`) : Lista de IDs a los que se les añadirán los tokens especiales.
token_ids_1 (`list[int]`, *opcional*) : Lista opcional de IDs para pares de secuencias.
**Devuelve:** `list[int]`
Lista de [ID de entrada](../glossary#input-ids) con los tokens especiales apropiados.
Construye las entradas del modelo a partir de una secuencia o un par de secuencias para tareas de clasificación de secuencias, concatenándolas y añadiendo tokens especiales. Una secuencia de RoBERTa tiene el siguiente formato:
- secuencia única: ` X `
- par de secuencias: ` A B `
#### create_token_type_ids_from_sequences[[transformers.MarkupLMTokenizer.create_token_type_ids_from_sequences]]
```python
create_token_type_ids_from_sequences(token_ids_0: list, token_ids_1: list[int] | None = None)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L975)
**Parámetros:**
token_ids_0 (`list[int]`) : Lista de IDs.
token_ids_1 (`list[int]`, *opcional*) : Lista opcional de IDs para pares de secuencias.
**Devuelve:** `list[int]`
Lista de ceros.
Crea una máscara a partir de las dos secuencias pasadas para su uso en una tarea de clasificación de pares de secuencias. RoBERTa no utiliza ids de tipo de token, por lo que se devuelve una lista de ceros.
#### encode_plus[[transformers.MarkupLMTokenizer.encode_plus]]
```python
encode_plus(text: str | list[str], text_pair: list[str] | None = None, xpaths: list[list[int]] | None = None, node_labels: list[int] | None = None, add_special_tokens: bool = True, padding: bool | str | transformers.utils.generic.PaddingStrategy = False, truncation: bool | str | transformers.tokenization_utils_base.TruncationStrategy | None = None, max_length: int | None = None, stride: int = 0, pad_to_multiple_of: int | None = None, padding_side: str | None = None, return_tensors: str | transformers.utils.generic.TensorType | None = None, return_token_type_ids: bool | None = None, return_attention_mask: bool | None = None, return_overflowing_tokens: bool = False, return_special_tokens_mask: bool = False, return_offsets_mapping: bool = False, return_length: bool = False, verbose: bool = True, **kwargs)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L518)
**Parámetros:**
text (`str`, `list[str]`, `list[list[str]]`) : La primera secuencia que se debe codificar. Puede ser una cadena, una lista de cadenas o una lista de listas de cadenas.
text_pair (`list[str]` o `list[int]`, *opcional*) : Secuencia secundaria opcional que se codificará. Puede ser una lista de cadenas (palabras de un solo ejemplo) o una lista de listas de cadenas (palabras de un lote de ejemplos).
add_special_tokens (`bool`, *opcional*, valor predeterminado `True`) : Indica si se deben o no añadir tokens especiales al codificar las secuencias. Esto utilizará la función subyacente `PretrainedTokenizerBase.build_inputs_with_special_tokens`, que define qué tokens se añaden automáticamente a los ids de entrada. Esto es útil si desea añadir automáticamente tokens `bos` o `eos`.
padding (`bool`, `str` o [PaddingStrategy](/docs/transformers/main/es/internal/file_utils#transformers.utils.PaddingStrategy), *opcional*, valor predeterminado `False`) : Activa y controla el relleno. Acepta los siguientes valores: - `True` o `'longest'`: Rellena hasta la secuencia más larga del lote (o no aplica relleno si solo se proporciona una secuencia). - `'max_length'`: Rellena hasta una longitud máxima especificada con el argumento `max_length` o hasta la longitud de entrada máxima aceptable para el modelo si no se proporciona dicho argumento. - `False` o `'do_not_pad'` (predeterminado): Sin relleno (es decir, puede generar un lote con secuencias de longitudes diferentes).
truncation (`bool`, `str` o [TruncationStrategy](/docs/transformers/main/es/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy), *opcional*, valor predeterminado `False`) : Activa y controla la truncación. Acepta los siguientes valores: - `True` o `'longest_first'`: Trunca hasta una longitud máxima especificada con el argumento `max_length` o hasta la longitud de entrada máxima aceptable para el modelo si no se proporciona dicho argumento. Esto truncará token por token, eliminando un token de la secuencia más larga de la pareja si se proporciona una pareja de secuencias (o un lote de parejas). - `'only_first'`: Trunca hasta una longitud máxima especificada con el argumento `max_length` o hasta la longitud de entrada máxima aceptable para el modelo si no se proporciona dicho argumento. Esto solo truncará la primera secuencia de una pareja si se proporciona una pareja de secuencias (o un lote de parejas). - `'only_second'`: Trunca hasta una longitud máxima especificada con el argumento `max_length` o hasta la longitud de entrada máxima aceptable para el modelo si no se proporciona dicho argumento. Esto solo truncará la segunda secuencia de una pareja si se proporciona una pareja de secuencias (o un lote de parejas). - `False` o `'do_not_truncate'` (predeterminado): Sin truncación (es decir, puede generar un lote con longitudes de secuencia mayores que el tamaño máximo de entrada admisible del modelo).
max_length (`int`, *opcional*) : Controla la longitud máxima que debe usar uno de los parámetros de truncamiento/relleno. Si se deja sin establecer o se establece en `None`, se usará la longitud máxima predefinida del modelo si uno de los parámetros de truncamiento/relleno requiere una longitud máxima. Si el modelo no tiene una longitud de entrada máxima específica (como XLNet), el truncamiento/relleno a una longitud máxima se desactivará.
stride (`int`, *opcional*, valor predeterminado 0) : Si se establece en un número junto con `max_length`, los tokens en exceso devueltos cuando `return_overflowing_tokens=True` contendrán algunos tokens del final de la secuencia truncada devuelta para proporcionar cierta superposición entre las secuencias truncadas y las de exceso. El valor de este argumento define el número de tokens superpuestos.
is_split_into_words (`bool`, *opcional*, valor predeterminado `False`) : Indica si la entrada ya está pretokenizada (por ejemplo, dividida en palabras). Si se establece en `True`, el tokenizador asume que la entrada ya está dividida en palabras (por ejemplo, dividiéndola por espacios en blanco) y procederá a tokenizarla. Esto es útil para NER o clasificación de tokens.
pad_to_multiple_of (`int`, *opcional*) : Si se establece, rellenará la secuencia hasta un múltiplo del valor proporcionado. Requiere que `padding` esté activado. Esto es especialmente útil para habilitar el uso de Tensor Cores en hardware de NVIDIA con capacidad de cálculo `>= 7.5` (Volta).
padding_side (`str`, *opcional*) : El lado en el que el modelo debe aplicar el relleno. Debe seleccionarse entre ['right', 'left']. El valor predeterminado se toma del atributo de la clase con el mismo nombre.
return_tensors (`str` o [TensorType](/docs/transformers/main/es/internal/file_utils#transformers.TensorType), *opcional*) : Si se establece, devolverá tensores en lugar de listas de enteros de Python. Los valores aceptables son: - `'pt'`: Devuelve objetos `torch.Tensor` de PyTorch. - `'np'`: Devuelve objetos `np.ndarray` de Numpy.
add_special_tokens (`bool`, *opcional*, valor predeterminado `True`) : Indica si se deben codificar las secuencias con los tokens especiales relativos a su modelo.
padding (`bool`, `str` o [PaddingStrategy](/docs/transformers/main/es/internal/file_utils#transformers.utils.PaddingStrategy), *opcional*, valor predeterminado `False`) : Activa y controla el relleno. Acepta los siguientes valores: - `True` o `'longest'`: Rellena hasta la secuencia más larga del lote (o no aplica relleno si solo se proporciona una secuencia). - `'max_length'`: Rellena hasta una longitud máxima especificada con el argumento `max_length` o hasta la longitud de entrada máxima aceptable para el modelo si no se proporciona dicho argumento. - `False` o `'do_not_pad'` (predeterminado): Sin relleno (es decir, puede generar un lote con secuencias de longitudes diferentes).
truncation (`bool`, `str` o [TruncationStrategy](/docs/transformers/main/es/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy), *opcional*, valor predeterminado `False`) : Activa y controla la truncación. Acepta los siguientes valores: - `True` o `'longest_first'`: Trunca hasta una longitud máxima especificada con el argumento `max_length` o hasta la longitud de entrada máxima aceptable para el modelo si no se proporciona dicho argumento. Esto truncará token por token, eliminando un token de la secuencia más larga de la pareja si se proporciona una pareja de secuencias (o un lote de parejas). - `'only_first'`: Trunca hasta una longitud máxima especificada con el argumento `max_length` o hasta la longitud de entrada máxima aceptable para el modelo si no se proporciona dicho argumento. Esto solo truncará la primera secuencia de una pareja si se proporciona una pareja de secuencias (o un lote de parejas). - `'only_second'`: Trunca hasta una longitud máxima especificada con el argumento `max_length` o hasta la longitud de entrada máxima aceptable para el modelo si no se proporciona dicho argumento. Esto solo truncará la segunda secuencia de una pareja si se proporciona una pareja de secuencias (o un lote de parejas). - `False` o `'do_not_truncate'` (predeterminado): Sin truncación (es decir, puede generar un lote con longitudes de secuencia mayores que el tamaño máximo de entrada admisible del modelo).
max_length (`int`, *opcional*) : Controla la longitud máxima que debe usar uno de los parámetros de truncamiento/relleno. Si se deja sin establecer o se establece en `None`, se usará la longitud máxima predefinida del modelo si uno de los parámetros de truncamiento/relleno requiere una longitud máxima. Si el modelo no tiene una longitud de entrada máxima específica (como XLNet), el truncamiento/relleno a una longitud máxima se desactivará.
stride (`int`, *opcional*, valor predeterminado 0) : Si se establece en un número junto con `max_length`, los tokens en exceso devueltos cuando `return_overflowing_tokens=True` contendrán algunos tokens del final de la secuencia truncada devuelta para proporcionar cierta superposición entre las secuencias truncadas y las de exceso. El valor de este argumento define el número de tokens superpuestos.
is_split_into_words (`bool`, *opcional*, valor predeterminado `False`) : Indica si la entrada ya está pretokenizada (p. ej., dividida en palabras). Establezca este valor en `True` si está pasando entradas pretokenizadas para evitar una tokenización adicional.
pad_to_multiple_of (`int`, *opcional*) : Si se establece, rellenará la secuencia hasta un múltiplo del valor proporcionado. Esto resulta especialmente útil para habilitar el uso de Tensor Cores en hardware de NVIDIA con capacidad de cálculo `>= 7.5` (Volta).
return_tensors (`str` o [TensorType](/docs/transformers/main/es/internal/file_utils#transformers.TensorType), *opcional*) : Si se establece, devolverá tensores en lugar de listas de enteros de Python. Los valores aceptables son: - `'pt'`: Devuelve objetos `torch.Tensor` de PyTorch. - `'np'`: Devuelve objetos `np.ndarray` de Numpy.
Tokeniza y prepara para el modelo una secuencia o un par de secuencias. .. warning:: Este método está obsoleto, se debe usar `__call__` en su lugar.
#### get_xpath_seq[[transformers.MarkupLMTokenizer.get_xpath_seq]]
```python
get_xpath_seq(xpath)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L253)
Dada la expresión xpath de un nodo particular (como "/html/body/div/li[1]/div/span[2]"), devuelve una lista de IDs de etiquetas y los subíndices correspondientes, teniendo en cuenta la profundidad máxima.
## MarkupLMProcessor[[transformers.MarkupLMProcessor]]
#### transformers.MarkupLMProcessor[[transformers.MarkupLMProcessor]]
```python
transformers.MarkupLMProcessor(feature_extractor, tokenizer)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/processing_markuplm.py#L25)
**Parámetros:**
feature_extractor (`feature_extractor_class`) : El extractor de características es una entrada obligatoria.
tokenizer (`MarkupLMTokenizer`) : El tokenizador es una entrada obligatoria.
Construye un MarkupLMProcessor que envuelve un extractor de características y un tokenizador en un único procesador.
[MarkupLMProcessor](/docs/transformers/main/es/model_doc/markuplm#transformers.MarkupLMProcessor) ofrece todas las funcionalidades de `feature_extractor_class` y [MarkupLMTokenizer](/docs/transformers/main/es/model_doc/markuplm#transformers.MarkupLMTokenizer). Consulte `~feature_extractor_class` y [~MarkupLMTokenizer](/docs/transformers/main/es/model_doc/markuplm#transformers.MarkupLMTokenizer) para obtener más información.
#### __llamada__[[transformers.MarkupLMProcessor.__call__]]
```python
__call__(html_strings = None, nodes = None, xpaths = None, node_labels = None, questions = None, add_special_tokens: bool = True, padding: bool | str | transformers.utils.generic.PaddingStrategy = False, truncation: bool | str | transformers.tokenization_utils_base.TruncationStrategy = None, max_length: int | None = None, stride: int = 0, pad_to_multiple_of: int | None = None, return_token_type_ids: bool | None = None, return_attention_mask: bool | None = None, return_overflowing_tokens: bool = False, return_special_tokens_mask: bool = False, return_offsets_mapping: bool = False, return_length: bool = False, verbose: bool = True, return_tensors: str | transformers.utils.generic.TensorType | None = None, **kwargs)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/processing_markuplm.py#L31)
**Parámetros:**
html_strings (`str` o `list[str]`, *opcional*) : Cadenas HTML sin procesar para analizar y procesar. Cuando `parse_html=True` (valor predeterminado), estas cadenas se analizan para extraer automáticamente nodos y xpaths. Si se proporcionan, no deben proporcionarse `nodes`, `xpaths` ni `node_labels`. Obligatorio cuando `parse_html=True`.
nodes (`list[list[str]]`, *opcional*) : Nodos HTML preextraídos como una lista de listas, donde cada lista interna contiene el contenido de texto de los nodos de un solo documento. Es obligatorio cuando `parse_html=False`. No debe proporcionarse cuando `parse_html=True`.
xpaths (`list[list[str]]`, *opcional*) : Expresiones XPath preextraídas correspondientes a los nodos. Debe ser una lista de listas con la misma estructura que `nodes`, donde cada XPath identifica la ubicación del nodo correspondiente en el árbol HTML. Obligatorio cuando `parse_html=False`. No debe proporcionarse cuando `parse_html=True`.
node_labels (`list[list[int]]`, *opcional*) : Etiquetas para los nodos, generalmente utilizadas para tareas de entrenamiento o ajuste fino. Debe ser una lista de listas con la misma estructura que `nodes`, donde cada etiqueta corresponde a un nodo. Opcional y solo se utiliza cuando `parse_html=False`.
questions (`str` o `list[str]`, *opcional*) : Cadenas de preguntas para tareas de respuesta a preguntas. Cuando se proporciona, el tokenizador procesa las preguntas como la primera secuencia y los nodos como la segunda secuencia (text_pair). Si se proporciona una sola cadena, se convierte en una lista para coincidir con la dimensión del lote del HTML analizado.
add_special_tokens (`bool`, *opcional*, valor predeterminado `True`) : Indica si se deben o no añadir tokens especiales al codificar las secuencias. Esto utilizará la función subyacente `PretrainedTokenizerBase.build_inputs_with_special_tokens`, que define qué tokens se añaden automáticamente a los ids de entrada. Esto es útil si desea añadir automáticamente tokens `bos` o `eos`.
padding (bool, str o [PaddingStrategy](/docs/transformers/main/es/internal/file_utils#transformers.utils.PaddingStrategy), *opcional*, valor predeterminado `False`) : Activa y controla el relleno. Acepta los siguientes valores: - `True` o `'longest'`: Rellena hasta la secuencia más larga del lote (o no aplica relleno si solo se proporciona una secuencia). - `'max_length'`: Rellena hasta una longitud máxima especificada con el argumento `max_length` o hasta la longitud de entrada máxima aceptable para el modelo si no se proporciona dicho argumento. - `False` o `'do_not_pad'` (predeterminado): Sin relleno (es decir, puede generar un lote con secuencias de longitudes diferentes).
truncation (bool, str o [TruncationStrategy](/docs/transformers/main/es/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy), *opcional*) : Activa y controla la truncación. Acepta los siguientes valores: - `True` o `'longest_first'`: Trunca hasta una longitud máxima especificada con el argumento `max_length` o hasta la longitud de entrada máxima aceptable para el modelo si no se proporciona dicho argumento. Esto truncará token a token, eliminando un token de la secuencia más larga de la pareja si se proporciona una pareja de secuencias (o un lote de parejas). - `'only_first'`: Trunca hasta una longitud máxima especificada con el argumento `max_length` o hasta la longitud de entrada máxima aceptable para el modelo si no se proporciona dicho argumento. Esto solo truncará la primera secuencia de una pareja si se proporciona una pareja de secuencias (o un lote de parejas). - `'only_second'`: Trunca hasta una longitud máxima especificada con el argumento `max_length` o hasta la longitud de entrada máxima aceptable para el modelo si no se proporciona dicho argumento. Esto solo truncará la segunda secuencia de una pareja si se proporciona una pareja de secuencias (o un lote de parejas). - `False` o `'do_not_truncate'` (predeterminado): Sin truncación (es decir, puede generar un lote con longitudes de secuencia mayores que el tamaño de entrada máximo admisible del modelo).
max_length (`int`, *opcional*) : Controla la longitud máxima que debe usar uno de los parámetros de truncamiento/relleno. Si se deja sin establecer o se establece en `None`, se usará la longitud máxima predefinida del modelo si uno de los parámetros de truncamiento/relleno requiere una longitud máxima. Si el modelo no tiene una longitud de entrada máxima específica (como XLNet), el truncamiento/relleno a una longitud máxima se desactivará.
stride (`int`, *opcional*, valor predeterminado `0`) : Si se establece en un número junto con `max_length`, los tokens en exceso devueltos cuando `return_overflowing_tokens=True` contendrán algunos tokens del final de la secuencia truncada devuelta para proporcionar cierta superposición entre las secuencias truncadas y las de exceso. El valor de este argumento define el número de tokens superpuestos.
pad_to_multiple_of (`int`, *opcional*) : Si se establece, rellenará la secuencia hasta un múltiplo del valor proporcionado. Requiere que `padding` esté activado. Esto es especialmente útil para habilitar el uso de Tensor Cores en hardware de NVIDIA con capacidad de cálculo `>= 7.5` (Volta).
return_token_type_ids (`bool`, *opcional*) : Indica si se deben devolver los IDs de tipo de token. Si se deja en el valor predeterminado, se devolverán los IDs de tipo de token según el valor predeterminado del tokenizador específico, definido por el atributo `return_outputs`. [¿Qué son los IDs de tipo de token?](../glossary#token-type-ids)
return_attention_mask (`bool`, *opcional*) : Indica si se debe devolver la máscara de atención. Si se deja en el valor predeterminado, se devolverá la máscara de atención según el valor predeterminado del tokenizador específico, definido por el atributo `return_outputs`. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
return_overflowing_tokens (`bool`, *opcional*, valor predeterminado `False`) : Indica si se deben devolver o no las secuencias de tokens que desbordan. Si se proporciona un par de secuencias de ids de entrada (o un lote de pares) con `truncation_strategy = longest_first` o `True`, se genera un error en lugar de devolver los tokens que desbordan.
return_special_tokens_mask (`bool`, *opcional*, valor predeterminado `False`) : Indica si se debe o no devolver información de la máscara de tokens especiales.
return_offsets_mapping (`bool`, *opcional*, valor predeterminado `False`) : Indica si se debe devolver `(char_start, char_end)` para cada token. Esto solo está disponible en tokenizadores rápidos que heredan de [PreTrainedTokenizerFast](/docs/transformers/main/es/main_classes/tokenizer#transformers.TokenizersBackend); si se utiliza el tokenizador de Python, este método lanzará `NotImplementedError`.
return_length (`bool`, *opcional*, valor predeterminado `False`) : Indica si se deben devolver o no las longitudes de las entradas codificadas.
verbose (`bool`, *opcional*, valor predeterminado `True`) : Indica si se debe imprimir más información y advertencias.
return_tensors (`Union[str, ~utils.generic.TensorType]`, *opcional*) : Si se establece, devolverá tensores de un marco de trabajo específico. Los valores aceptables son: - `'pt'`: Devuelve objetos `torch.Tensor` de PyTorch. - `'np'`: Devuelve objetos `np.ndarray` de NumPy.
**Devuelve:** `~tokenization_utils_base.BatchEncoding`
- **data** (`dict`, *opcional*) -- Diccionario de listas/arrays/tensores devueltos por los métodos `__call__`/`encode_plus`/`batch_encode_plus` ('input_ids', 'attention_mask', etc.).
- **encoding** (`tokenizers.Encoding` o `Sequence[tokenizers.Encoding]`, *opcional*) -- Si el tokenizador es un tokenizador rápido que genera información adicional, como el mapeo del espacio de palabras/caracteres al espacio de tokens, la instancia de `tokenizers.Encoding` o la lista de instancias (para lotes) contiene esta información.
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Puede especificar un tensor_type aquí para convertir las listas de enteros en Tensors de PyTorch/Numpy durante la inicialización.
- **prepend_batch_axis** (`bool`, *opcional*, valor predeterminado `False`) -- Indica si se debe añadir un eje de lote al convertir a tensores (consulte `tensor_type` arriba). Tenga en cuenta que este parámetro tiene efecto si el parámetro `tensor_type` está establecido, *en caso contrario no tiene efecto*.
- **n_sequences** (`int`, *opcional*) -- El número de secuencias de entrada representadas por cada codificación (`None` para desconocido, `1` para una secuencia única y `2` para un par de secuencias).
## MarkupLMModel[[transformers.MarkupLMModel]]
#### transformers.MarkupLMModel[[transformers.MarkupLMModel]]
```python
transformers.MarkupLMModel(config: MarkupLMConfig, add_pooling_layer = True)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L497)
**Parámetros:**
config ([MarkupLMConfig](/docs/transformers/main/es/model_doc/markuplm#transformers.MarkupLMConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/main/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
add_pooling_layer (`bool`, *opcional*, valor predeterminado `True`) : Si se debe añadir una capa de pooling
El modelo base Markuplm que emite estados ocultos sin ninguna cabeza específica en la parte superior.
Este modelo hereda de [PreTrainedModel](/docs/transformers/main/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.MarkupLMModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, xpath_tags_seq: typing.Optional[torch.LongTensor] = None, xpath_subs_seq: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L521)
**Parámetros:**
input_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de los tokens de la secuencia de entrada en el vocabulario. El relleno se ignorará de forma predeterminada. Los índices se pueden obtener mediante [AutoTokenizer](/docs/transformers/main/es/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) y [PreTrainedTokenizer.__call__()](/docs/transformers/main/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para obtener más detalles. [¿Qué son los IDs de entrada?](../glossary#input-ids)
xpath_tags_seq (`torch.LongTensor` de forma `(batch_size, sequence_length, config.max_depth)`, *opcional*) : IDs de etiquetas para cada token en la secuencia de entrada, rellenos hasta config.max_depth.
xpath_subs_seq (`torch.LongTensor` de forma `(batch_size, sequence_length, config.max_depth)`, *opcional*) : IDs de subíndice para cada token en la secuencia de entrada, rellenos hasta config.max_depth.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar las primeras y segundas partes de las entradas. Los índices se seleccionan en `[0, 1]`: - 0 corresponde a un token de *oración A*, - 1 corresponde a un token de *oración B*. [¿Qué son los IDs de tipo de token?](../glossary#token-type-ids)
position_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de las posiciones de los tokens de cada secuencia de entrada en las incrustaciones de posición. Seleccionados en el rango `[0, config.n_positions - 1]`. [¿Qué son los IDs de posición?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, en lugar de pasar `input_ids`, puedes elegir pasar directamente una representación incrustada. Esto es útil si deseas tener más control sobre cómo convertir los índices de `input_ids` en los vectores asociados que en la matriz de búsqueda de incrustaciones interna del modelo.
**Devuelve:** [BaseModelOutputWithPooling](/docs/transformers/main/es/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) o `tuple(torch.Tensor)`
Un [BaseModelOutputWithPooling](/docs/transformers/main/es/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([MarkupLMConfig](/docs/transformers/main/es/model_doc/markuplm#transformers.MarkupLMConfig)) y las entradas.
El método forward de [MarkupLMModel](/docs/transformers/main/es/model_doc/markuplm#transformers.MarkupLMModel) sobrescribe el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Secuencia de estados ocultos en la salida de la última capa del modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto de la última capa del primer token de la secuencia (token de clasificación) después de un procesamiento adicional a través de las capas utilizadas para la tarea de preentrenamiento auxiliar. Por ejemplo, para la familia de modelos BERT, esto devuelve el token de clasificación después de procesarlo a través de una capa lineal y una función de activación tanh. Los pesos de la capa lineal se entrenan a partir del objetivo de predicción de la siguiente oración (clasificación) durante el preentrenamiento.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
Ejemplos:
```python
>>> from transformers import AutoProcessor, MarkupLMModel
>>> processor = AutoProcessor.from_pretrained("microsoft/markuplm-base")
>>> model = MarkupLMModel.from_pretrained("microsoft/markuplm-base")
>>> html_string = " Page Title "
>>> encoding = processor(html_string, return_tensors="pt")
>>> outputs = model(**encoding)
>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 4, 768]
```
## MarkupLMForSequenceClassification[[transformers.MarkupLMForSequenceClassification]]
#### transformers.MarkupLMForSequenceClassification[[transformers.MarkupLMForSequenceClassification]]
```python
transformers.MarkupLMForSequenceClassification(config: MarkupLMConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L802)
**Parámetros:**
config ([MarkupLMConfig](/docs/transformers/main/es/model_doc/markuplm#transformers.MarkupLMConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/main/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
Modelo MarkupLM con una cabeza de clasificación/regresión de secuencias en la parte superior (una capa lineal sobre la salida agrupada), por ejemplo, para tareas de GLUE.
Este modelo hereda de [PreTrainedModel](/docs/transformers/main/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.MarkupLMForSequenceClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, xpath_tags_seq: typing.Optional[torch.Tensor] = None, xpath_subs_seq: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L819)
**Parámetros:**
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de los tokens de la secuencia de entrada en el vocabulario. El relleno se ignorará de forma predeterminada. Los índices se pueden obtener mediante [AutoTokenizer](/docs/transformers/main/es/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) y [PreTrainedTokenizer.__call__()](/docs/transformers/main/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para obtener más detalles. [¿Qué son los IDs de entrada?](../glossary#input-ids)
xpath_tags_seq (`torch.LongTensor` de forma `(batch_size, sequence_length, config.max_depth)`, *opcional*) : IDs de etiquetas para cada token en la secuencia de entrada, rellenos hasta config.max_depth.
xpath_subs_seq (`torch.LongTensor` de forma `(batch_size, sequence_length, config.max_depth)`, *opcional*) : IDs de subíndice para cada token en la secuencia de entrada, rellenos hasta config.max_depth.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar las primeras y segundas partes de las entradas. Los índices se seleccionan en `[0, 1]`: - 0 corresponde a un token de *oración A*, - 1 corresponde a un token de *oración B*. [¿Qué son los IDs de tipo de token?](../glossary#token-type-ids)
position_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de las posiciones de los tokens de cada secuencia de entrada en las incrustaciones de posición. Seleccionados en el rango `[0, config.n_positions - 1]`. [¿Qué son los IDs de posición?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, en lugar de pasar `input_ids`, puedes elegir pasar directamente una representación incrustada. Esto es útil si deseas tener más control sobre cómo convertir los índices de `input_ids` en los vectores asociados que en la matriz de búsqueda de incrustaciones interna del modelo.
labels (`torch.LongTensor` de forma `(batch_size,)`, *opcional*) : Etiquetas para calcular la pérdida de clasificación/regresión de secuencia. Los índices deben estar en `[0, ..., config.num_labels - 1]`. Si `config.num_labels == 1` se calcula una pérdida de regresión (pérdida de error cuadrático medio), si `config.num_labels > 1` se calcula una pérdida de clasificación (entropía cruzada).
**Devuelve:** [SequenceClassifierOutput](/docs/transformers/main/es/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) o `tuple(torch.Tensor)`
Un [SequenceClassifierOutput](/docs/transformers/main/es/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([MarkupLMConfig](/docs/transformers/main/es/model_doc/markuplm#transformers.MarkupLMConfig)) y las entradas.
El método forward de [MarkupLMForSequenceClassification](/docs/transformers/main/es/model_doc/markuplm#transformers.MarkupLMForSequenceClassification) sobrescribe el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, se devuelve cuando se proporciona `labels`) -- Pérdida de clasificación (o de regresión si config.num_labels==1).
- **logits** (`torch.Tensor` de forma `(batch_size, config.num_labels)`) -- Puntuaciones de clasificación (o de regresión si config.num_labels==1) (antes de SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
Ejemplos:
```python
>>> from transformers import AutoProcessor, AutoModelForSequenceClassification
>>> import torch
>>> processor = AutoProcessor.from_pretrained("microsoft/markuplm-base")
>>> model = AutoModelForSequenceClassification.from_pretrained("microsoft/markuplm-base", num_labels=7)
>>> html_string = " Page Title "
>>> encoding = processor(html_string, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model(**encoding)
>>> loss = outputs.loss
>>> logits = outputs.logits
```
## MarkupLMForTokenClassification[[transformers.MarkupLMForTokenClassification]]
#### transformers.MarkupLMForTokenClassification[[transformers.MarkupLMForTokenClassification]]
```python
transformers.MarkupLMForTokenClassification(config: MarkupLMConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L709)
**Parámetros:**
config ([MarkupLMConfig](/docs/transformers/main/es/model_doc/markuplm#transformers.MarkupLMConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/main/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
Modelo MarkupLM con una cabeza `token_classification` en la parte superior.
Este modelo hereda de [PreTrainedModel](/docs/transformers/main/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.MarkupLMForTokenClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, xpath_tags_seq: typing.Optional[torch.Tensor] = None, xpath_subs_seq: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L725)
**Parámetros:**
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de los tokens de la secuencia de entrada en el vocabulario. El relleno se ignorará de forma predeterminada. Los índices se pueden obtener mediante [AutoTokenizer](/docs/transformers/main/es/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) y [PreTrainedTokenizer.__call__()](/docs/transformers/main/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para obtener más detalles. [¿Qué son los IDs de entrada?](../glossary#input-ids)
xpath_tags_seq (`torch.LongTensor` de forma `(batch_size, sequence_length, config.max_depth)`, *opcional*) : IDs de etiquetas para cada token en la secuencia de entrada, rellenos hasta config.max_depth.
xpath_subs_seq (`torch.LongTensor` de forma `(batch_size, sequence_length, config.max_depth)`, *opcional*) : IDs de subíndice para cada token en la secuencia de entrada, rellenos hasta config.max_depth.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar las primeras y segundas partes de las entradas. Los índices se seleccionan en `[0, 1]`: - 0 corresponde a un token de *oración A*, - 1 corresponde a un token de *oración B*. [¿Qué son los IDs de tipo de token?](../glossary#token-type-ids)
position_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de las posiciones de los tokens de cada secuencia de entrada en las incrustaciones de posición. Seleccionados en el rango `[0, config.n_positions - 1]`. [¿Qué son los IDs de posición?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, en lugar de pasar `input_ids`, puedes elegir pasar directamente una representación incrustada. Esto es útil si deseas tener más control sobre cómo convertir los índices de `input_ids` en los vectores asociados que en la matriz de búsqueda de incrustaciones interna del modelo.
labels (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Etiquetas para calcular la pérdida de clasificación de tokens. Los índices deben estar en `[0, ..., config.num_labels - 1]`.
**Devuelve:** [MaskedLMOutput](/docs/transformers/main/es/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) o `tuple(torch.Tensor)`
Un [MaskedLMOutput](/docs/transformers/main/es/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([MarkupLMConfig](/docs/transformers/main/es/model_doc/markuplm#transformers.MarkupLMConfig)) y las entradas.
El método forward de [MarkupLMForTokenClassification](/docs/transformers/main/es/model_doc/markuplm#transformers.MarkupLMForTokenClassification) sobrescribe el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, se devuelve cuando se proporciona `labels`) -- Pérdida de modelado de lenguaje enmascarado (MLM).
- **logits** (`torch.Tensor` de forma `(batch_size, sequence_length, config.vocab_size)`) -- Puntuaciones de predicción de la cabeza de modelado de lenguaje (puntuaciones para cada token del vocabulario antes de SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
Ejemplos:
```python
>>> from transformers import AutoProcessor, AutoModelForTokenClassification
>>> import torch
>>> processor = AutoProcessor.from_pretrained("microsoft/markuplm-base")
>>> processor.parse_html = False
>>> model = AutoModelForTokenClassification.from_pretrained("microsoft/markuplm-base", num_labels=7)
>>> nodes = ["hello", "world"]
>>> xpaths = ["/html/body/div/li[1]/div/span", "/html/body/div/li[1]/div/span"]
>>> node_labels = [1, 2]
>>> encoding = processor(nodes=nodes, xpaths=xpaths, node_labels=node_labels, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model(**encoding)
>>> loss = outputs.loss
>>> logits = outputs.logits
```
## MarkupLMForQuestionAnswering[[transformers.MarkupLMForQuestionAnswering]]
#### transformers.MarkupLMForQuestionAnswering[[transformers.MarkupLMForQuestionAnswering]]
```python
transformers.MarkupLMForQuestionAnswering(config: MarkupLMConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L603)
**Parámetros:**
config ([MarkupLMConfig](/docs/transformers/main/es/model_doc/markuplm#transformers.MarkupLMConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/main/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
El transformador Markuplm con una cabeza de clasificación de tramos en la parte superior para tareas de respuesta a preguntas extractivas como SQuAD (una capa lineal sobre la salida de los estados ocultos para calcular `span start logits` y `span end logits`).
Este modelo hereda de [PreTrainedModel](/docs/transformers/main/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.MarkupLMForQuestionAnswering.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, xpath_tags_seq: typing.Optional[torch.Tensor] = None, xpath_subs_seq: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, start_positions: typing.Optional[torch.Tensor] = None, end_positions: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L615)
**Parámetros:**
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de los tokens de la secuencia de entrada en el vocabulario. El relleno se ignorará de forma predeterminada. Los índices se pueden obtener mediante [AutoTokenizer](/docs/transformers/main/es/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) y [PreTrainedTokenizer.__call__()](/docs/transformers/main/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para obtener más detalles. [¿Qué son los IDs de entrada?](../glossary#input-ids)
xpath_tags_seq (`torch.LongTensor` de forma `(batch_size, sequence_length, config.max_depth)`, *opcional*) : IDs de etiquetas para cada token en la secuencia de entrada, rellenos hasta config.max_depth.
xpath_subs_seq (`torch.LongTensor` de forma `(batch_size, sequence_length, config.max_depth)`, *opcional*) : IDs de subíndice para cada token en la secuencia de entrada, rellenos hasta config.max_depth.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar las primeras y segundas partes de las entradas. Los índices se seleccionan en `[0, 1]`: - 0 corresponde a un token de *oración A*, - 1 corresponde a un token de *oración B*. [¿Qué son los IDs de tipo de token?](../glossary#token-type-ids)
position_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de las posiciones de los tokens de cada secuencia de entrada en las incrustaciones de posición. Seleccionados en el rango `[0, config.n_positions - 1]`. [¿Qué son los IDs de posición?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, en lugar de pasar `input_ids`, puedes elegir pasar directamente una representación incrustada. Esto es útil si deseas tener más control sobre cómo convertir los índices de `input_ids` en los vectores asociados que en la matriz de búsqueda de incrustaciones interna del modelo.
start_positions (`torch.Tensor` de forma `(batch_size,)`, *opcional*) : Etiquetas para la posición (índice) del inicio del tramo etiquetado para calcular la pérdida de clasificación de tokens. Las posiciones se limitan a la longitud de la secuencia (`sequence_length`). Las posiciones fuera de la secuencia no se tienen en cuenta para calcular la pérdida.
end_positions (`torch.Tensor` de forma `(batch_size,)`, *opcional*) : Etiquetas para la posición (índice) del final del tramo etiquetado para calcular la pérdida de clasificación de tokens. Las posiciones se limitan a la longitud de la secuencia (`sequence_length`). Las posiciones fuera de la secuencia no se tienen en cuenta para calcular la pérdida.
**Devuelve:** [QuestionAnsweringModelOutput](/docs/transformers/main/es/main_classes/output#transformers.modeling_outputs.QuestionAnsweringModelOutput) o `tuple(torch.Tensor)`
Un [QuestionAnsweringModelOutput](/docs/transformers/main/es/main_classes/output#transformers.modeling_outputs.QuestionAnsweringModelOutput) o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([MarkupLMConfig](/docs/transformers/main/es/model_doc/markuplm#transformers.MarkupLMConfig)) y las entradas.
El método forward de [MarkupLMForQuestionAnswering](/docs/transformers/main/es/model_doc/markuplm#transformers.MarkupLMForQuestionAnswering) sobrescribe el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, se devuelve cuando se proporciona `labels`) -- La pérdida total de extracción de tramos es la suma de una Entropía Cruzada para las posiciones de inicio y fin.
- **start_logits** (`torch.Tensor` de forma `(batch_size, sequence_length)`) -- Puntuaciones de inicio de tramo (antes de SoftMax).
- **end_logits** (`torch.Tensor` de forma `(batch_size, sequence_length)`) -- Puntuaciones de fin de tramo (antes de SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
Ejemplos:
```python
>>> from transformers import AutoProcessor, MarkupLMForQuestionAnswering
>>> import torch
>>> processor = AutoProcessor.from_pretrained("microsoft/markuplm-base-finetuned-websrc")
>>> model = MarkupLMForQuestionAnswering.from_pretrained("microsoft/markuplm-base-finetuned-websrc")
>>> html_string = " My name is Niels "
>>> question = "What's his name?"
>>> encoding = processor(html_string, questions=question, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model(**encoding)
>>> answer_start_index = outputs.start_logits.argmax()
>>> answer_end_index = outputs.end_logits.argmax()
>>> predict_answer_tokens = encoding.input_ids[0, answer_start_index : answer_end_index + 1]
>>> processor.decode(predict_answer_tokens).strip()
'Niels'
```